SEO决策为何老踩坑?一套靠得住的5大指标+第一周实操
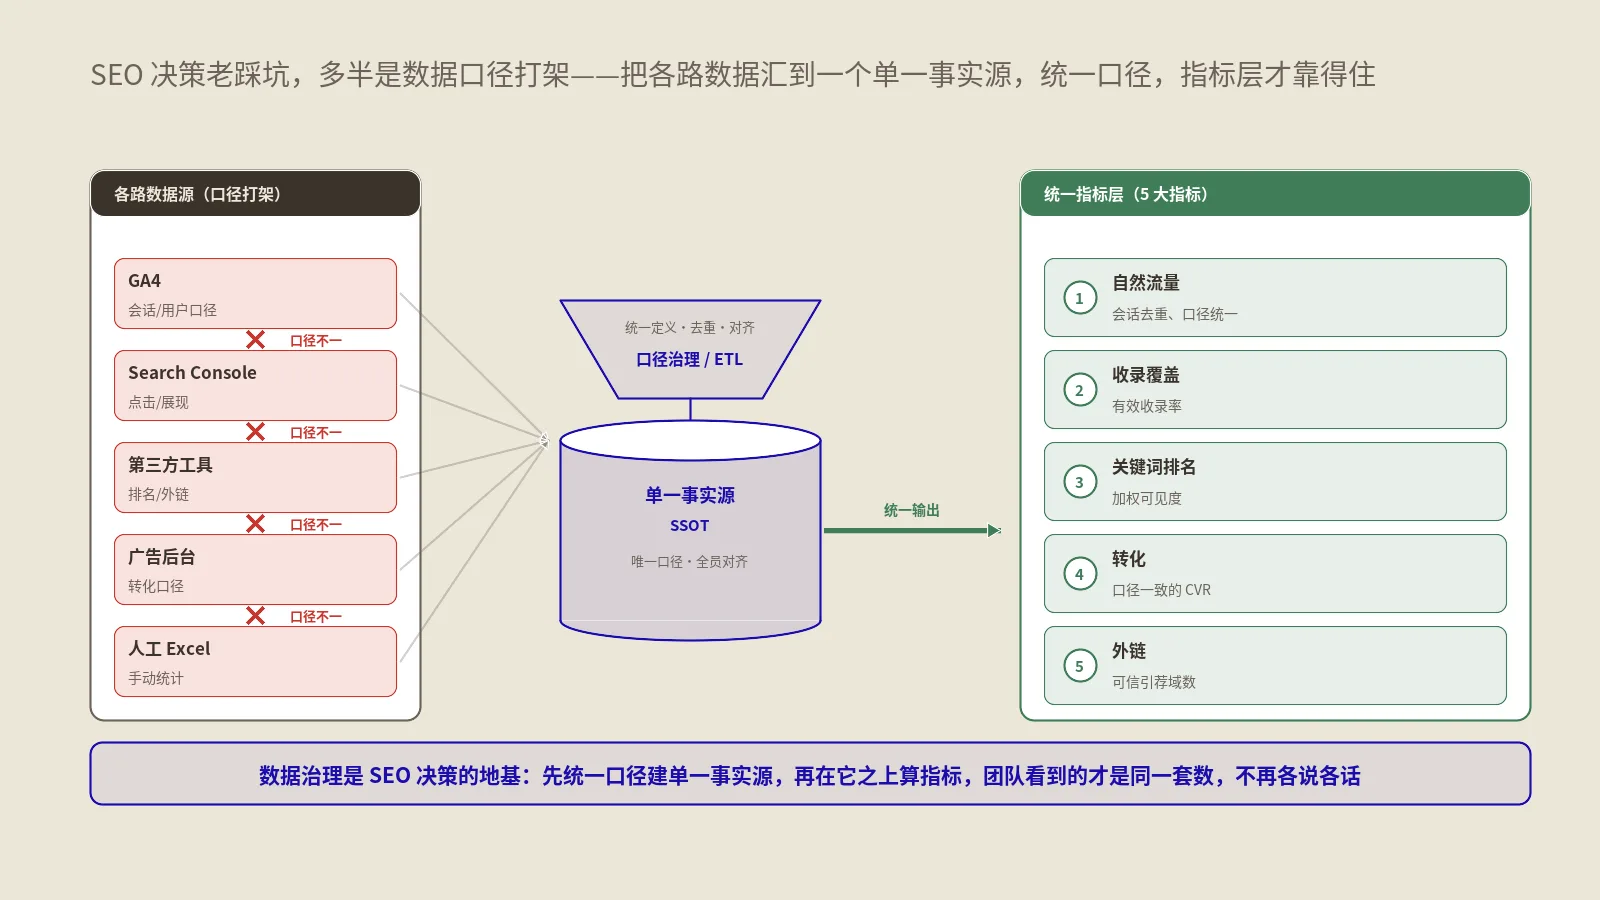
SEO团队的数据问题九成不是缺数据,是同一指标在GSC、GA4、第三方工具里给出四个对不上的数,开会先吵口径。这篇讲数据进看板前怎么建一个有口径定义、单一出口、可信度分级的指标层:四层模型、指标字典、多源对账偏差基线、口径变更评审、最小版怎么落地才不烂尾
SEO不该凭感觉,得靠数据说话。这里聚焦SEO数据分析与工具,从Search Console、GA4指标体系到排名监测、日志分析和Ahrefs、Semrush用法,教你用数据驱动每一个优化决策。
SEO团队的数据问题九成不是缺数据,是同一指标在GSC、GA4、第三方工具里给出四个对不上的数,开会先吵口径。这篇讲数据进看板前怎么建一个有口径定义、单一出口、可信度分级的指标层:四层模型、指标字典、多源对账偏差基线、口径变更评审、最小版怎么落地才不烂尾
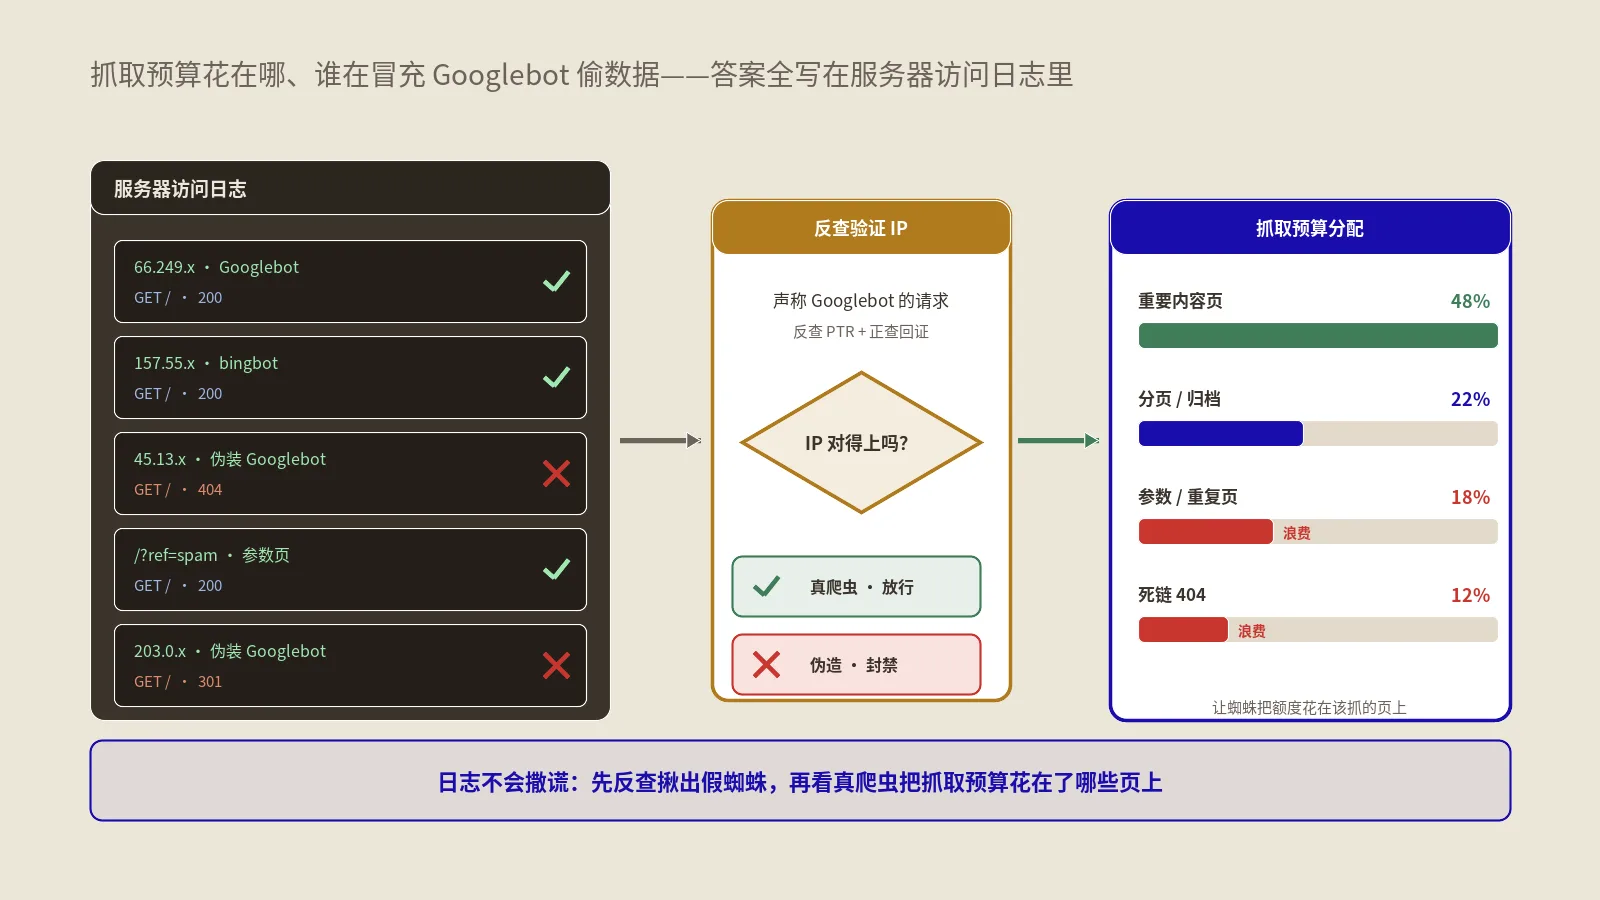
服务器日志是网站这边的真实视角,能看清Googlebot的实际抓取分配、揪出假冒爬虫、按时段读懂状态码异常端倪。这是GSC给不了的诊断维度,大站做SEO必须有的能力。
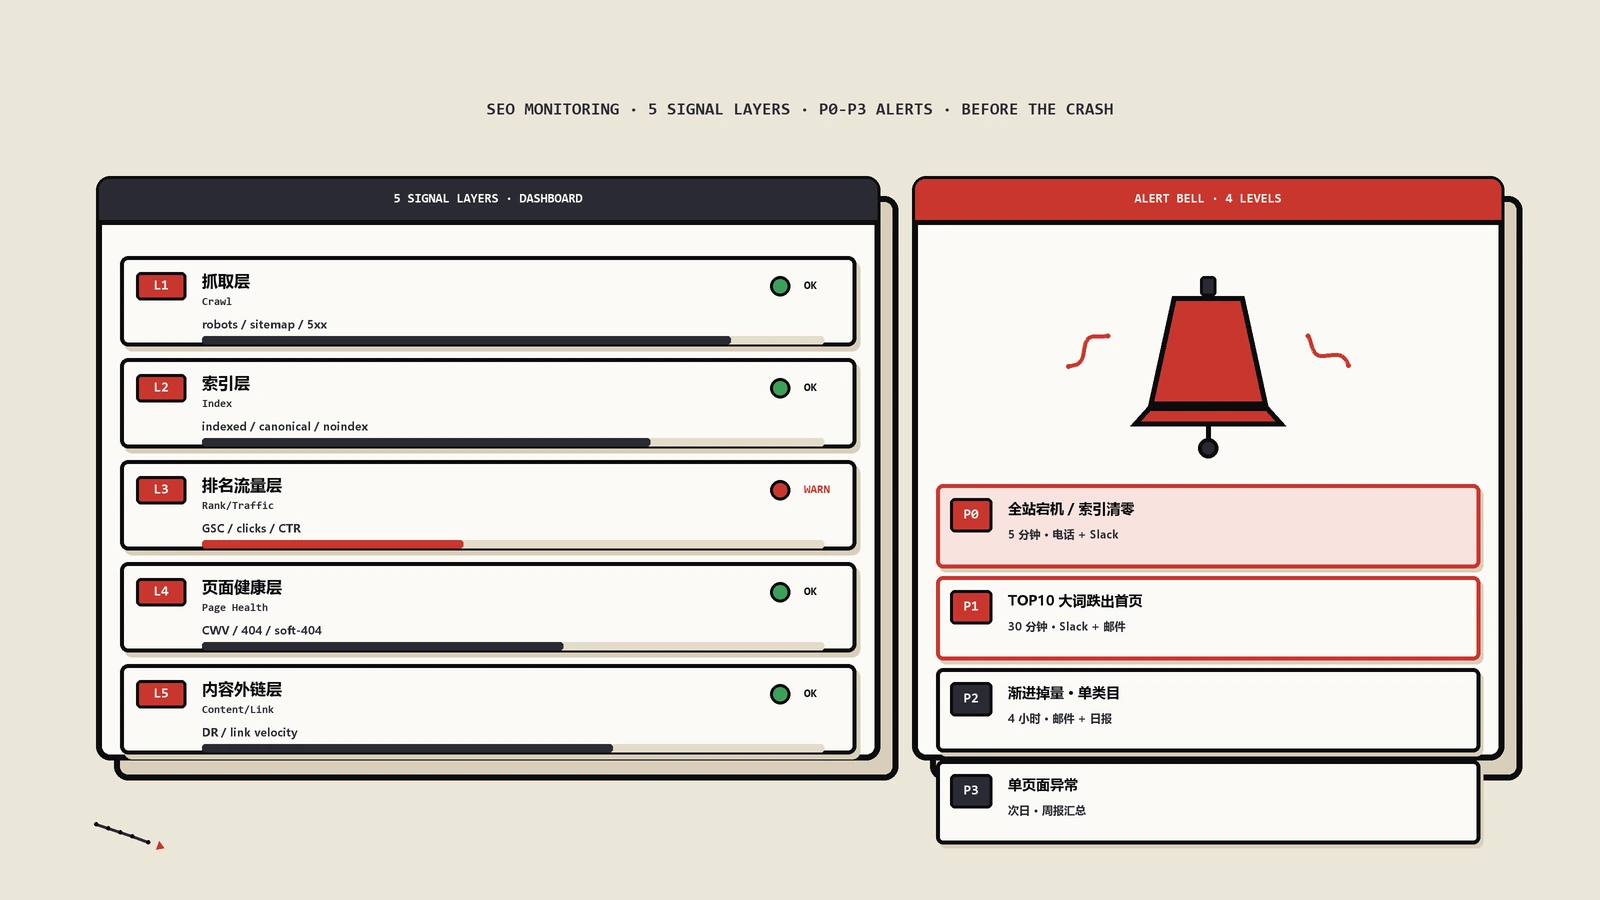
写给独立站主和外贸运营:很多人以为流量掉了自己就会知道,可SEO事故是渐进无声的,等察觉往往晚了两三个月。这篇教你把监控从“做个仪表盘”升级成“设告警”,分层布岗、定阈值、分等级,让系统主动替你站岗。
排名追踪频次该选每天、每周还是每月?样本量100个词还是10000个词够?桌面和移动要不要分开打?地理位置粒度到国家、州还是邮编?变了3名是真变了还是噪声?这篇把排名追踪当成一个统计学采样设计问题来解,按目标和预算反推频次、样本量、设备组合、位置粒度的取舍,给一份置信区间与统计功效的小工具,附长尾分层抽样的实操,再拆自建脚本与商业工具的真实成本结构,最后讲在AI搜索加零点击的双重夹击下排名追踪还该怎么改造。用一个跨境母婴DTC把月成本压…

红红绿绿的排名监测表每天有人盯,可同一个词换台设备、换个城市查就变,平均排名还会被混合效应骗人。这篇讲清排名为什么不再是一个数、可见度份额怎么算、结果页非自然化后排名和流量怎么脱钩、监测怎么设计,以及搜索后台和第三方对不上该信谁。

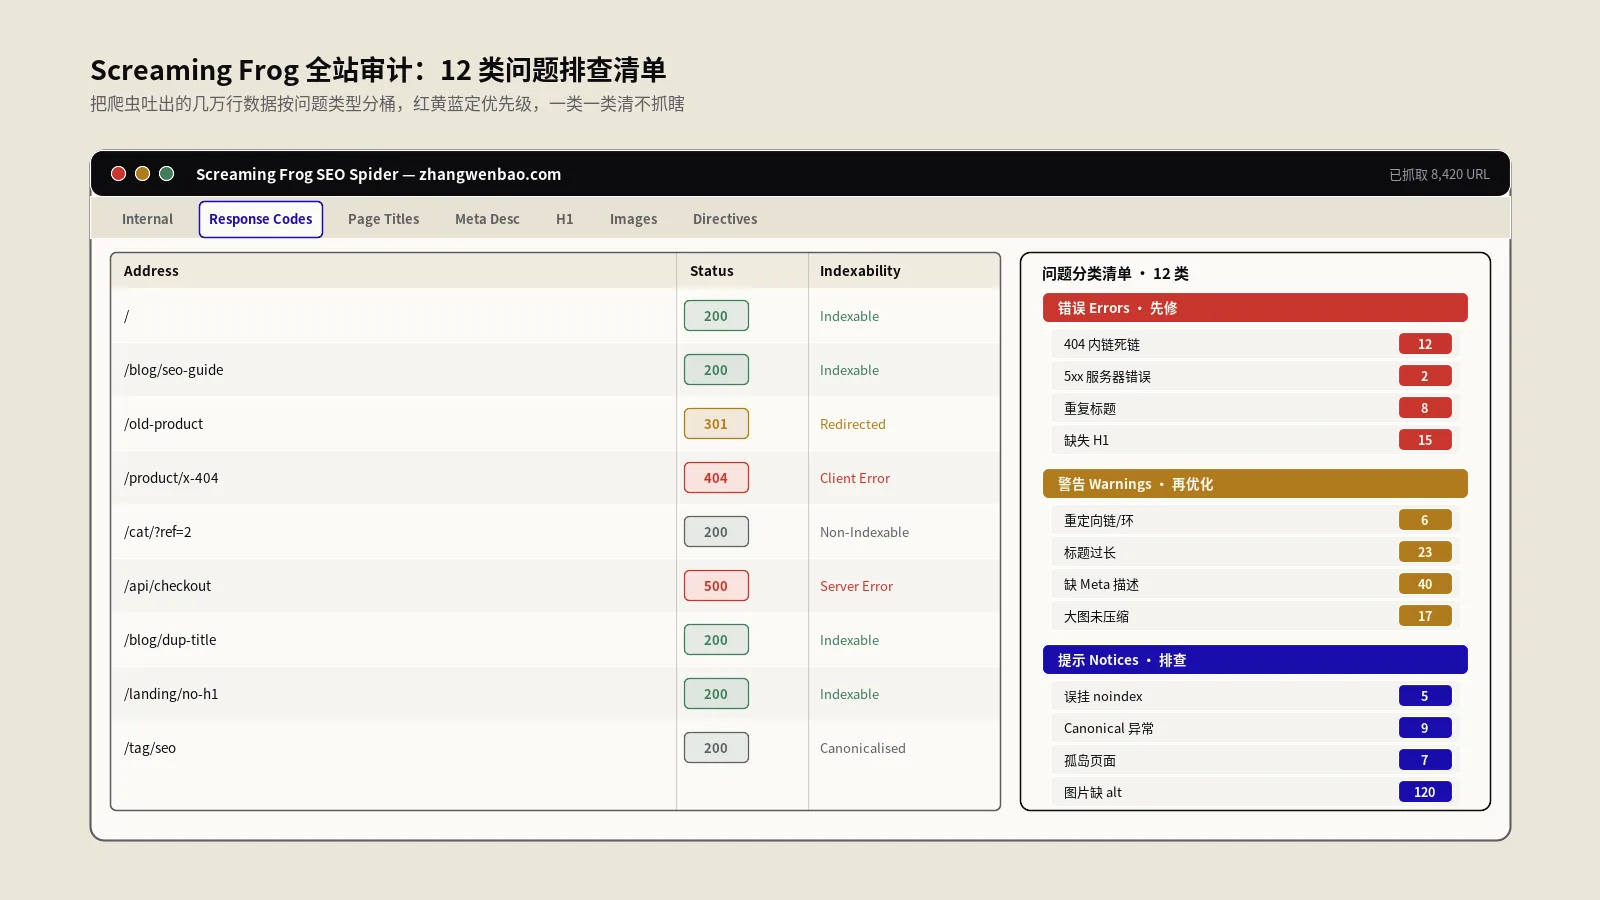
很多人电脑里装着Screaming Frog,却只会跑一遍看个红绿灯,导出几十个CSV就不知道下一步——审计的门槛从来不是工具操作,而是读结果。本文给一套可复用的全站爬虫审计流程:开爬前镜头怎么调、四大类十二小类技术问题分别在哪个报表里看、爬完先看哪些数字哪些是噪声、大站爬不动怎么分段抽样、怎么把爬虫接上GSC和日志、问题怎么交付研发并复爬验证、多久审一次。
选反链工具最贵的失误是先看价格再看活——订阅烧光数据却没到位。这篇从Moz Open Site Explorer退役、Link Explorer接班讲起,把DA/PA/Spam Score这三个常被错读的指标拆开,再对比Ahrefs、Semrush、Majestic、Moz四家工具的强项与盲区。按团队体量和市场给到一张选型表,竞品反链拆解给出可复现的六步SOP,附一家出海复古黑胶唱机DTC在12周里把独立指向域名从14跑到312的实战,…

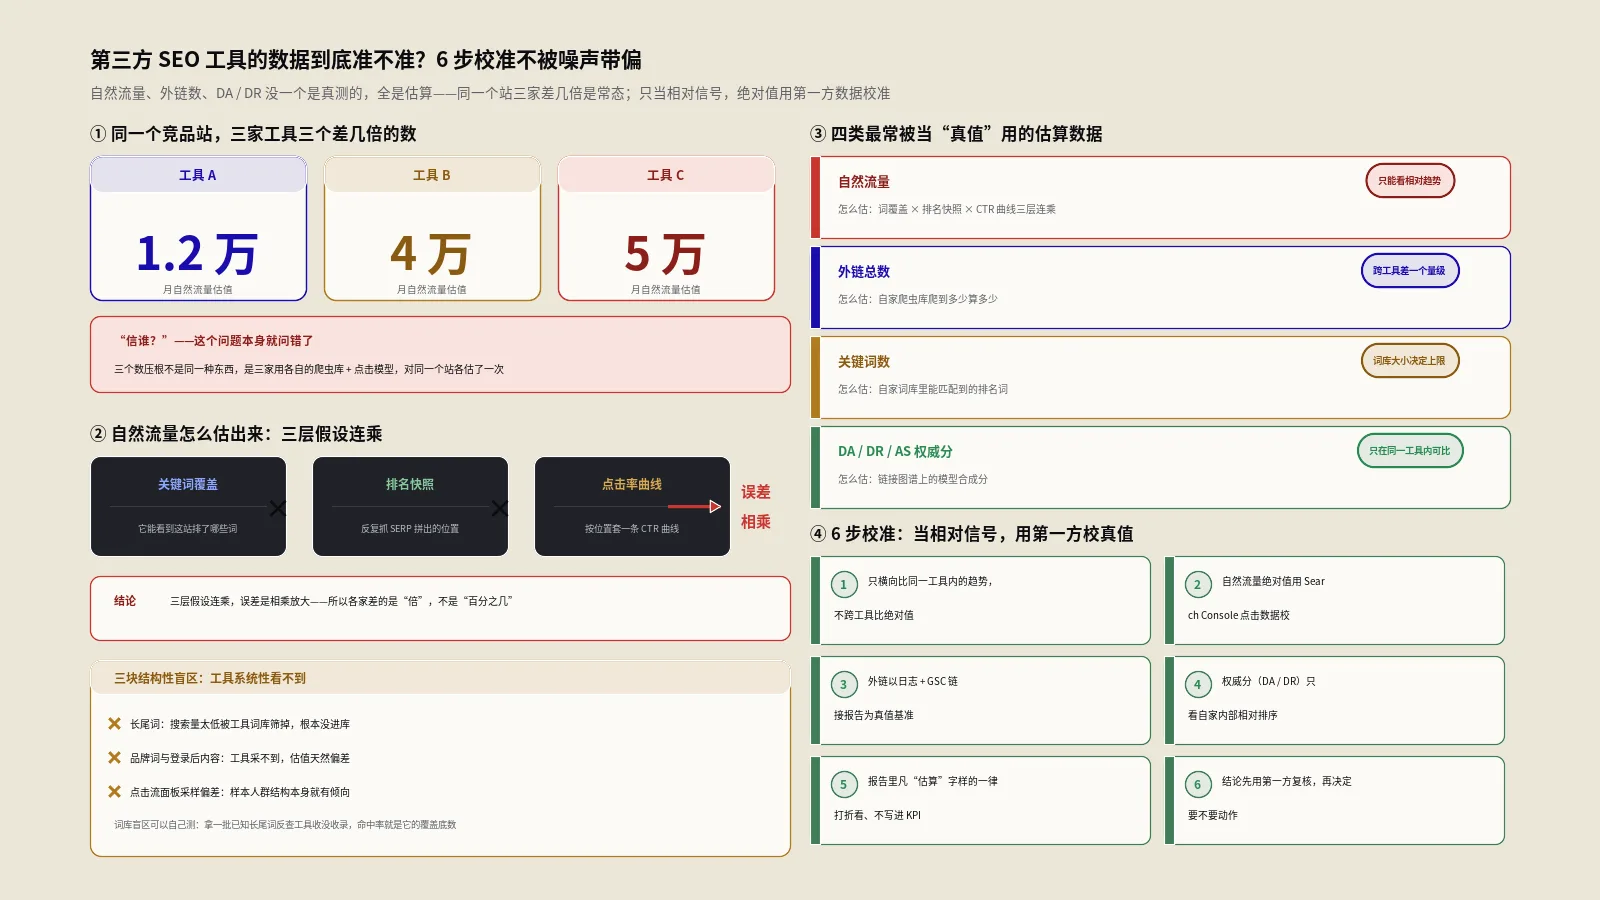
同一个站,一家工具说月流量两万、另一家说八千、第三家给五万;外链数三家差一个量级;DR和DA各说各话——到底信谁?答案是这些数字本来就不是真值,是各家用不同的爬虫库、点击流面板和外推模型估出来的。本文拆解流量、外链、关键词、权威分四类数据的估算管线,讲清各家为什么差几倍、什么时候能信什么时候只能当噪声,以及怎么用Search Console和日志这类第一方数据把它们校准着用。