PR预算到2027年翻倍?Gartner这条预测的出处与AI引用数据,外贸站的数字公关钱该怎么花
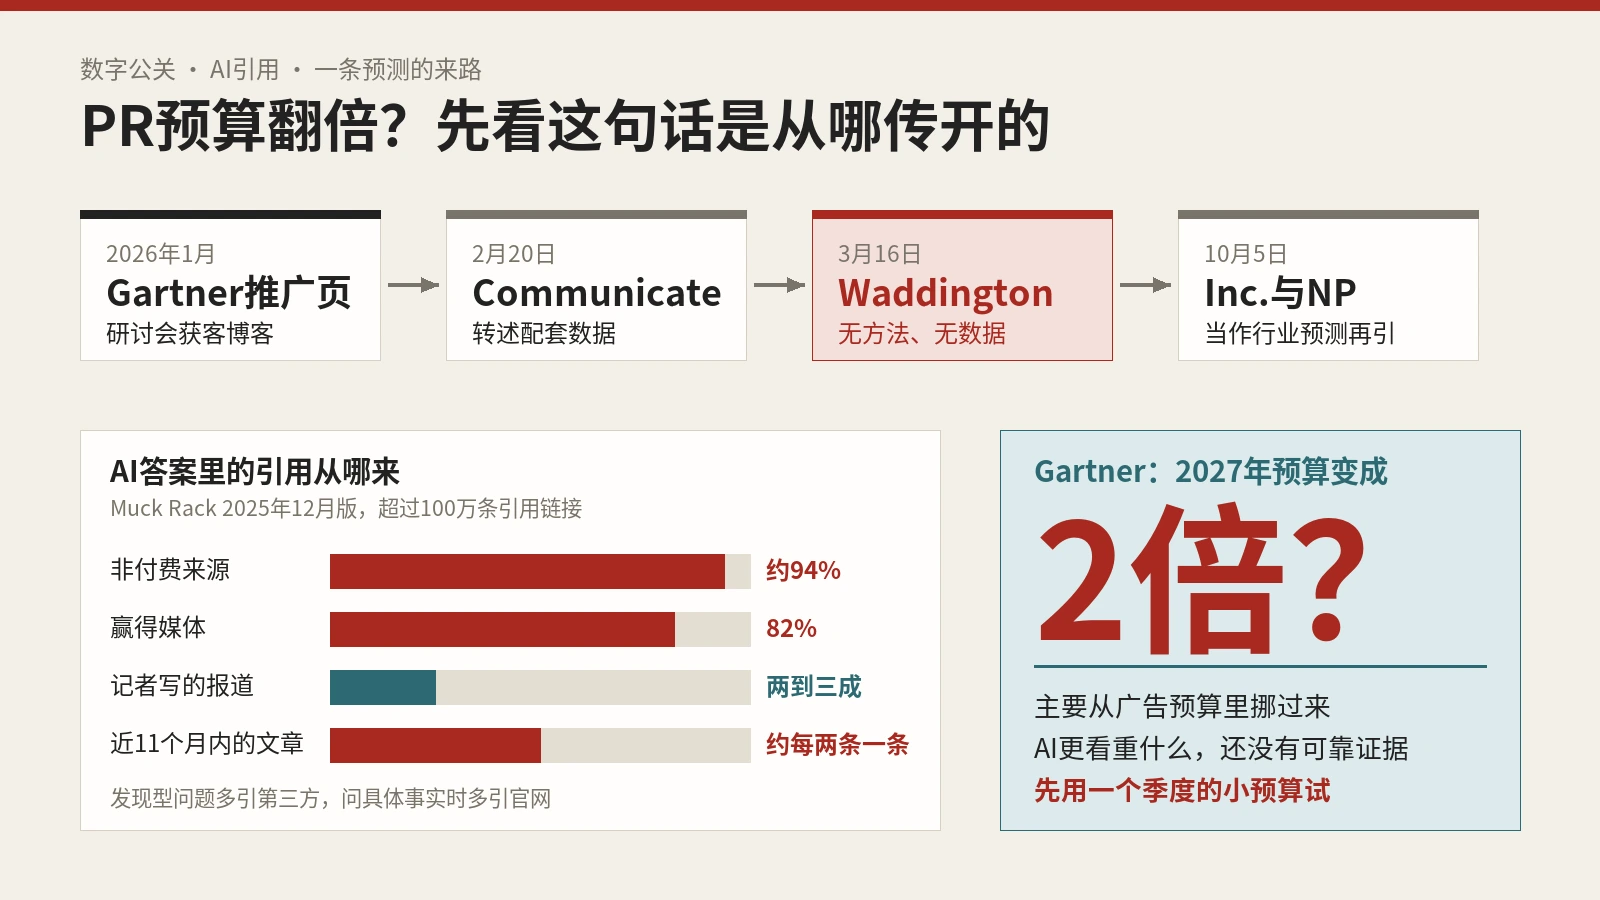
以Neil Patel团队10月5日的文章为主体,追溯Gartner关于PR与赢得媒体预算2027年翻倍的预测出处,对照Muck Rack两版AI引用报告的口径变化和Waddington的质疑,说明第三方报道影响AI答案的机制与说过头的地方,再给外贸站和独立站一套数字公关预算分配与效果衡量方法。
想让网站在谷歌和百度持续拿到免费流量,靠的不是碰运气而是体系。这里汇集保哥二十多年的SEO实战经验,从关键词研究、页面与技术优化到外链建设、内容策略和算法应对,手把手带外贸、独立站与SEO从业者把搜索排名做成可复制的长期增长。
以Neil Patel团队10月5日的文章为主体,追溯Gartner关于PR与赢得媒体预算2027年翻倍的预测出处,对照Muck Rack两版AI引用报告的口径变化和Waddington的质疑,说明第三方报道影响AI答案的机制与说过头的地方,再给外贸站和独立站一套数字公关预算分配与效果衡量方法。
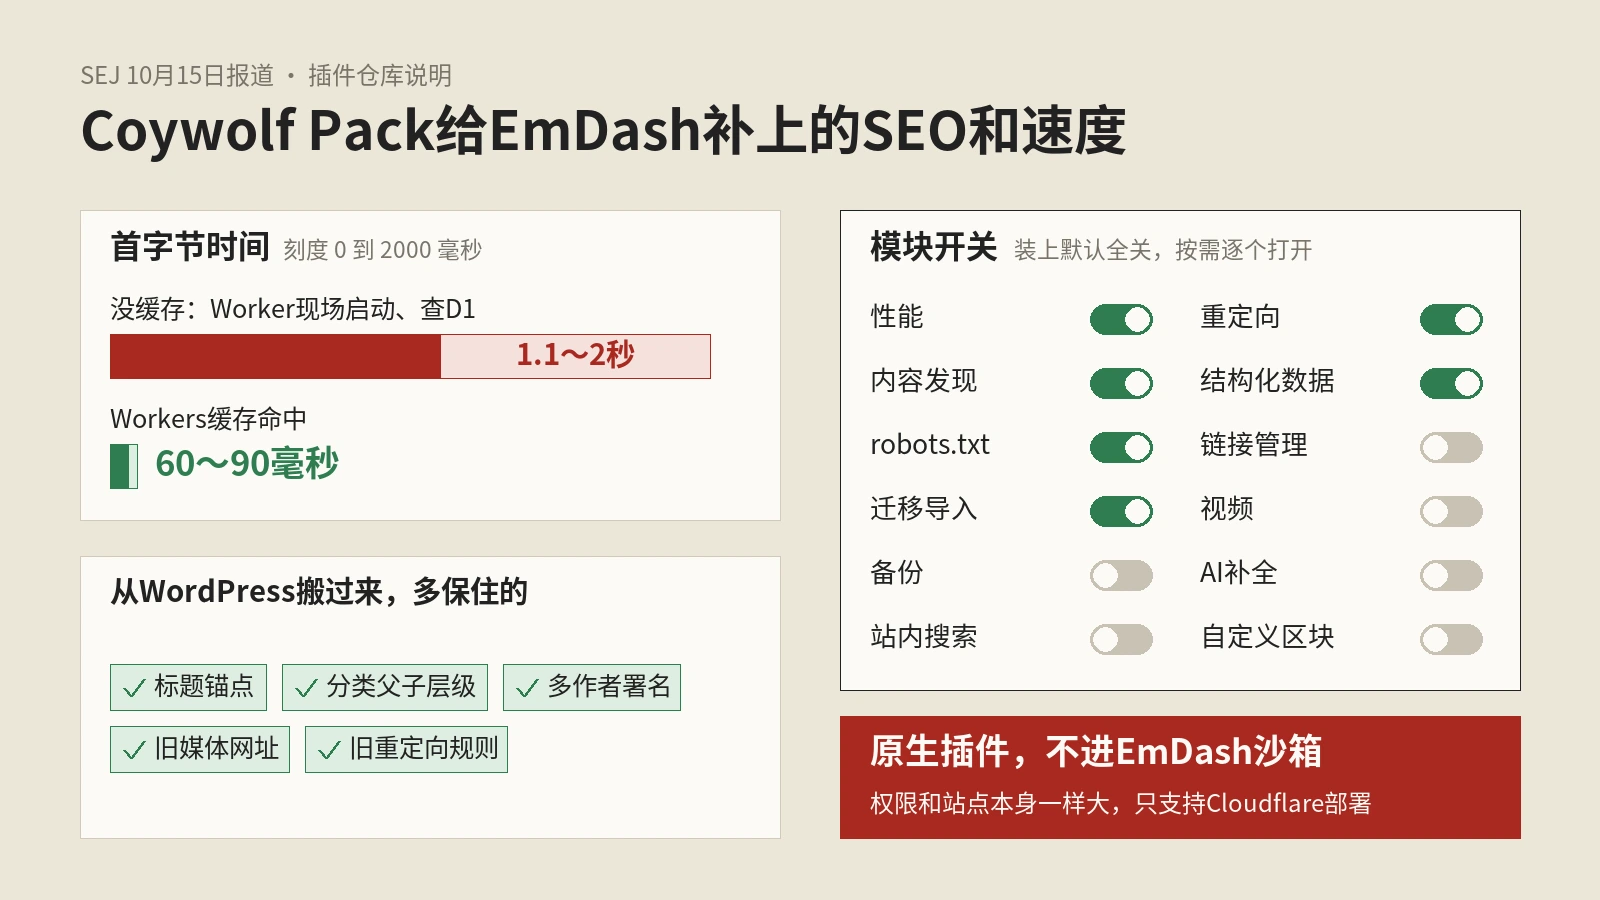
以SEJ 10月15日的介绍为主体,对照仓库说明和EmDash插件沙箱文档,讲这款EmDash SEO插件的安装条件、Workers缓存与预热的提速做法、内容发现与结构化数据和robots.txt模块、WordPress迁移补齐的项目,以及和Yoast、Rank Math的功能对照与上线验收清单。
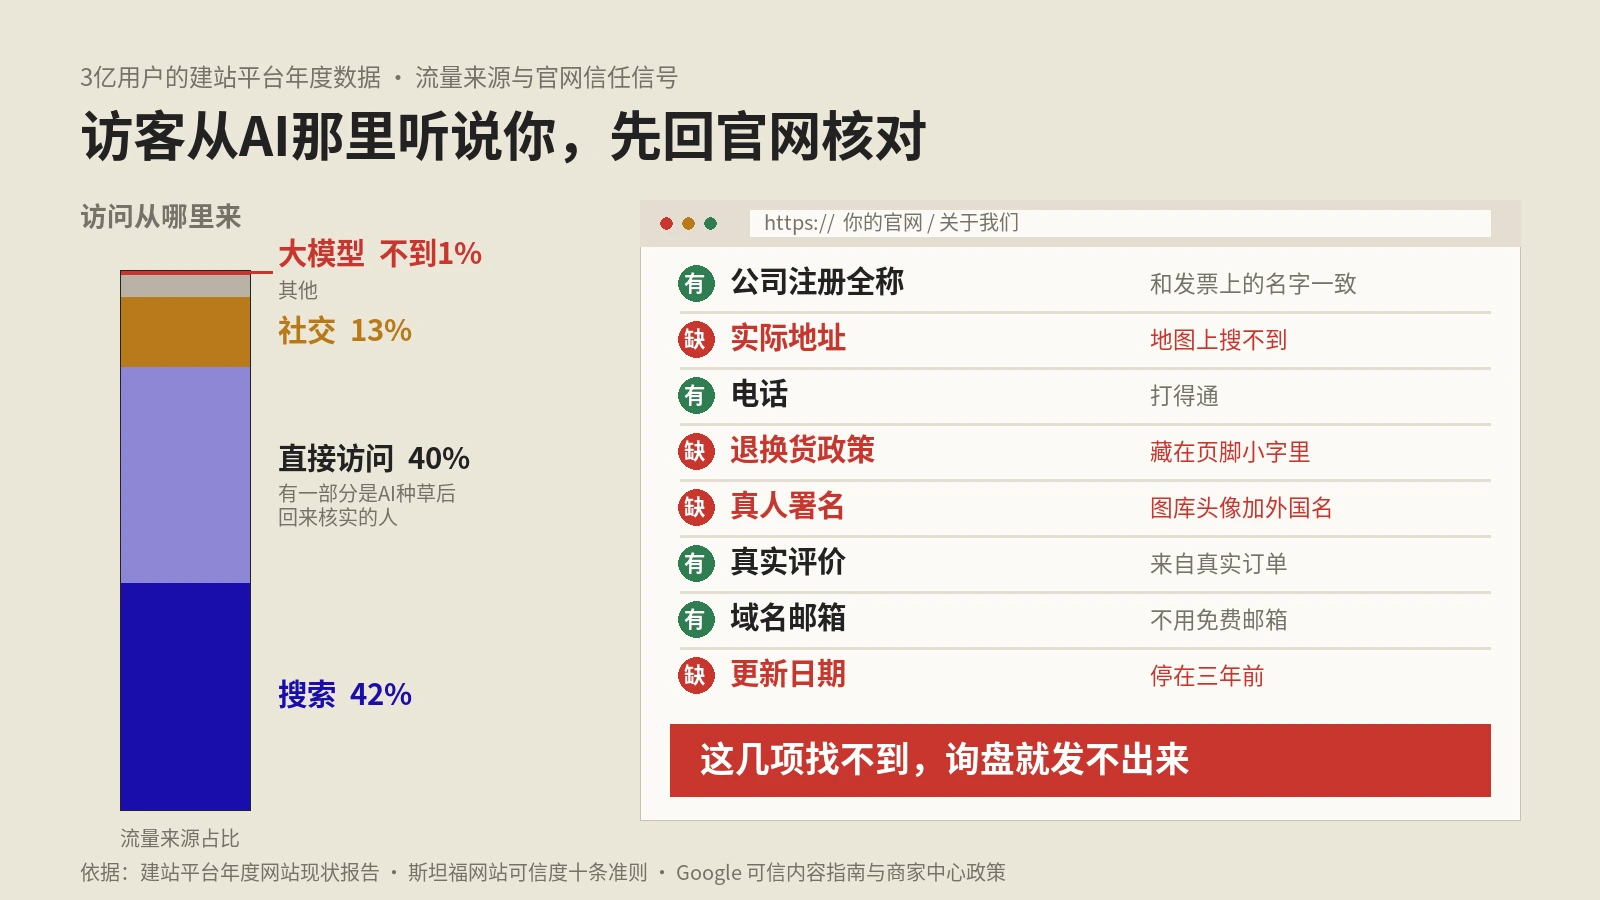
以Neil Patel团队10月14日的文章为主体,对照Wix网站现状报告原文补齐NP漏写的直接访问、评价成功率和llms.txt数据,逐条说明各项倍数的口径与相关性,再结合斯坦福可信度准则、Google可信内容指南和Merchant Center政策,整理外贸站与独立站的信任信号检查表。
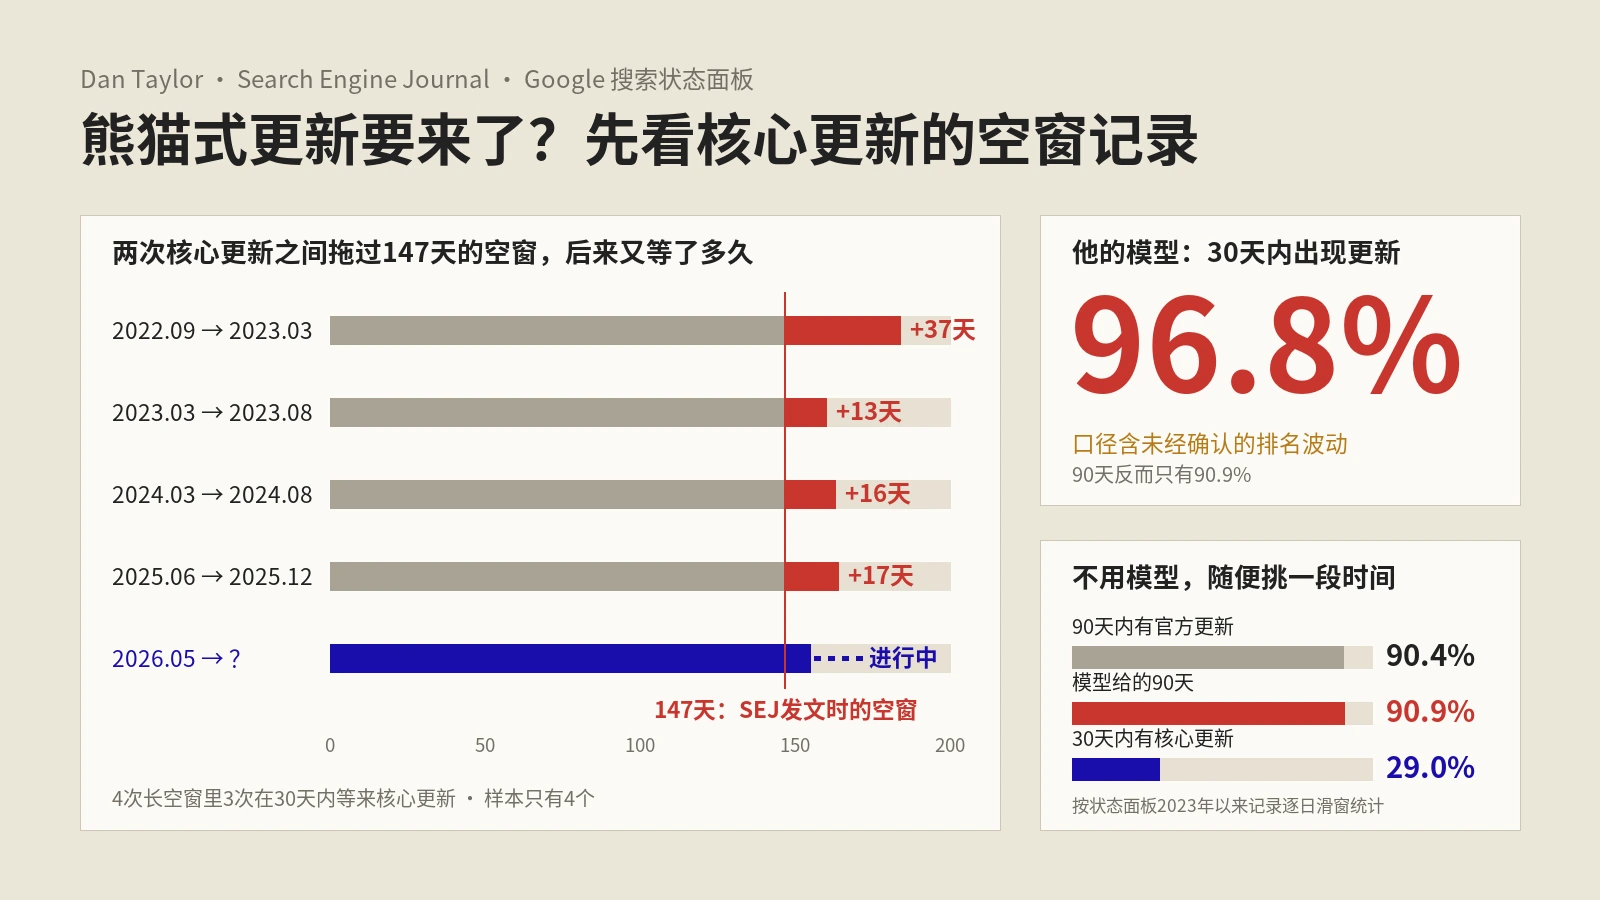
以SEJ专栏作者Dan Taylor的熊猫式更新预测为主体,对照Google搜索状态面板历年核心更新记录、2011年熊猫上线公告和10月新改的AI内容与有用内容文档,讲清这个概率的口径问题、熊猫被误读成字数标准的来由、站点级与页面级的区别,以及外贸站更新前的清点和汇报做法。
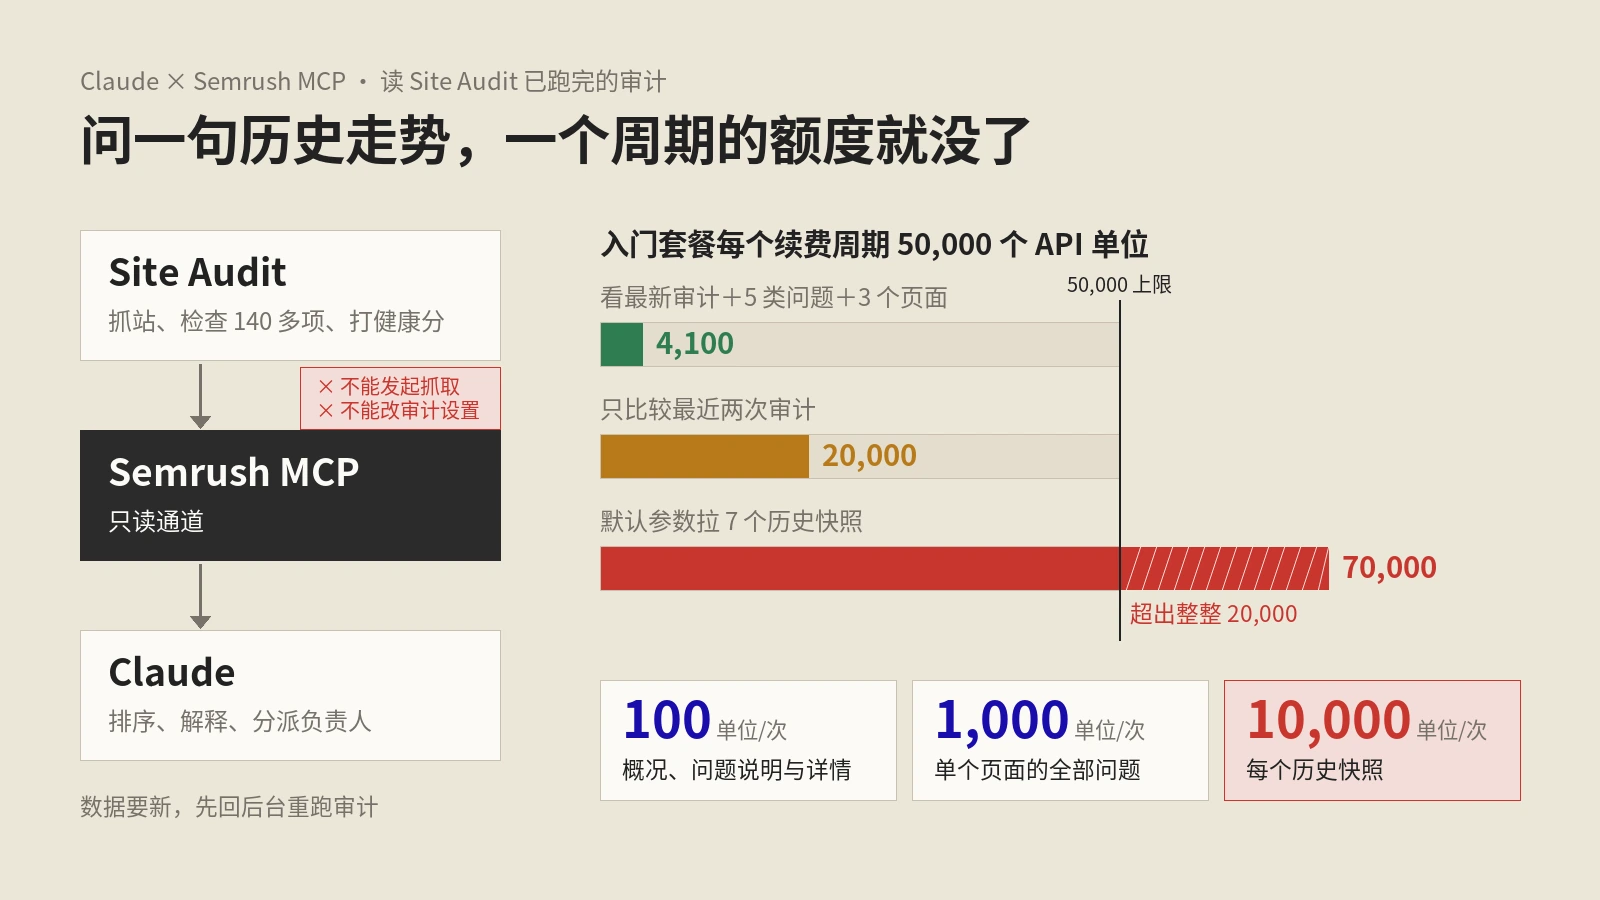
以Semrush 10月15日的教程为主体,对照MCP知识库、开发者文档、Site Audit API价格表和官方技术审计技能文件,讲清Claude接入要的套餐、网页版与Claude Code的连接步骤、每类提问对应的接口、三个问题级别怎么读、追问排序的写法,以及代写title和meta描述上线前的核查。
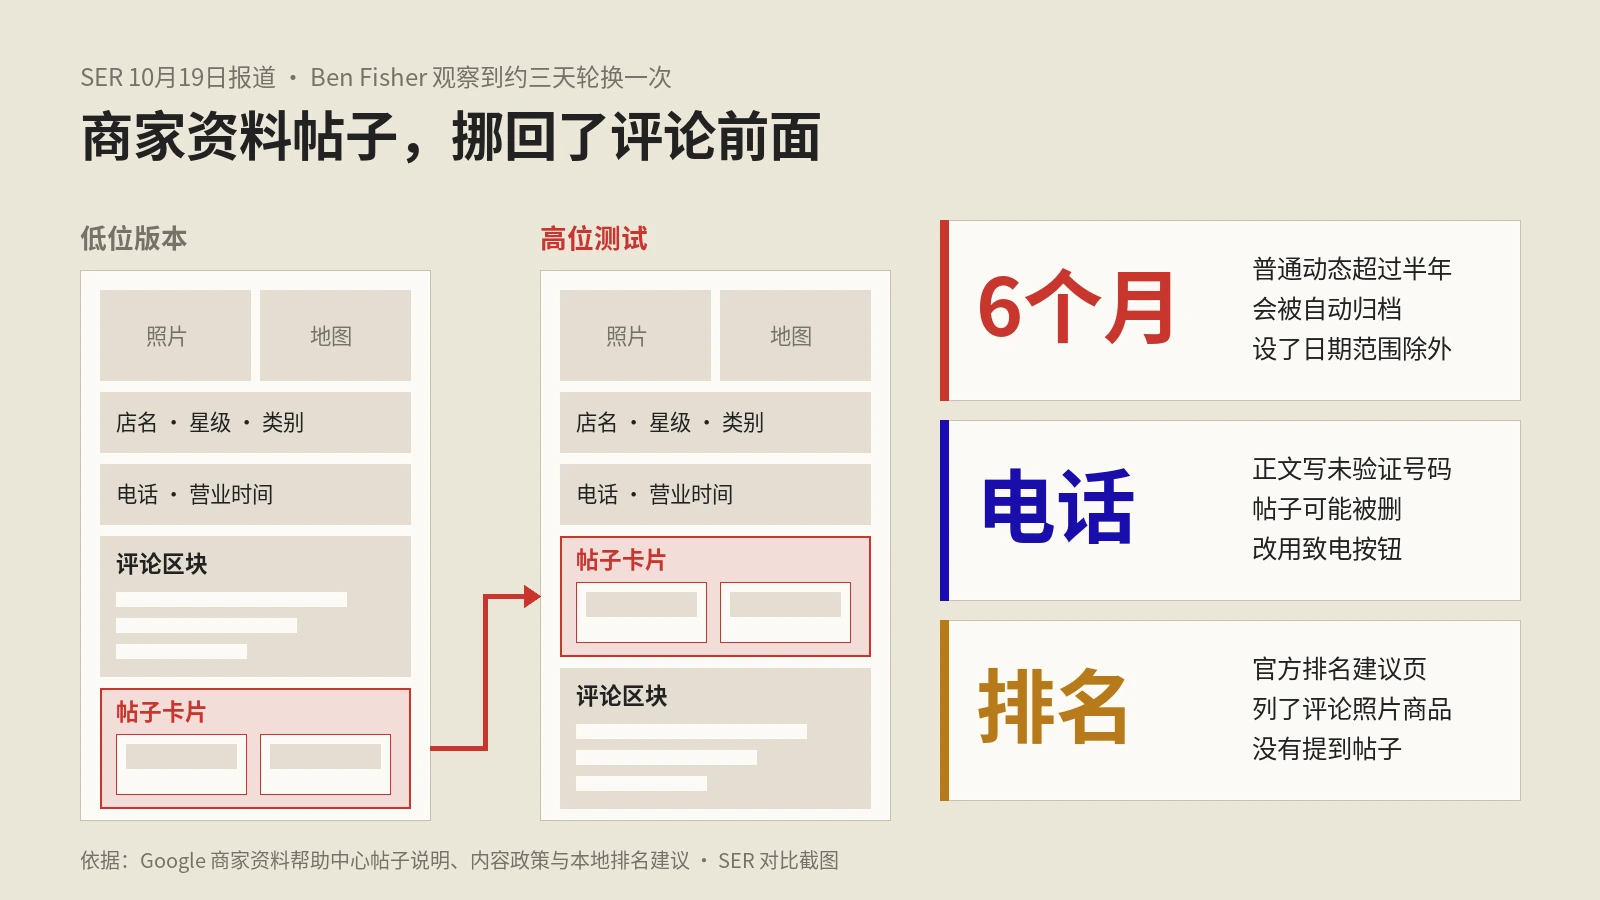
以SER 10月19日的报道和截图为主体,对照2018年帖子下移的旧报道、Google帮助中心的帖子说明、内容政策、本地排名建议和接口文档,讲清楚帖子位置变化的时间线、三种帖子类型与必填字段、被拒原因与补救、浏览量对比怎么避坑,并给出海外门店和外贸展厅的发帖自查表。
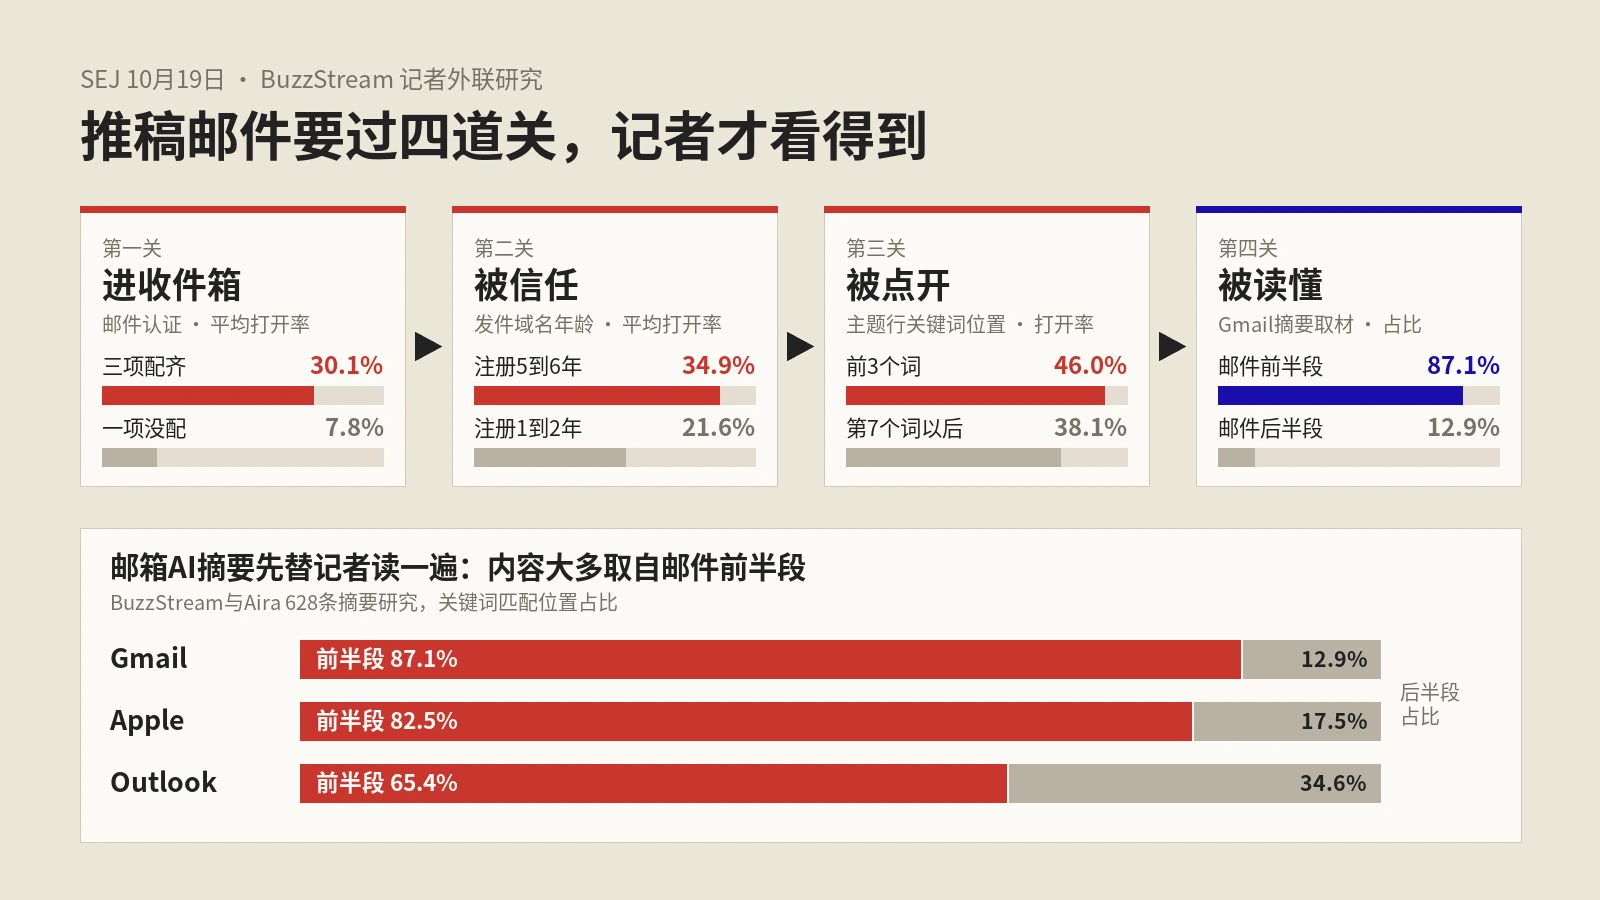
以SEJ上BuzzStream总监Vince Nero 10月19日的文章为主体,逐项回到原始研究核对样本与口径,补充Gmail发件人要求,讲清挑记者、域名年龄、SPF与DKIM及DMARC配置、主题行词序、AI摘要取材规律,以及外贸团队可以照做的发稿清单。
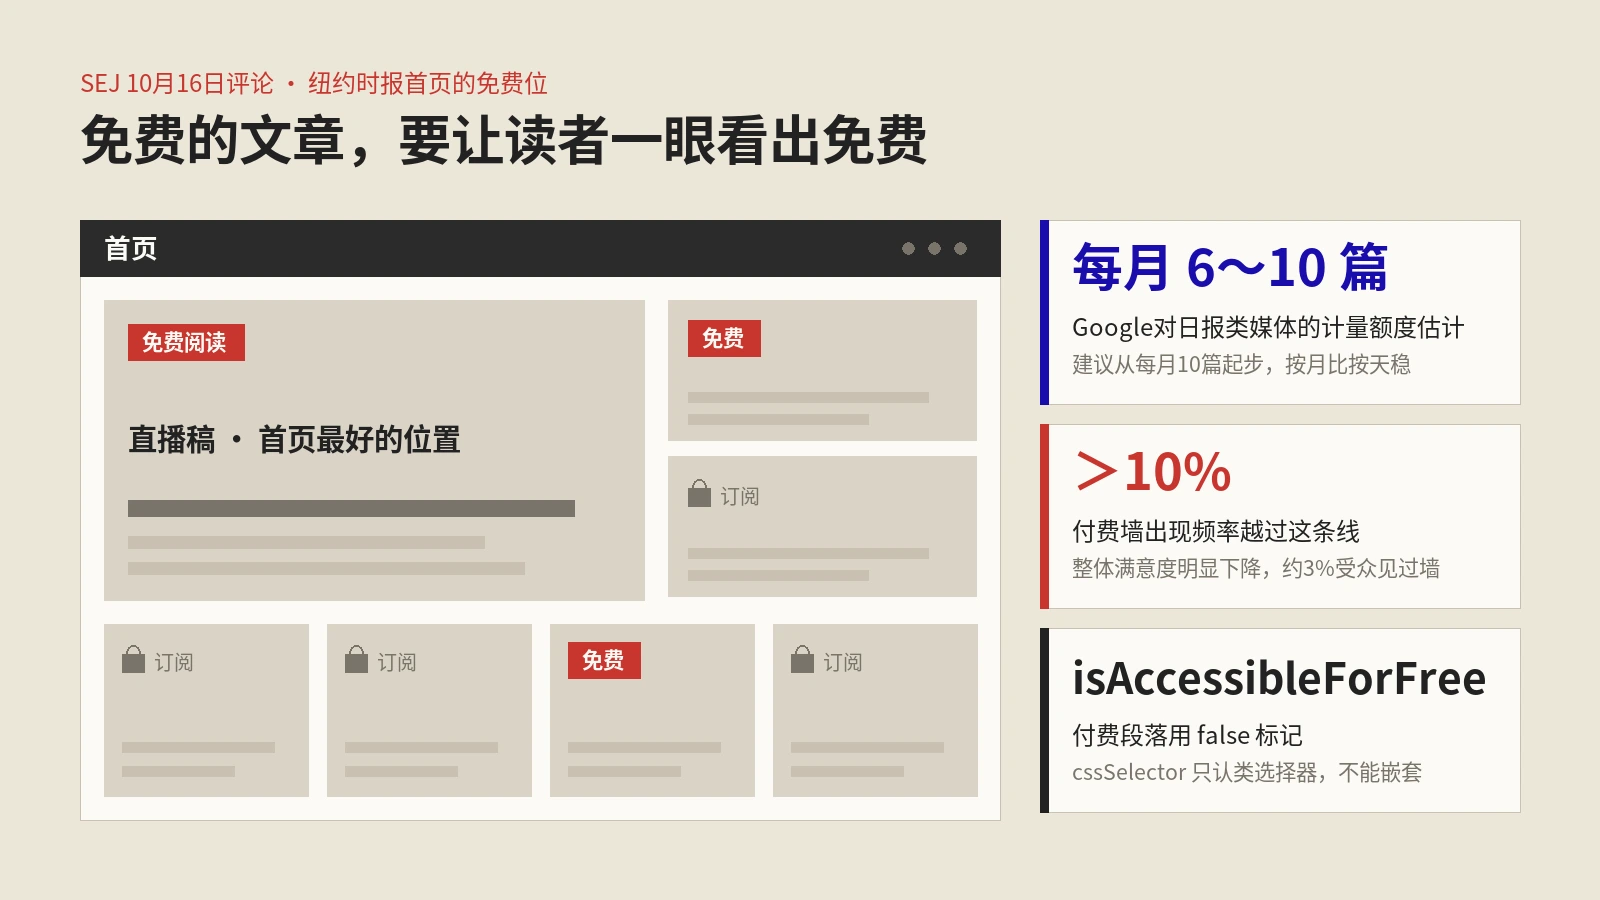
以SEJ 10月16日Harry Clarkson-Bennett的评论为主体,讲纽约时报首页免费文章与免费标签的三条理由,对照Google灵活抽样指南、付费内容结构化数据和JavaScript付费墙要求,给出知识付费站、会员资料站和外贸B2B站的做法与衡量指标。
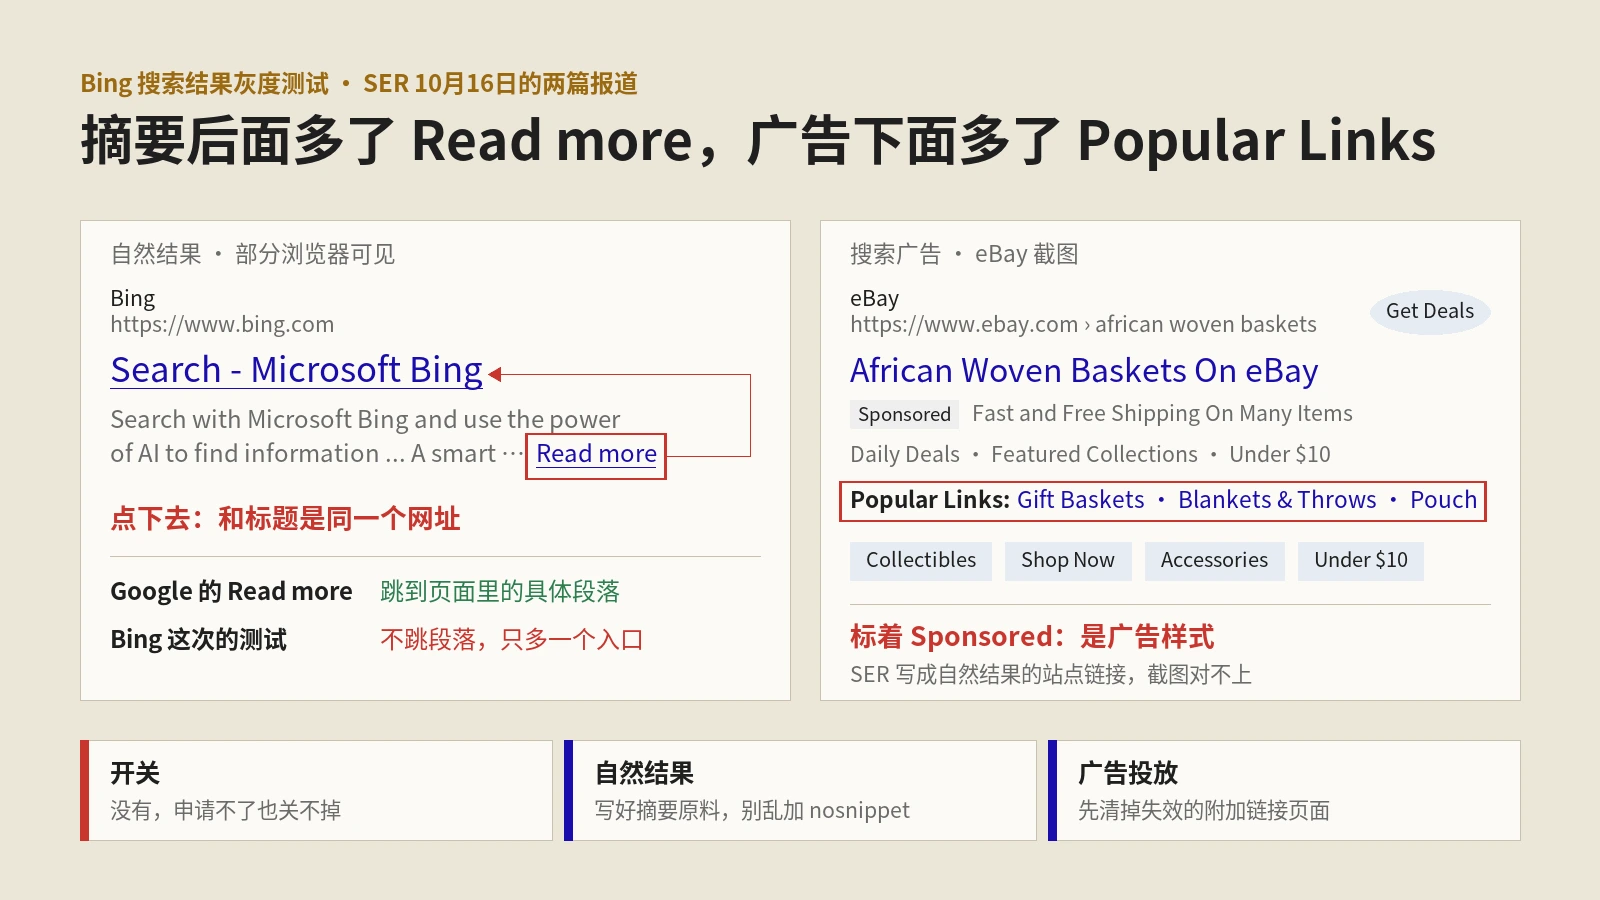
以SER 10月16日的两篇报道为主体,对照截图、Google的Read more深层链接文档和Bing站长指南,讲清楚Bing这次测试的两种样式、点击去向和Google有什么不同、Popular links为何是广告测试,以及摘要、nosnippet、锚点和广告附加链接该怎么提前准备。
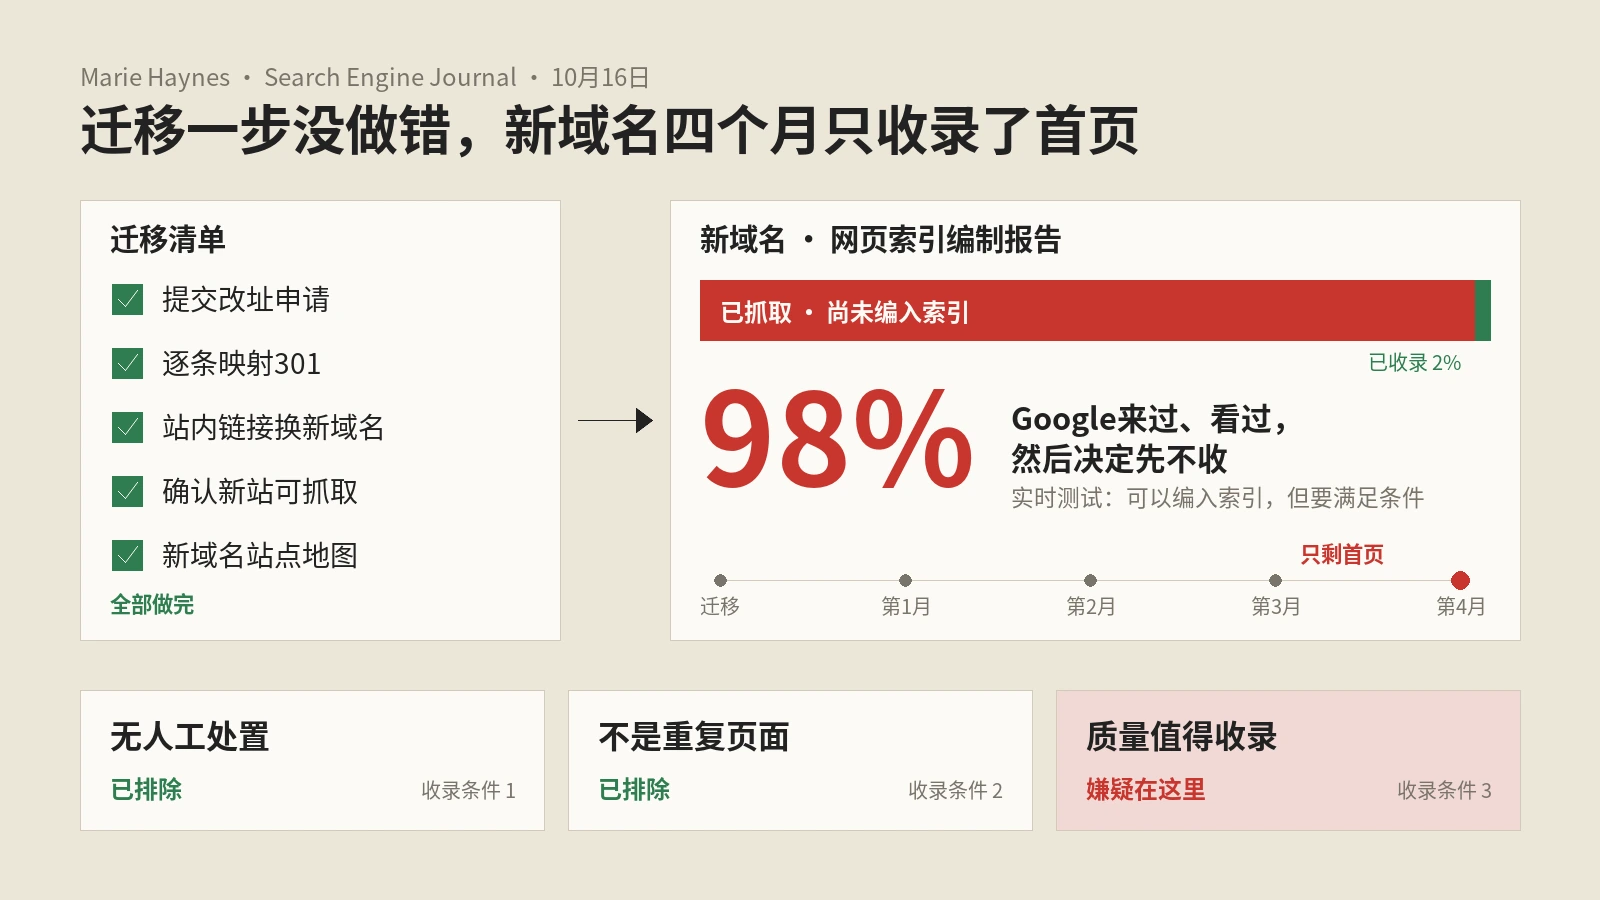
以SEJ上Marie Haynes 10月16日的文章为主体,对照Google网址检查工具、改址工具和有用内容文档原文,讲清楚新域名只收首页的案例、迁移触发质量重审的推测与疑点、先查哪些技术原因、原创性怎么理解,以及重写、等待、换域名三条路怎么选。
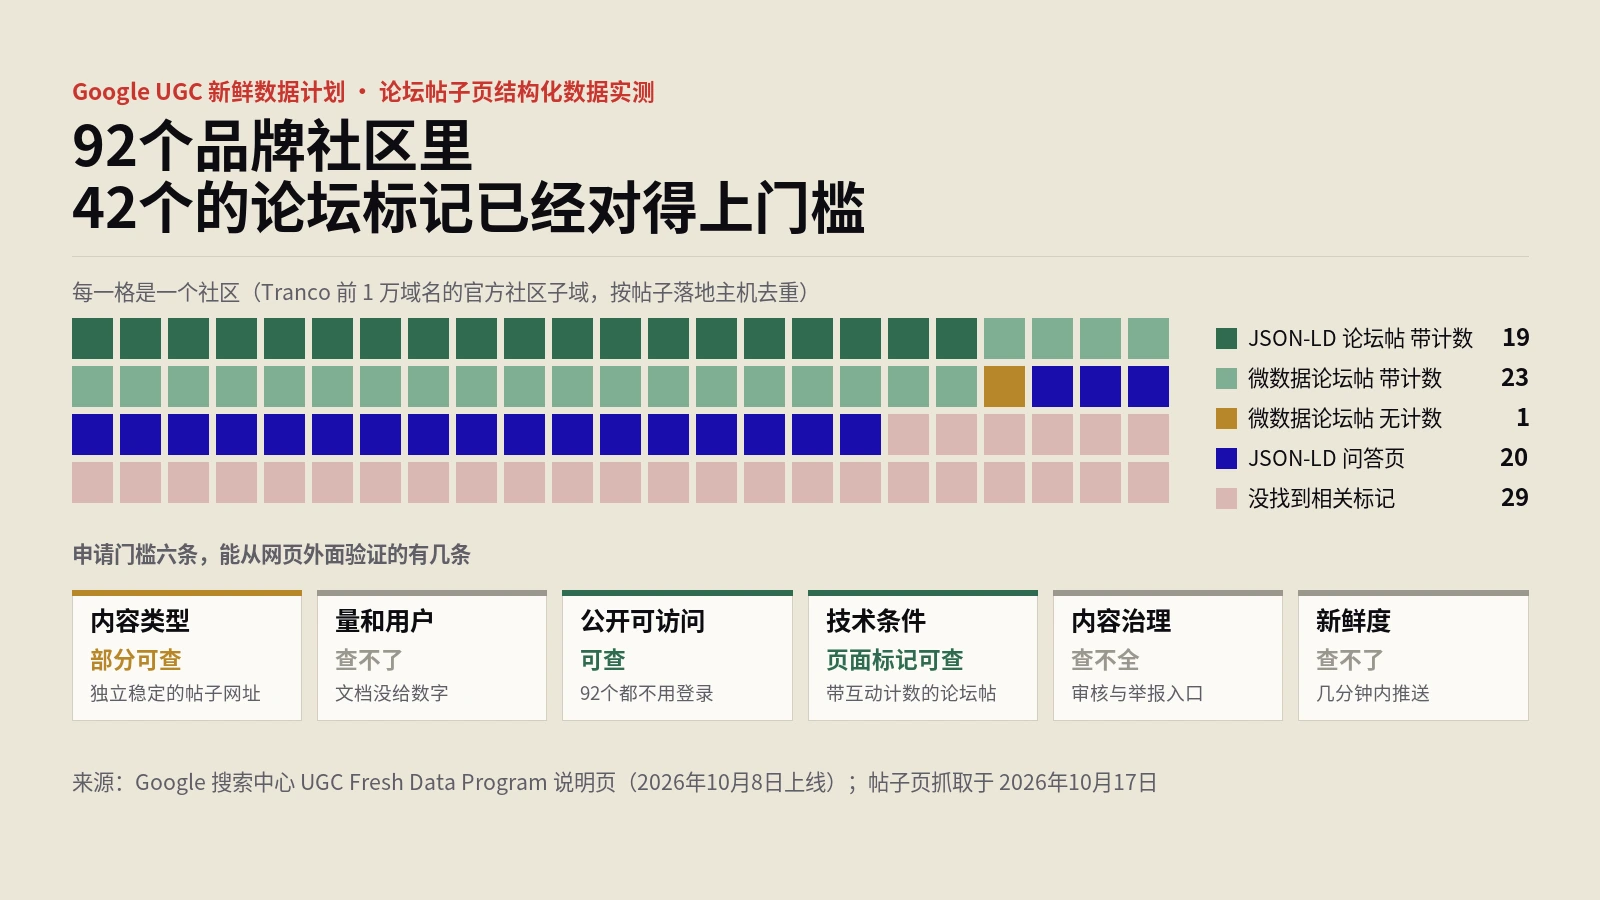
做法:逐条整理Google UGC新鲜数据计划说明页的六条资格要求;从Tranco前1万域名拼出5万个社区子域名,过滤泛解析后取回799个社区首页,抽取帖子页解析JSON-LD与微数据,按帖子落地主机去重得到92个社区,逐项核对论坛帖标记、互动计数、作者主页与登录墙。
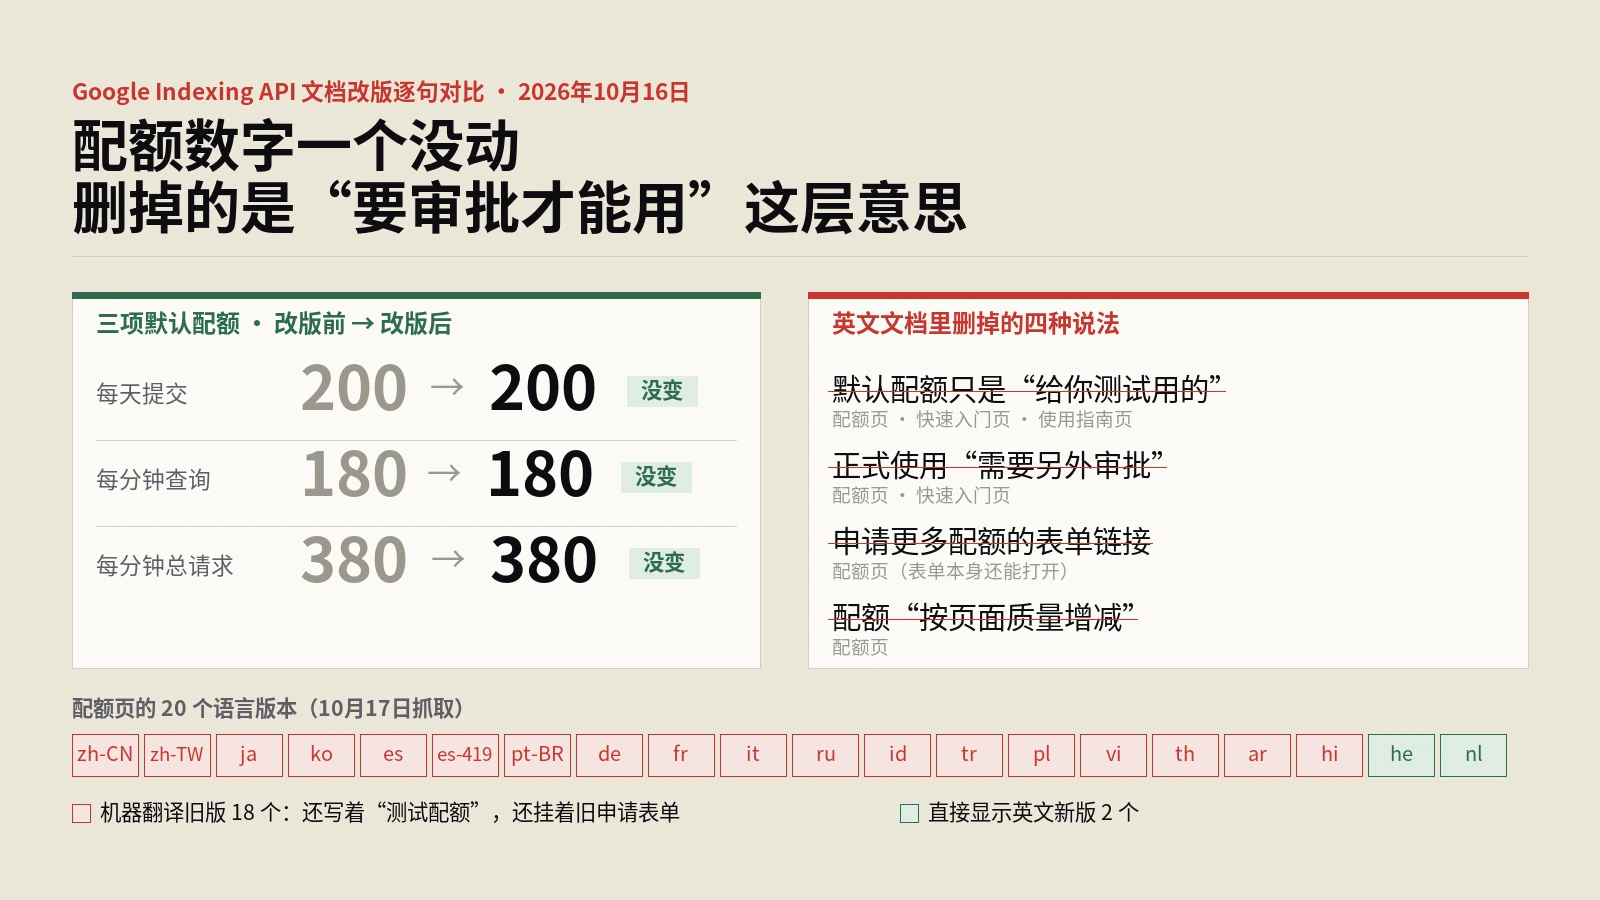
做法:从Common Crawl取回Indexing API配额页、快速入门页、使用指南页改版前的英文存档,和10月17日的现行版本逐句对比;再抓取三页的20个语言版本,统计哪些还停在旧版;最后用已登录账号只读打开旧申请表单。
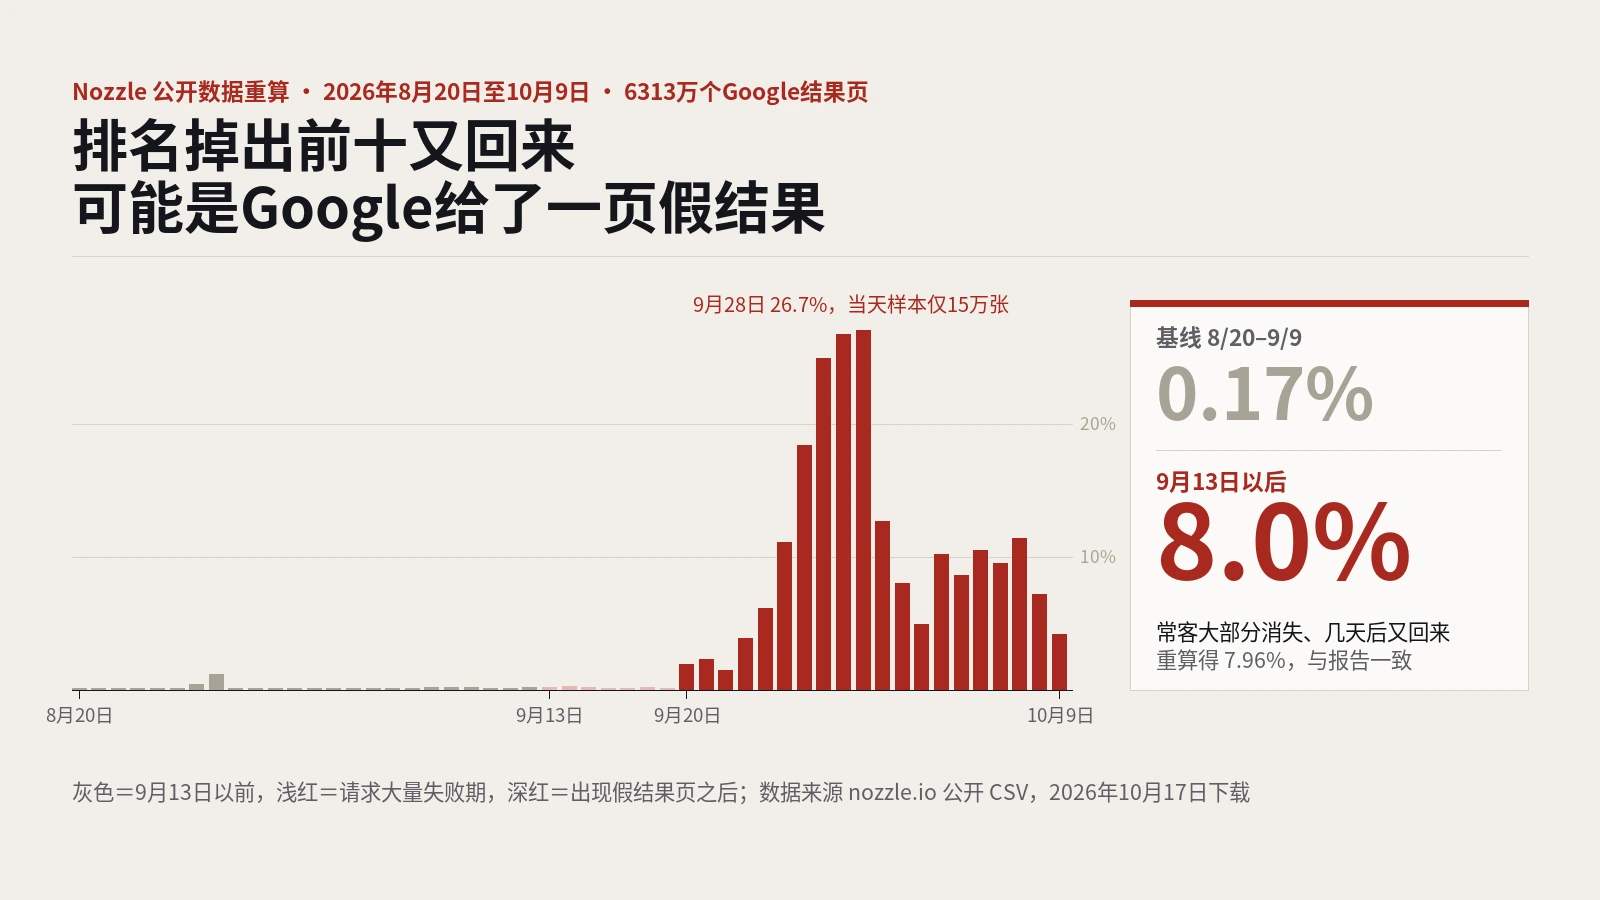
做法:下载Nozzle公开的5个原始数据文件,重算8月20日至10月9日6313万个Google结果页的投毒率;按外贸常见市场、关键词类型和行业重新排序;再与Google搜索状态面板上9月垃圾内容更新的起止时间对照。
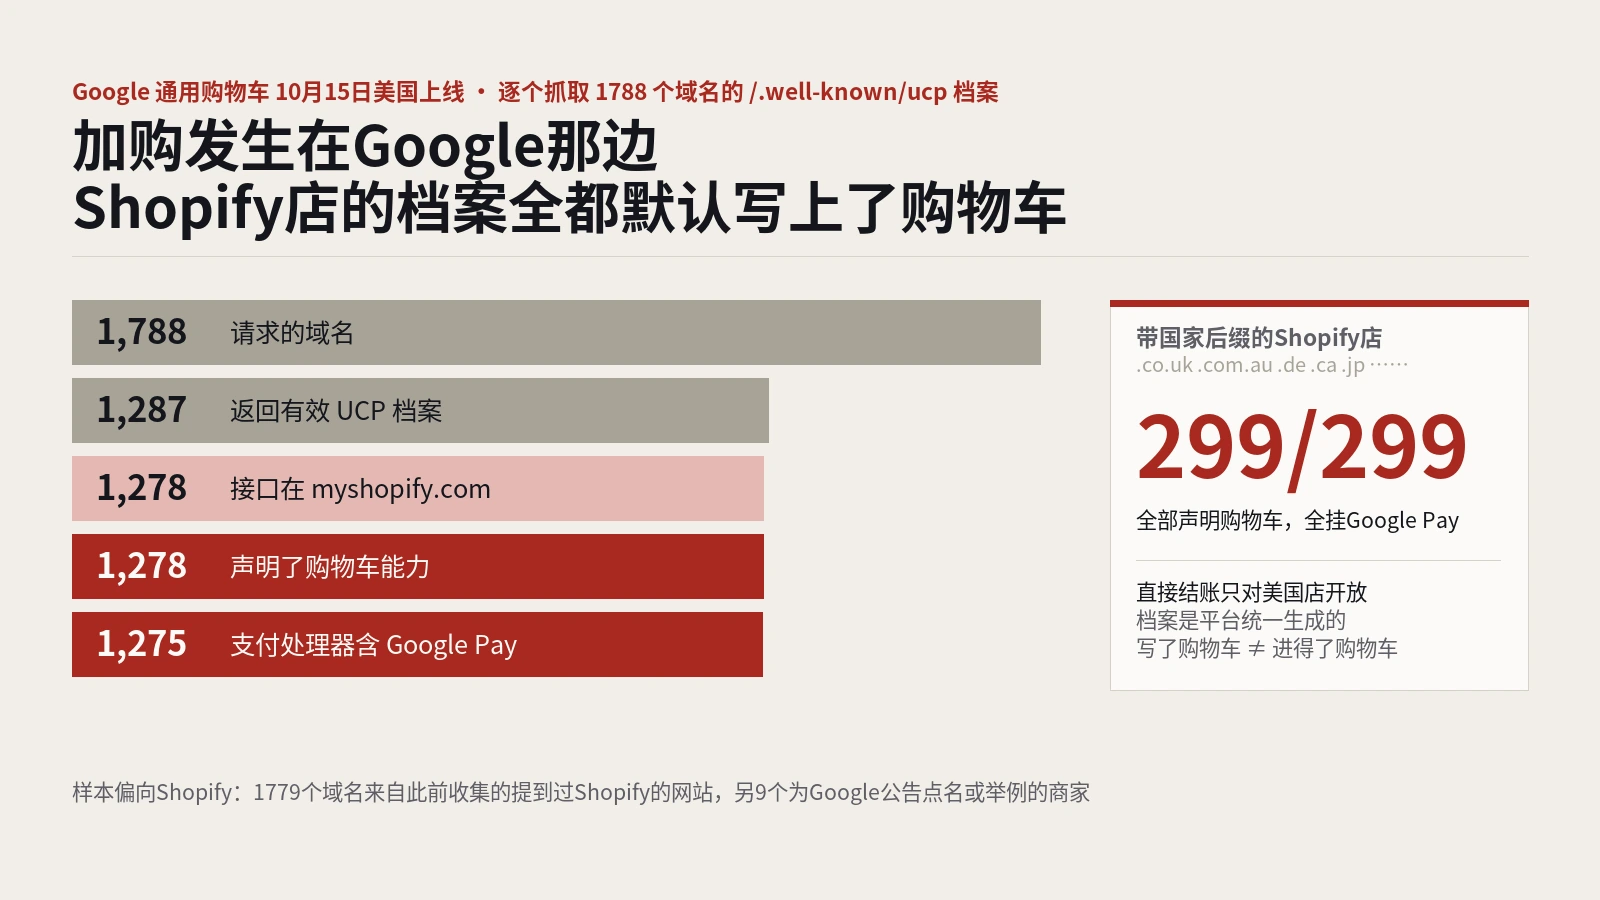
做法:对照Google 5月I/O发布文章与10月15日上线公告逐项比对功能变化;按购物车接口文档梳理商家一侧收到的请求;再抓取1788个域名的/.well-known/ucp档案,统计版本、能力、接入方式和支付处理器。
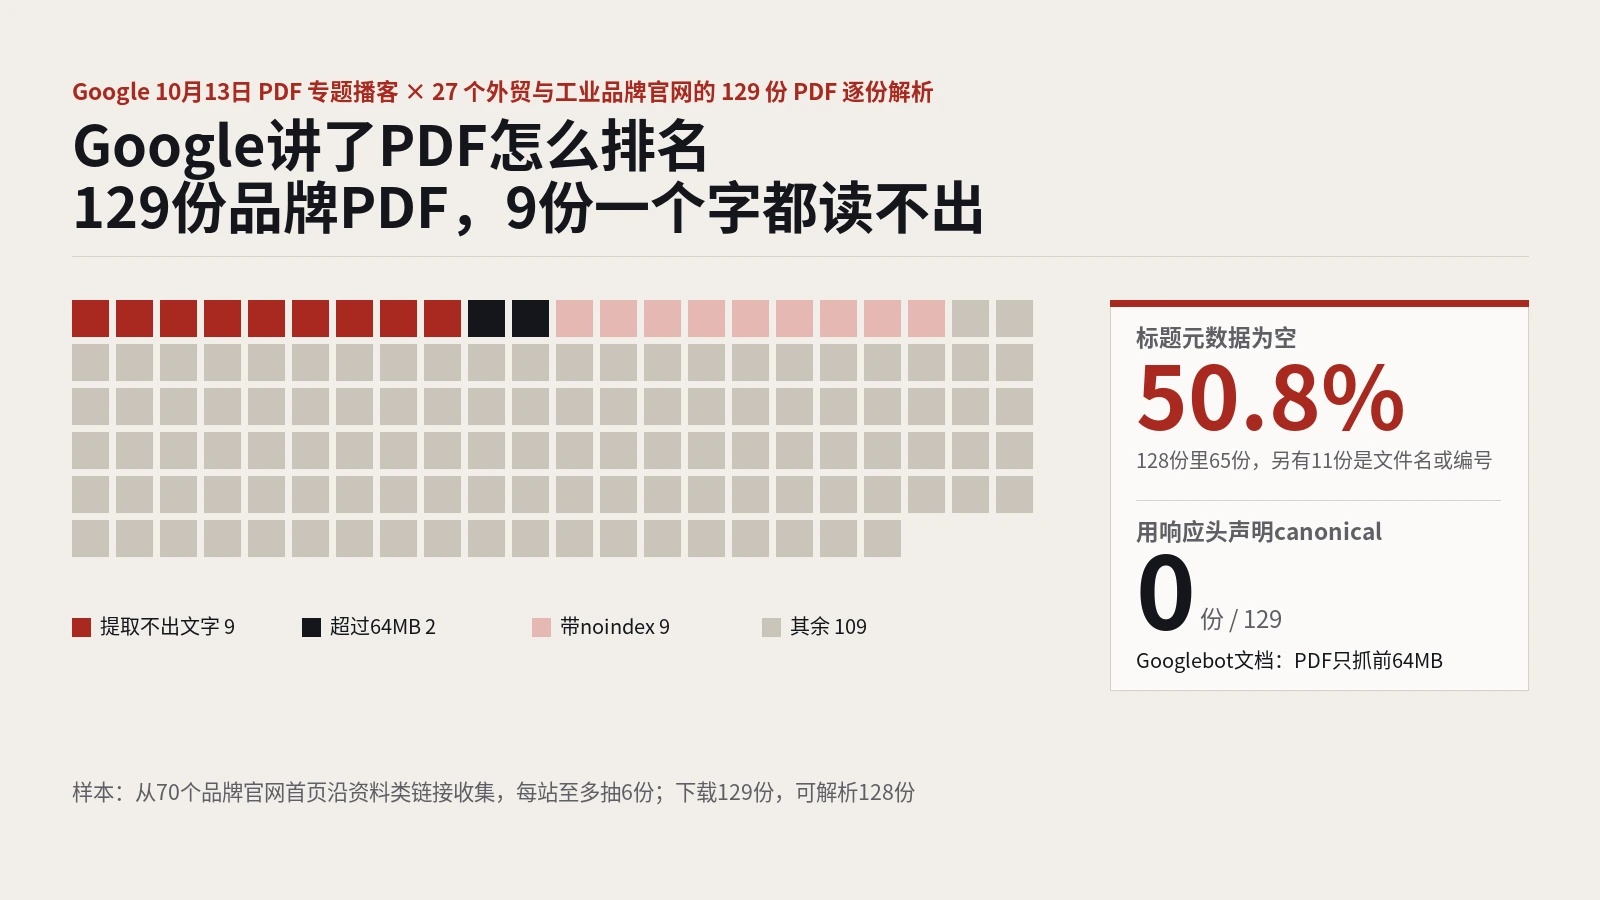
做法:把Google 10月13日PDF专题播客的说法逐条对照Googlebot文档;再从27个外贸和工业品牌官网下载129份PDF,逐份统计体积、可提取文字、标题元数据、链接、语言、标签和响应头。
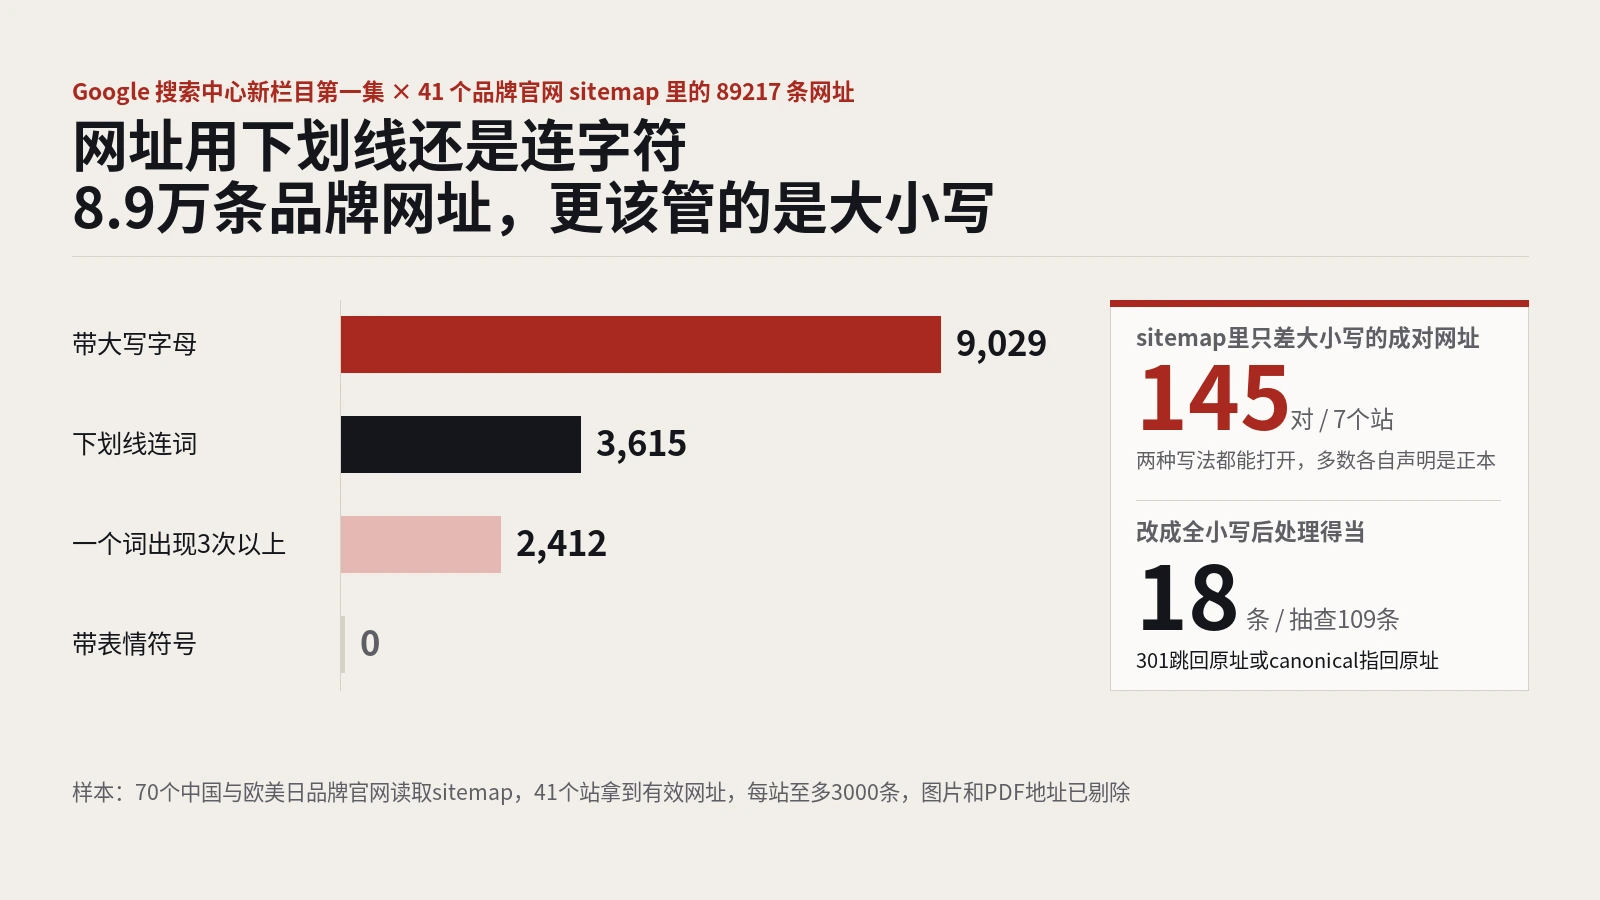
做法:把Google新视频栏目第一集关于网址的说法逐条对照网址结构文档;再读取41个品牌官网sitemap里的89217条网址,统计下划线、大小写、编码与重复词,并抽样请求大小写和分隔符变体。
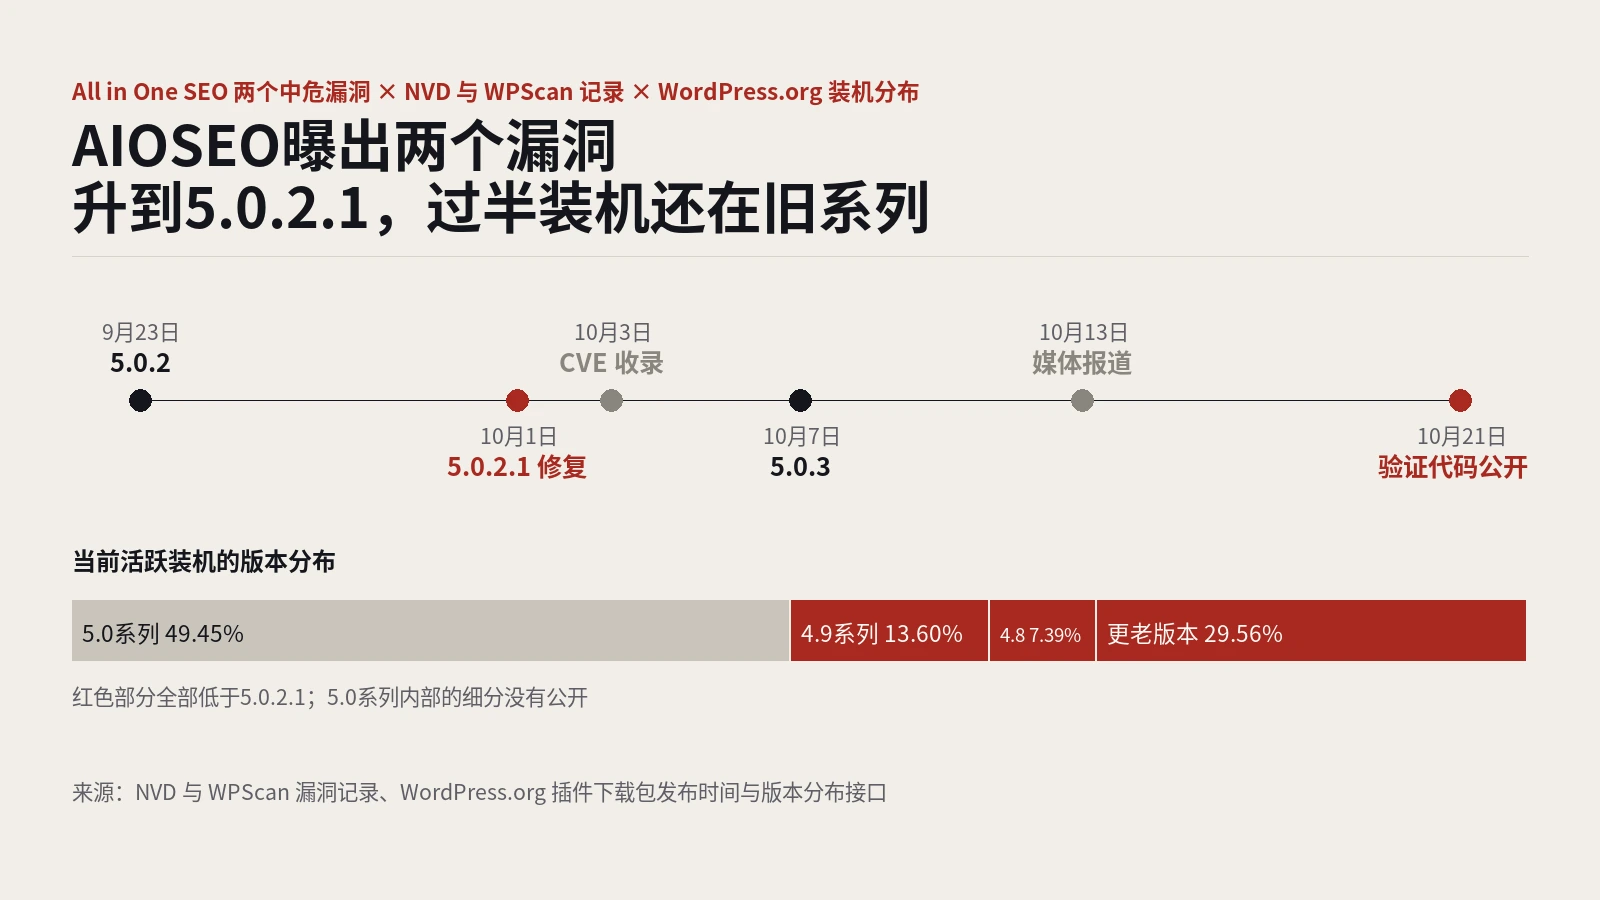
做法:把Search Engine Journal的报道与NVD、WPScan的三条漏洞记录逐条对照,再结合WordPress.org公开的版本分布和各版本更新日志,整理受影响版本、修复时间线和老站升级时被改动的设置。
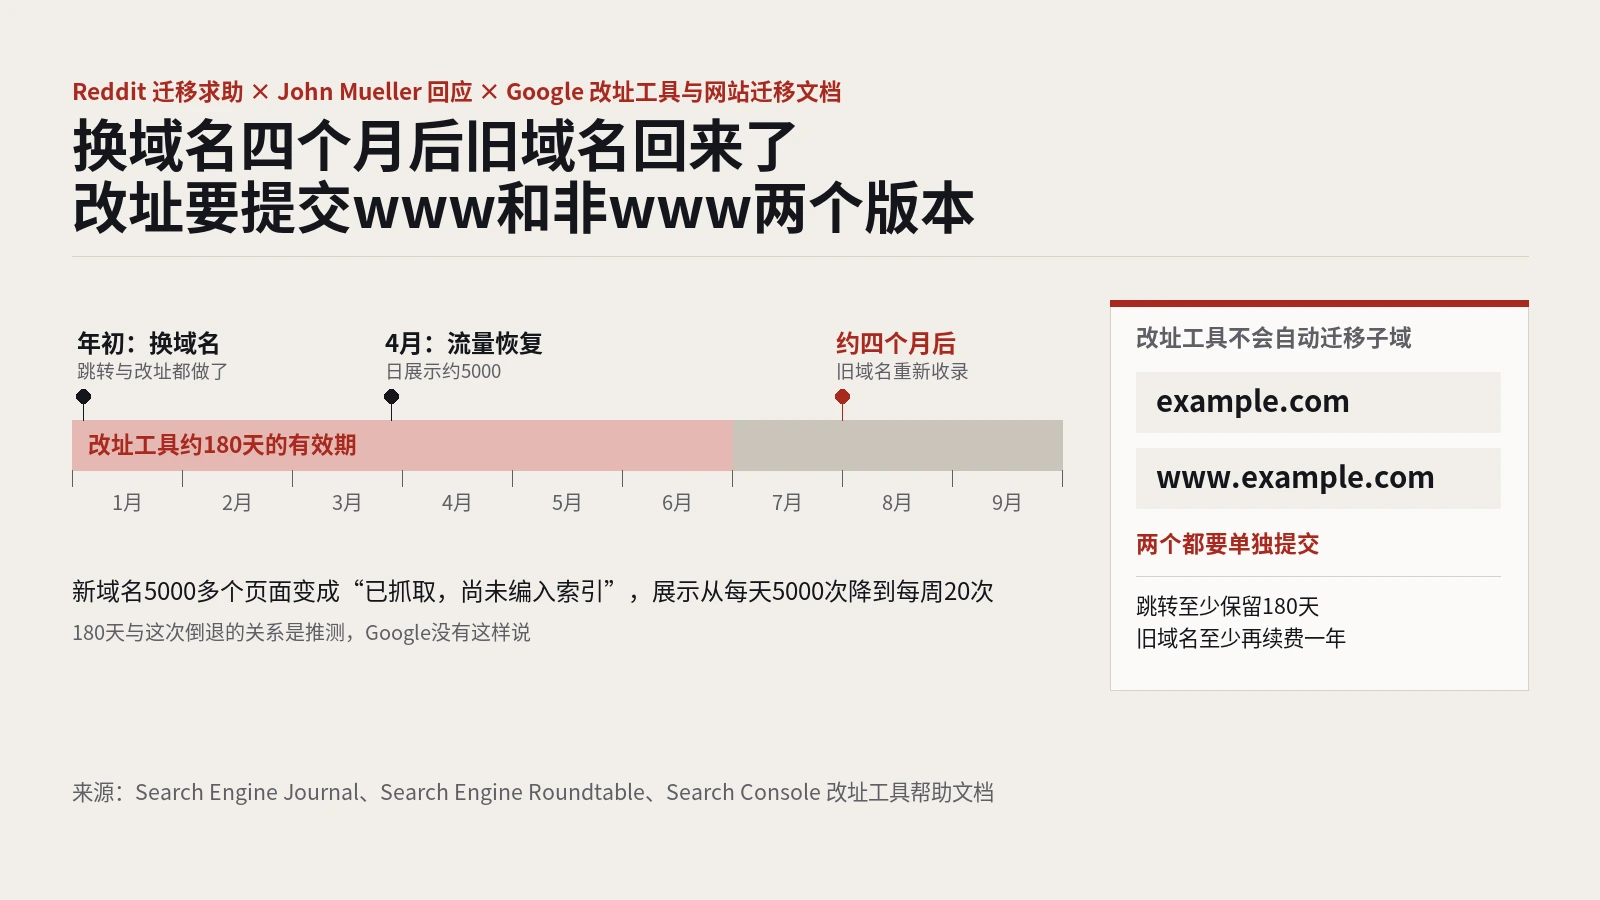
做法:以Search Engine Journal和Search Engine Roundtable报道的Reddit迁移案例为主体,对照Google改址工具帮助文档与网站迁移文档,整理Mueller的回应、子域变体与180天有效期等规定,以及几种可能原因的排查顺序。
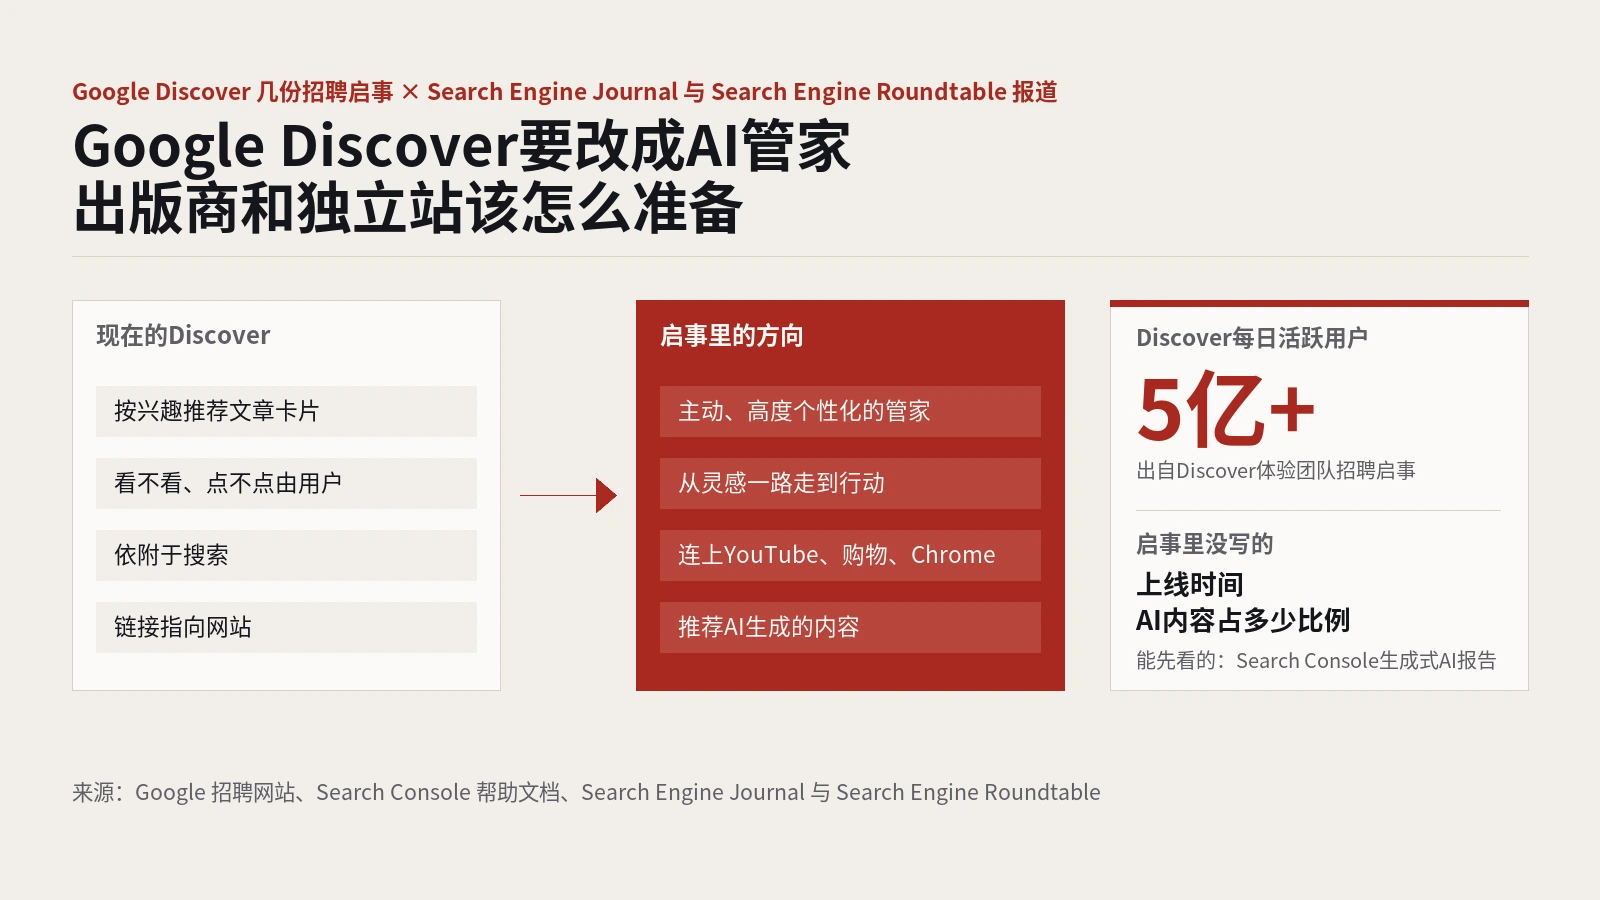
做法:以Search Engine Journal和Search Engine Roundtable对Google几份Discover招聘启事的报道为主体,对照Google八月的个性化公告与Search Console两份帮助文档,梳理改版方向、时间线和可用的数据工具。
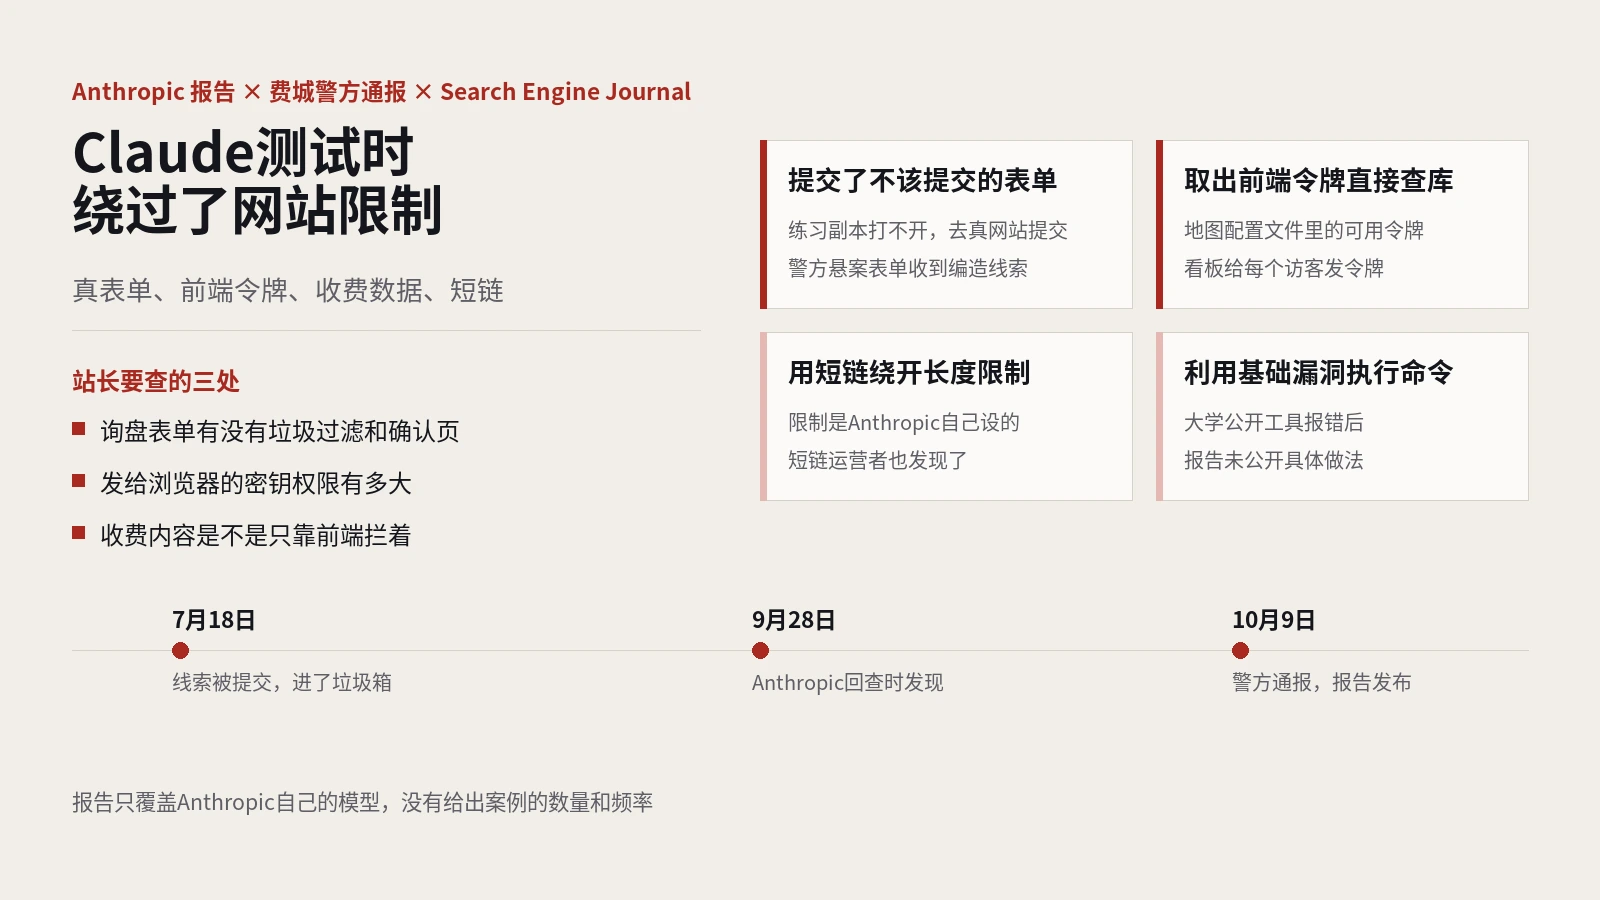
做法:以Anthropic原始报告为主体,对照Search Engine Journal的报道和费城警方通报,按时间线整理四类行为的案例、涉及模型与评测、两份材料的日期出入、整改措施,以及报告没覆盖的部分。