Caffeine是什么?Google于2010年上线的增量实时索引系统
本文目录
- Caffeine索引系统是什么?它解决了老索引的哪些问题?
- Caffeine之前的老索引怎么构建,为什么更新慢?
- Caffeine的增量索引具体是怎么实现的?
- Caffeine让索引速度提升了多少?索引规模有多大?
- Caffeine这个名称从何而来?为什么在2010年上线?
- Caffeine上线前后,站长能观察到哪些索引变化?
- Caffeine和抓取预算是一回事吗?
- Caffeine与内容新鲜度、QDF算法是什么关系?
- Caffeine位于抓取、渲染、索引流程的哪个环节?
- Caffeine加快索引后,是否应该让所有页面都进入索引?
- Caffeine能优化吗?站点能做什么让更新更快被收录?
- 常见问题解答
- Caffeine是排名算法吗?
- Caffeine现在还在用吗?
- 为什么新页面仍然收录得慢?
- Caffeine和移动优先索引是一回事吗?
- 了解Caffeine对SEO有什么实际用处?
- 能否通过频繁更新内容获得Caffeine的加分?
- 权威参考资料
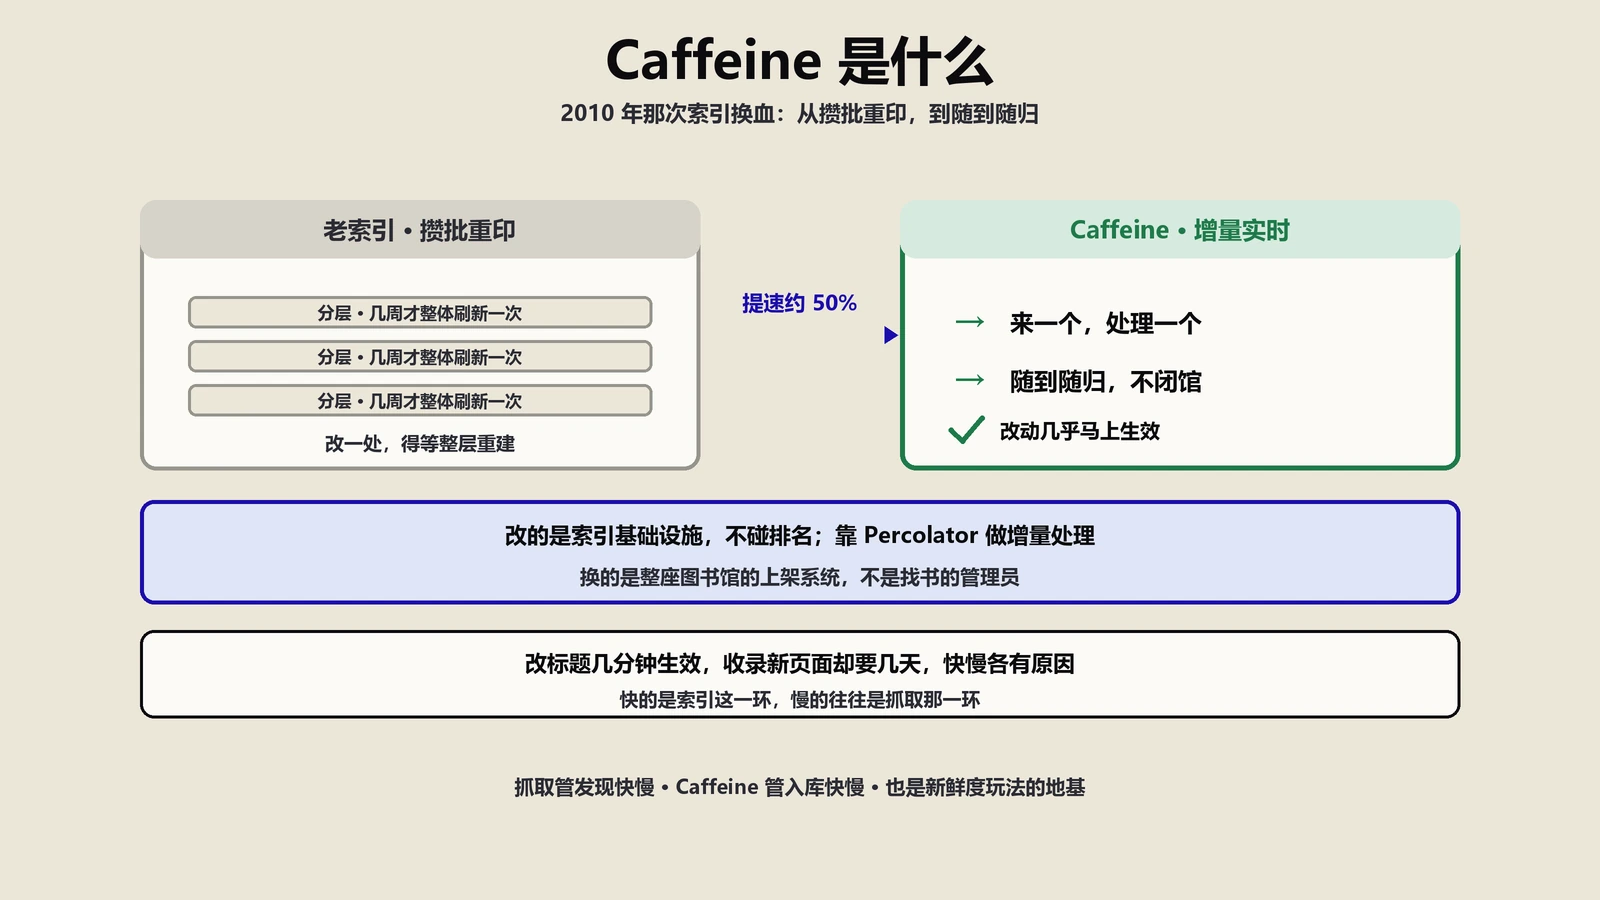
摘要:Caffeine是Google在2010年6月全量上线的新索引系统。老索引分层构建、每隔几周整层刷新,Caffeine改成连续的增量更新:发现一个新页面或一处改动,就单独抓取并入库,不必等整层重建。它让新内容进入索引的速度提升约五成,也是今天“秒收录”和新鲜度策略的基础设施。本文说明Caffeine是什么,它和抓取预算、新鲜度、渲染、索引膨胀的边界在哪里,以及站点层面能做哪些事。
一位做行业资讯的客户去年问过一个很具体的问题:他改一篇老文章的标题,Google快照几分钟就更新了;发一个全新页面,有时却要等好几天才被收录。他想不明白收录到底算快还是慢,为什么时快时慢。答案和一个2010年前后听着很新潮、如今很少有人提起的名字有关:Caffeine。
Caffeine索引系统是什么?它解决了老索引的哪些问题?
Caffeine是Google对索引系统的一次重构,2010年6月全量上线。它改的是排名算法底下那一层:搜索引擎如何整理、存储、持续更新抓回来的网页。如果把搜索引擎比作图书馆,排名算法相当于决定把哪本书推荐给读者的管理员,Caffeine替换的是整座图书馆的上架和归档系统,让新书能尽快、准确地上架并随时可借。书架上没有最新的书,管理员的推荐能力再强也用不上。
老系统的问题是慢,更新不及时。Caffeine之前,Google的索引分层构建,每层按不同频率整体刷新。一个页面要更新,往往得等它所在的整层重建一遍。网页每天都在变,索引却停在几周一次的刷新节奏上,面对越来越强调实时性的互联网,这套机制已经跟不上。
Search Engine Roundtable转述过 Google的Gary Illyes对Caffeine作用的解释,核心是让抓回来的内容更快进入索引。这个定位很准确:Caffeine不影响页面排第几,影响的是整套系统的运转速度和实时性。很多人一听到“Google更新”就担心排名变动,而Caffeine这类更新并不涉及排序,只让引擎运行得更快。区分清楚这一点,遇到波动时才不会错误归因。
Caffeine之前的老索引怎么构建,为什么更新慢?
可以用纸质百科全书做个粗略类比。编辑攒够一批词条后统一排版、统一印刷,出一个新版本;想加一个词条或改一处错误,只能等下一版整体重印。批处理的好处是规整,代价是延迟:两次印刷之间发生的变化,索引一概不知。
网页数量快速增长、内容更新越来越频繁之后,这种攒一批再统一处理的模式难以为继。用户要搜最新的新闻、股价、赛事比分,这些都等不了几周。Google需要一套“来一个处理一个”的机制,取代“攒一批统一翻新”。Caffeine就是为此开发的。
Caffeine的增量索引具体是怎么实现的?
Caffeine的核心变化是从批处理转向增量处理,底层依靠一套名为Percolator的技术。Google在那篇讲增量处理的研究论文里有详细说明:不再定期推倒重建整个索引,而是给数据加上事务和触发机制,哪条内容变了,只更新与它相关的一小块,其余部分不动。
换回图书馆的类比:老办法是定期闭馆盘点、整体重排;Caffeine不闭馆,新书到了就地上架,读者随时能借到最新的书。Google因此可以持续、小批量地把新页面和改动写入索引,不必等一个大版本。前面那位客户改标题几分钟就生效,就是增量索引在起作用。
增量处理还有一个常被忽略的好处:成本低。整体重建一次索引要消耗大量算力和时间,增量处理只处理变化的部分,边际成本低得多。Caffeine之后Google能持续扩大索引规模,原因在于处理方式从“每次全量翻新”变成了“只处理变化的部分”。成本降下来,现代搜索引擎才能在收录海量网页的同时保持近乎实时的更新,这在批处理时代无法实现。
Caffeine让索引速度提升了多少?索引规模有多大?
据 Search Engine Land当年对Caffeine上线的报道,Google公布的数字是:与上一代索引相比,新内容进入索引的速度提升约百分之五十。规模方面,它每秒处理海量网页,索引库以PB计,每天新增数十万GB的信息。这次升级相当于换了一台发动机,而不只是把旧引擎调快一挡。
对站点运营者来说,这意味着:只要内容值得抓取并已被Google发现,它进入索引、更新索引的速度比十几年前快得多。今天习以为常的“发布后就能搜到”,在Caffeine之前很难做到。
Caffeine这个名称从何而来?为什么在2010年上线?
Caffeine就是“咖啡因”,取“更快、更提神”的意思,是Google内部给这个提速项目起的代号。Ahrefs的词条把 Caffeine定义为一次以速度和新鲜度为目标的索引更新,重点在速度和新鲜度。
选在2010年,是因为那几年社交媒体、实时资讯和博客迅速增长,Twitter这类平台让“正在发生的事”成了搜索的刚性需求。用户不再满足于几周前的旧网页,老索引攒批重印的节奏明显落后。Google经过一段时间的预览和测试,于2010年6月全量推出Caffeine,替换了整套索引。它是互联网内容更新加速倒逼出来的结果。
Caffeine上线前后,站长能观察到哪些索引变化?
最直观的变化,就是开头那位客户遇到的“改动几乎马上生效”。老索引时代,改了标题或正文,要等该层下一轮重建才可能反映到搜索结果里,快照可能几周不变。Caffeine之后,只要页面在被正常抓取,改动通常很快就能同步。
另一个变化是新内容的整体流转加快。全网内容能以接近实时的方式进入索引,抢时效、做资讯、追热点这类策略从此有了技术基础。Search Engine Journal在梳理Google算法史时把Caffeine列为一次里程碑式的基础设施更新,原因也在于此:它不是让部分网站排名涨跌的调整,而是支撑此后十几年实时搜索的底层架构。
Caffeine和抓取预算是一回事吗?
不是,这两个概念最容易混淆。抓取和索引是两个环节:抓取是Googlebot访问站点、把页面取回;索引是把取回的内容整理入库,使其可被搜索到。抓取预算讲的是Google愿意花多少精力来爬你的站,决定抓多少、抓多频繁;Caffeine负责的是抓回之后,如何快速、实时地建入索引。
据此就能解释开头客户的疑问:改老页面标题几分钟生效,是因为Google早已发现并持续抓取这个页面,改动一到,Caffeine立即增量更新;全新页面要等几天,瓶颈通常不在索引,而在抓取,即Google还没发现它、还没安排抓取。前者是入库快,后者是发现慢,属于两个环节。
Caffeine与内容新鲜度、QDF算法是什么关系?
Caffeine是新鲜度策略的基础。新鲜度和QDF机制讲的是哪些查询、哪些页面该给更新的内容更高的权重,属于排名层面的判断;Caffeine保证新内容能近乎实时地进入索引,让这种判断有数据可用。如果索引仍是几周刷新一次,算法即使想给新内容加分,库里也没有新内容可加。
两者的先后关系是:Caffeine先在基础设施层解决实时入库,QDF这类新鲜度机制才能在排名层发挥作用。前者是地基,后者是建在地基上的楼,不要混为一谈。
这层关系还能纠正一个常见误解:只要发得勤、更新得快,Google就会因为内容“新鲜”多给流量。实际上,Caffeine保证新内容能快速入库,QDF决定的是某个查询是否需要新内容。搜索“怎么系鞋带”这类常青问题不看新鲜度,更新再频繁也不会加分;只有新闻、版本、赛事、政策变动这类天然求新的查询,新鲜度才有价值。先判断哪些内容值得持续更新、哪些适合做常青内容,比一味求快更重要。
Caffeine位于抓取、渲染、索引流程的哪个环节?
Google处理一个页面,大致分三步:抓取、渲染、索引。在从抓取到渲染DOM再到索引的完整流程中,Caffeine负责最后一个环节:把渲染和解析完成的内容高效存入可检索的索引库,并保持更新。抓取决定Google什么时候拿到页面,渲染决定Google实际看到页面上的哪些内容,Caffeine决定这些内容多快能被搜到、改动多快能同步。三个环节各负责一段,缺一不可。
Google搜索中心的 搜索工作原理文档对这条流程有明确说明:抓取、索引、提供结果是三个独立阶段,各有各的规则和瓶颈。诊断问题时要先定位卡在哪个环节:没被抓取、抓取后没入库,还是入库后排名上不去。三个问题混在一起,就找不到真正需要修复的地方。Caffeine基本把“入库慢”从排查清单里排除了,剩下的排查范围会清楚很多。
Caffeine加快索引后,是否应该让所有页面都进入索引?
不应该。Caffeine让入库更快、更实时,但不判断页面是否值得留在索引里。如果借着收录快,把大量薄内容页、重复页、参数页都推进索引,带来的不是流量,而是索引膨胀这种拖垮整站的毛病。
能被快速收录和应该被收录是两个问题。Caffeine解决的是速度,页面该不该进索引、进去后有没有价值,取决于站点自身的内容质量和结构。技术放宽了入口,不等于应该把低质量页面堆进去。
一个反面案例:某电商站认为收录快,就把成千上万个筛选组合、排序参数生成的URL全部开放给Google抓取。短期内收录数快速上涨,站长还很满意;半年后流量不升反降,排查发现Google的抓取资源被大量无人搜索的低质量页面分散,真正重要的产品页反而得不到足够关注。收录速度在这里放大了问题。
因此,不要把Caffeine的速度当成放开收录的理由。它提高的只是上架速度,货架上放什么,始终由站点自己负责。
Caffeine能优化吗?站点能做什么让更新更快被收录?
Caffeine本身无法优化,它是Google的内部基础设施,没有留给站点的调节项。站点能做的,是让Google更快、更顺利地拿到更新。具体有以下几条:
- 保持sitemap干净、lastmod准确。页面改了就如实更新lastmod,不要乱标,让Google知道哪些页面确实有变化、值得重新抓取。
- 用内链帮助新页面被快速发现。新页面不要成为孤岛,从已被频繁抓取的老页面加链接过去,Google顺着链接就能更早找到它。抓取环节快了,Caffeine的索引环节自然能接上。
- 不要靠改日期伪造新鲜度。只改时间戳、内容一字未动,这种假更新Google早能识别,不但无效,做多了还可能引起怀疑。只有实质内容改动,Caffeine才会实时同步。
- 服务器不要拖后腿。抓取慢、超时多,会堵塞整条流程,前一个环节卡住,后面的环节再快也没用。
那位资讯客户后来按这几条做了调整:理顺sitemap,从首页和栏目页给热点文章足够的内链,老页面只在真正更新时才改lastmod。结果,他最关心的时效类内容从发布到可被搜索的时间明显缩短;没有实质更新的老页面,他也不再频繁修改时间戳。技术问题和内容问题各自归位后,管理反而更简单。
他后来说,以前总觉得收录很玄,全凭运气;弄清抓取和索引各负责一段之后,才发现收录的快慢都有原因,找准环节就能对症处理。
常见问题解答
Caffeine是排名算法吗?
不是。Caffeine是索引系统,负责网页的存储和更新,不直接决定排名先后。它影响的是内容多快进入索引、改动多快同步,属于基础设施,不是排序规则。把它和熊猫、企鹅这类排名更新区分开,就不会错误归因。
Caffeine现在还在用吗?
它早已成为Google索引体系的一部分,只是“Caffeine”这个名称如今很少被单独提起。和蜂鸟一样,它没有被淘汰,而是融入了引擎的底层架构。今天的实时索引能力就源自它。
为什么新页面仍然收录得慢?
瓶颈多半在抓取,而不是索引。Google要先发现并抓取页面,才能入库。可以检查是否有内链指向、是否已加入sitemap、robots是否误拦截、服务器响应是否够快,这些是新页面收录慢的常见原因。
Caffeine和移动优先索引是一回事吗?
不是。Caffeine是2010年的索引架构升级,解决的是速度和实时性;移动优先索引是后来Google改用移动版页面抓取和建立索引的政策调整,解决的是用哪个版本入库。前者关乎索引建得多快,后者关乎用哪份内容建索引,两者不要混淆。
了解Caffeine对SEO有什么实际用处?
用处在于面对收录时快时慢不再靠猜。更新生效快是因为增量索引,新页面收录慢通常是抓取没跟上。诊断时能迅速分清是发现环节的问题还是入库环节的问题,少走很多弯路。
能否通过频繁更新内容获得Caffeine的加分?
为了更新而更新没有意义。Caffeine只负责让真实的更新快速同步,不会因为频繁修改时间戳就加分。有实质价值的更新会被及时同步;没有实质内容的高频改动,对排名没有帮助。想让更新产生回报,应该补充数据、增加案例、修正过时的说法,而不是把发布日期往后挪,Google早已能识别这种做法。
权威参考资料
本文标题:《Caffeine是什么?Google于2010年上线的增量实时索引系统》
本文链接:https://zhangwenbao.com/google-caffeine-real-time-indexing-explained.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0