英译中本地化基准:人工校对过的AI在6类内容里赢了4类,SEO文案人工只领先2.8分
本文目录
- 这个基准测试是怎么做的?
- 翻译、创译和创作差在哪
- 人工翻译在哪几类内容上输给了AI?
- SEO文案:人工第一,但只领先2.8分
- 为什么国产大模型这个平均分没有参考价值?
- 人工校对是不是越多越好?
- 翻译质量高,排名就会好吗?
- 百度那边,翻译质量往往不是卡脖子的地方
- 做多语言内容的团队能直接用的做法
- 按具体模型比,别按类别比
- 按内容类型分配工作流
- 先把术语库建起来
- 给本地化页面打标签,让自己的数据回答排名问题
- 自己跑一轮比选
- 反过来做中译英,能不能照搬
- 这项测试有哪些地方要打问号?
- 常见问题解答
- 这项本地化基准测试是谁做的?
- 测试的是哪个翻译方向?
- SEO文案用AI翻译可以吗?
- 为什么人工翻译营销文案得分最低?
- 人工校对一定能提高AI译稿的质量吗?
- 国产大模型和海外大模型哪个翻译更好?
- 译后编辑是什么意思?
- 为什么Google翻译加人工校对在SEO文案上表现不错?
- 创译和翻译有什么区别?
- 这个测试结果多久会过时?
- 测试了哪些模型?
- 翻译质量分数高能带来更好的排名吗?
- 人工翻译还值得请吗?
- 做百度SEO先抓翻译质量还是先抓备案?
- 团队怎么自己做翻译模型比选?
- 权威参考资料
摘要:本地化服务商EC Innovations和Jademond Digital做了一项英译中基准测试,774份译稿按六类内容、十五种工作流盲评打分。专业人工翻译只在信息类和SEO文案两类拿第一,SEO文案上只比人工校对过的通义千问、豆包高2.8分;营销文案人工排第10,落后最好的AI工作流22.2分。更值得带走的发现在后面:同一类大模型内部的差距最多22.3分,比人工和机器的差距还大,选对模型比加不加人工校对更要紧。测试只量了翻译质量,没有任何排名或转化数据,模型版本停在2025年12月,出资方本身卖本地化服务。
做多语言站的团队,几乎都吵过同一件事:译稿到底让人翻,还是让AI翻再找人改?贵的那个一定好吗?
Search Engine Journal在9月28日刊登了一篇英译中本地化基准测试的解读,作者Marcus Pentzek是Jademond Digital的合伙人,长期做中国市场SEO。数据给出的答案有点扎心:在六类内容里,专业人工翻译有四类没进前五。这篇以那篇文章为主体,把测试怎么做、结论是什么、哪些地方要打问号讲清楚,再说说国内做多语言内容的团队能从里面拿走什么。
这个基准测试是怎么做的?
先交代出处和利益关系。按SEJ文章的披露,这项研究是本地化服务商EC Innovations和Jademond Digital的联合项目,两家公司都在卖和测试内容相关的服务。作者自己也说,读这篇要带着这个背景。
测试的规模和设计如下。
| 项目 | 内容 |
|---|---|
| 方向 | 英语译成中文 |
| 样本量 | 774份本地化产出 |
| 内容类型 | 六类:信息类、SEO文案、技术文档、产品界面、用户生成内容、营销文案 |
| 任务类型 | 三种:翻译、创译(按目标市场改写)、直接创作 |
| 工作流 | 人工;国产大模型直出与人工校对;海外大模型直出与人工校对;机器翻译直出与人工校对,合计15种 |
| 测试的模型 | ChatGPT(GPT-5.2)、Gemini 3.0、豆包1.6、通义千问Qwen 3、Kimi K2、DeepSeek-V3.2、Google翻译,都通过网页界面使用 |
| 打分维度 | 准确与一致、流畅与语言质量、风格与文化适配,各占三分之一 |
| 评分方式 | 以中文为母语的专业本地化人员盲评,不知道哪份出自谁;评分人和产出人工译稿、校对稿的不是同一批人 |
翻译、创译和创作差在哪
三种任务类型的区别,决定了谁更占便宜。翻译要求忠实原文,句子怎么说基本照着来;创译允许为目标市场改写,原文一句双关的英文口号,可以换成中文读者能会心一笑的说法,只要传达的意思和效果到位;创作则是给定要点直接用中文写。越往后,留给写作者的发挥空间越大,也越考验对当下中文语感的把握。
SEJ文章没有把三种任务类型的结果分开公布,只按内容类型排了名。不过营销、社交这类内容天然更接近创译,人工在这几类上失分多,和前面说的过度修正对得上。
文中的PE指译后编辑,就是AI或机器先出稿,再由专业译员改一遍。下面说的人工校对版,都是这个意思。
时间线也要记住:译稿在2025年12月到2026年1月产出,盲评一直做到3月初,中间正好赶上春节;分析和写报告拖到5月底,6月5日发布完整报告。所有模型都停在2025年12月那个版本。
人工翻译在哪几类内容上输给了AI?
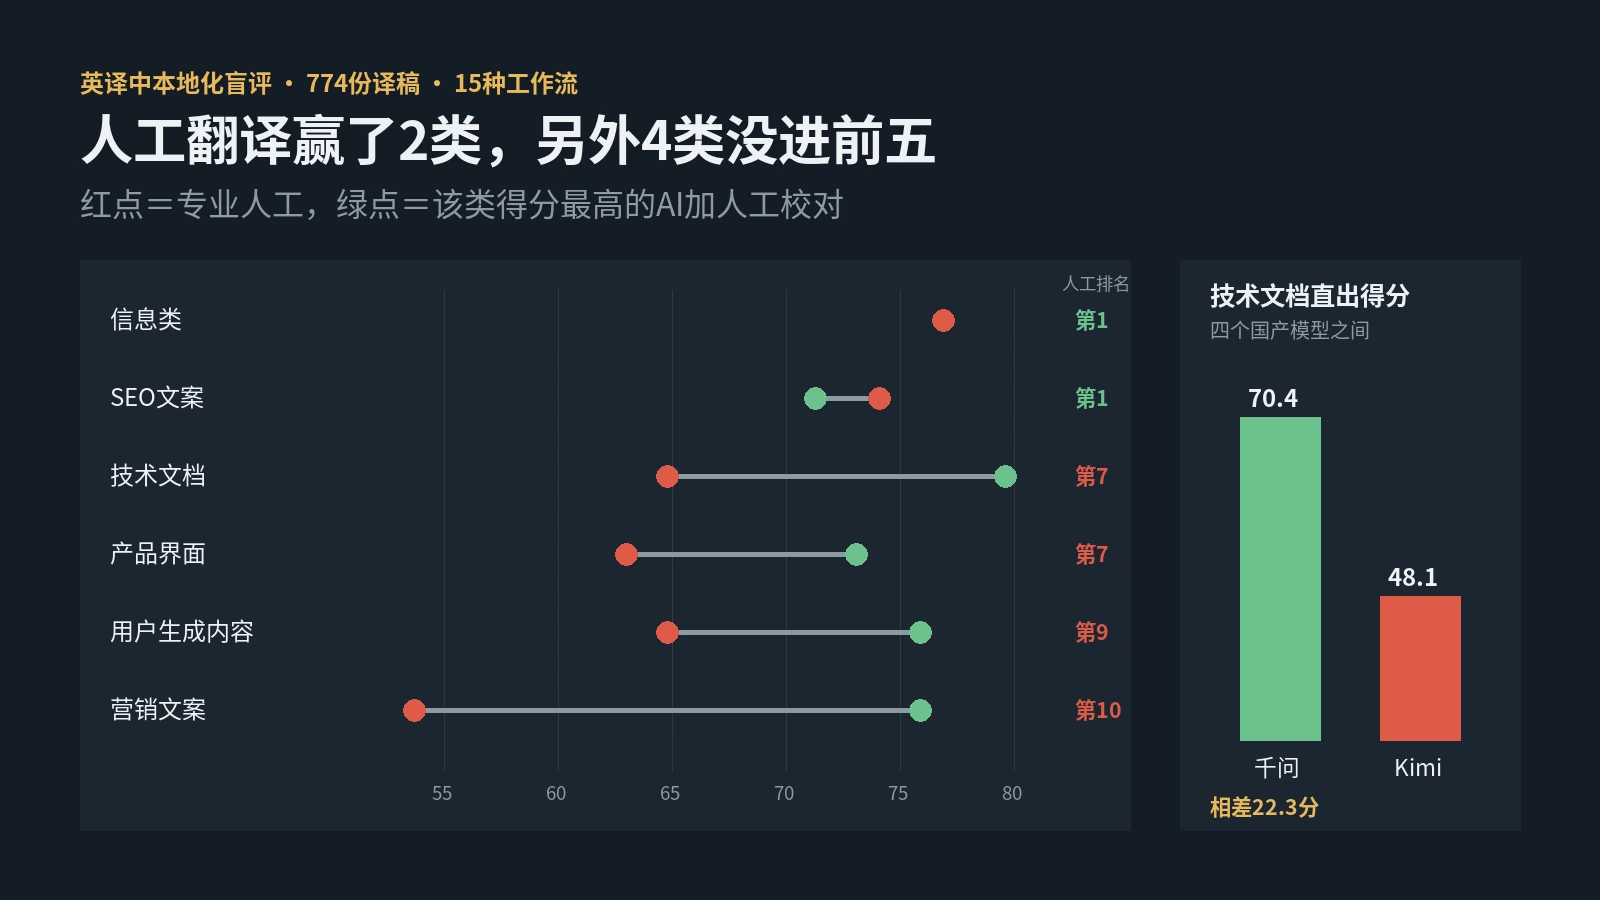
按内容类型排名,人工的成绩单是这样的。
| 内容类型 | 人工得分 | 人工排名(共15) | 第一名 |
|---|---|---|---|
| 信息类 | 76.9 | 第1 | 人工(76.9) |
| SEO文案 | 74.1 | 第1 | 人工(74.1) |
| 技术文档 | 64.8 | 第7 | 千问加人工校对(79.6) |
| 产品界面 | 63.0 | 第7 | 千问加人工校对(73.1) |
| 用户生成内容 | 64.8 | 第9 | 豆包或千问加人工校对(75.9) |
| 营销文案 | 53.7 | 第10 | 千问加人工校对(75.9) |
把差距也算出来,读起来更直观:技术文档人工落后第一名14.8分,产品界面落后10.1分,用户生成内容落后11.1分,营销文案落后22.2分;人工领先的两类里,SEO文案只领先2.8分,信息类领先多少原文没有给出第二名的分数。
人工赢了两类,另外四类都在前五之外。营销文案最惨,排第10,比千问加人工校对低22.2分。千问加人工校对拿了三个第一,并列一个第一,剩下两类都是第二。
人工为什么在营销文案上输得这么狠?EC Innovations的解读是:专业译员习惯把语言往规范、正式的方向修,把营销文案赖以成立的那股网感、那种当下的说话方式给磨掉了。让一个人在术语一致上表现出色的那种本能,放到需要像互联网一样说话的文字上,反而碍事。
做过品牌出海的人,对这一条应该不陌生。一句英文slogan,译员给你一句挑不出语病的中文,就是没人想转发。
作者的总结是:人工的优势很明确,只在一种内容上,事实精度和术语一致说了算、几乎没有创作空间的那种。信息类和SEO文案符合这个描述,营销、界面、社交内容都不符合。在后几类上付专业翻译的价钱,买到的是更差的结果。
SEO文案:人工第一,但只领先2.8分
做SEO的人最关心这一类,作者也给了比完整报告更细的分模型排名。这里的SEO文案指元描述、标题和带关键词的正文。
| 排名 | 工作流 | 得分 |
|---|---|---|
| 1 | 专业人工 | 74.1 |
| 2 | 豆包加人工校对、千问加人工校对 | 71.3 |
| 4 | DeepSeek、Gemini、Google翻译加人工校对 | 66.7 |
| 7 | ChatGPT加人工校对、千问直出 | 65.7 |
| 9 | ChatGPT直出 | 62.0 |
| 10 | DeepSeek直出、Kimi加人工校对 | 61.1 |
| 12 | 豆包直出、Gemini直出 | 59.3 |
| 14 | Kimi直出 | 56.5 |
| 15 | Google翻译直出 | 55.6 |
人工第一,可和最好的AI工作流只差2.8分。每个分数是三个维度的平均,作者说,不到3分的差距,他不会在没有自己复测的情况下拿来做一笔六位数的采购决定。他的判断是:在SEO文案上,人工校对过的千问或豆包,和专业人工大致持平;任何模型的直出稿都还差得远。
表里还有一个容易被忽略的点:Google翻译加人工校对拿了66.7分,比千问直出还高,比测试里所有直出的大模型都高。作者的建议是,如果你已经有成熟的机器翻译流程,配了翻译记忆库和术语库,在上面加一层人工校对,比推倒重来换成大模型直出走得更远。
为什么国产大模型这个平均分没有参考价值?
这一段是整篇文章最有用的部分。
在SEO文案上,国产大模型直出的平均分是60.7,海外大模型直出的平均分也是60.7,人工是74.1,差13.4分。很多人看到这里就会下结论:AI直出不行,国产和海外半斤八两。作者说,这个数作为采购依据几乎没有意义。
| 分组 | 模型 | SEO文案直出得分 |
|---|---|---|
| 国产大模型(平均60.7) | 通义千问 | 65.7 |
| DeepSeek | 61.1 | |
| 豆包 | 59.3 | |
| Kimi | 56.5 | |
| 海外大模型(平均60.7) | ChatGPT | 62.0 |
| Gemini | 59.3 |
原因在于平均数背后的分布。国产这一组是四个模型的平均:千问65.7、DeepSeek 61.1、豆包59.3、Kimi 56.5,最高最低差9.2分。海外这一组只有两个:ChatGPT 62.0、Gemini 59.3。两组平均分一样,里面的情况完全不同。
SEO文案还是分歧最小的一类。到了技术文档,四个国产模型从千问的70.4到Kimi的48.1,差了22.3分;营销文案差22.2分。海外两个模型之间,六类内容里最大的差距只有8.4分,出现在信息类。
作者的说法很直接:没人部署国产大模型这个东西,大家部署的是千问、豆包或者DeepSeek。国产大模型的平均分,描述的是一个不存在的模型。如果你已经定了用GPT或Gemini,海外大模型这个说法大体还算诚实;国产这一组,最好和最差相差二十多分,你选的那个可能落在任何一头。
还有一个细节:Kimi在六类内容里都是国产四个中的最后一名。把它去掉,国产组的平均分会按类别上升1.3到4.9分。任何企业做两周的内部比选,第一周就会把它淘汰,可它一直在拉低整个类别的平均分。作者也说明,按类别等权平均本身是正确的统计做法,问题出在读数的人怎么用这个数。
直出稿里也有例外:Gemini在用户生成内容上直出拿了67.6分,是这类内容里唯一一个海外模型直出就超过全部国产模型直出的情况。
人工校对是不是越多越好?
大家通常把人工校对当成一层质量保险:买了就加分,不买就扣分。数据说不是这么回事。
人工校对带来的提升,平均是5.6分,但分布极不均匀。
- 用户生成内容上,给Google翻译的直出稿做人工校对,从33.3分涨到63.9分,提升30.6分,是整个测试里最大的一次变化。非正式的社交语言,机器直译出来几乎没法用,改一遍效果立竿见影。
- 营销文案上,给海外大模型的稿子做人工校对,平均反而降了0.9分。
- 有三个组合越改越差:ChatGPT加人工校对的营销文案降3.7分,Kimi加人工校对的营销文案降2.8分,ChatGPT加人工校对的技术文档降0.9分。
- 同样是技术文档,千问加人工校对提升了9.3分。
作者的解释是:决定校对价值的,是你交给编辑的那份初稿离正确有多近。离得近,编辑一改就提分;错得离谱,编辑的预算就花在和初稿较劲上。如果校对的人带着错误的语体去改,比如把营销文案改得一本正经,或者不懂技术就去改技术文档,人工那一遍就是在毁稿子。这和前面人工翻译营销文案得分低,是同一个毛病。
作者还坦白自己一开始也读反了。他原本从类别平均分出发,以为加不加人工校对比选哪个模型更重要。细看数据之后结论倒过来:校对平均只提升5.6分,同一类内容里国产模型之间能差22.3分,选千问还是选Kimi,比要不要做人工校对是更大的决定。
翻译质量高,排名就会好吗?
不知道,这项测试也回答不了。
作者在文章里专门写了一节来泼冷水:他们只测了本地化质量,一个搜索排名都没追踪,谁拿这22分或2.8分的差距去说排名效果,都是越界。内容质量指标和排名之间的公开证据,比行业愿意承认的要薄。他引用了Portent在2021年的研究:抓取75.6万多个有排名的页面,没有发现可读性和Google排名位置之间的相关性。Portent还点名批评过一种循环论证:卖内容质量的公司说内容质量驱动排名。作者承认,这个批评同样适用于本地化公司出资的研究。
所以这篇文章里的所有数字,最多算一个值得自己去验证的假设。
百度那边,翻译质量往往不是卡脖子的地方
作者做中国市场多年,他补了一段:E-E-A-T是Google的框架,搬不到百度身上。百度更看重站点层面的信号,比如域名历史、ICP备案状态、服务器所在地。服务器放在境外,访问要过境,速度慢,百度对慢站不友好。一个ICP备案,加上境内或香港的主机,对百度可见度的帮助,可能比译稿从60.7分提到74.1分还大。
翻译质量照样要紧,只是顺序要排对。备案和主机没解决,就花大价钱把千问校对稿升级成全人工翻译,等于在一个还没拆掉的限制上做优化,而且这是两个办法里更贵的那个。主机和备案怎么权衡,站内整理过国内外主机的备案、延迟与抓取的对比。
做多语言内容的团队能直接用的做法
作者在文末给了几条建议,下面按原意整理,再补上国内团队落地时会碰到的细节。
按具体模型比,别按类别比
别再评估国产大模型或海外大模型这种类别,拿千问、豆包、DeepSeek在你自己的内容上一对一比。同类模型之间的差距,比人工和机器之间那个被讨论最多的差距还大。
按内容类型分配工作流
- 核心的SEO页面和信息类内容,用人工翻译,或者千问、豆包加人工校对,两者差距小,成本和交付时间决定选哪个。
- 营销文案、产品界面、技术文档、社交内容,数据显示付人工翻译的价钱换来的是更差的结果,这四类千问加人工校对都领先。
- 已经有成熟机器翻译流程的,先加人工校对,再考虑换平台。Google翻译加人工校对在SEO文案上的66.7分,超过了测试里所有直出的大模型。
落到一个独立站上,可以先把页面按这六类对号入座:博客和指南大多属于信息类和SEO文案;分类页、商品页的标题和描述属于SEO文案,规格参数表更接近技术文档;按钮、菜单、结账流程的提示语是产品界面;买家评论、问答区是用户生成内容;活动落地页、广告语、邮件标题是营销文案。同一个站里,不同页面适合的工作流可以不一样,没必要一刀切地全用人工或全用机器。
对号入座之后,预算的分配也就清楚了:人工的钱集中花在核心SEO页面和信息类长文上,其余几类交给选好的模型加校对,省下来的钱可以用在术语库和抽检上。
先把术语库建起来
在SEO文案上,直出稿最稳定的失分点是术语不一致。一份术语表是控制这个问题最便宜的手段,而且不管你接下来两年换几次模型,它都能接着用。术语表做好了,对站内的主题权威也有帮助,可以参考术语库定义页怎么搭。
给本地化页面打标签,让自己的数据回答排名问题
按工作流给本地化页面打标签,人工的、千问校对的、机器翻译校对的分开记,两个季度后,你自己的分析数据就能回答这项研究回答不了的问题:在你的行业、你的竞争对手面前,哪种做法排得更好、转化更高。翻译内容在AI检索里还有它自己的问题,站内那篇多语言AI可见性讲过。
自己跑一轮比选
作者最后说,这项研究最能留下来的结论跟用不用千问没多大关系:单个模型在你那类内容上的差异,大到值得自己测。一份几个月就过时的基准,恰好说明该自己动手跑,别等别人的。拿三四个候选模型,在有代表性的自有内容上做两周内部比选,得到的信息比任何公开基准都多,包括这一份。跑完,六个月后再跑一次。
照着这项测试的设计,内部比选可以这样搭:从每类内容里各抽一批有代表性的原文;每个候选模型出直出稿和校对稿;评分用同样的三个维度,各占三分之一;评分人不知道稿子出自谁,也不参与产出;最后按内容类型分别看排名,别只看总分。
评分表可以参考下面这个结构,三个维度和这项测试一致,看什么、怎么扣分按自家内容细化。
| 维度 | 看什么 | SEO页面上常见的扣分点 |
|---|---|---|
| 准确与一致 | 意思有没有译错,术语前后是否统一 | 同一个产品名一页里出现两种译法,参数单位换错,关键词被换成了同义但没人搜的说法 |
| 流畅与语言质量 | 读起来像不像母语者写的,语法和标点 | 翻译腔长句,英文语序照搬,中英文标点混用 |
| 风格与文化适配 | 语气是否符合品牌和渠道,例子和习惯是否本地化 | 营销页写成说明书,节日、度量衡、支付方式没换成目标市场的习惯 |
评分前先让两三个评分人拿同一批样稿试打一轮,对一对分,差得太远就先统一标准再正式开始。否则最后几分的差距,分不清是稿子的差别还是评分人的差别。
反过来做中译英,能不能照搬
国内外贸团队更常见的方向是中译英,这项测试没有覆盖。语言方向一换,哪个模型强、人工校对值不值,都可能变,不能把英译中的排名直接套过去。能照搬的是方法:按具体模型、按内容类型、盲评、看分布别看平均。
这项测试有哪些地方要打问号?
作者自己列了几条,读的时候要一起记住。
- 出资方利益相关:两家公司都卖本地化相关的服务,作者是其中一家的合伙人。
- 只量质量不量效果:没有排名、流量或转化数据。
- 版本过时:所有模型都是2025年12月的版本,作者明说,在这个领域几个月前的快照就是历史文件,千问、豆包、GPT和Gemini之后都发了新版,上面的具体排名可能撑不过新版本。
- 使用方式:模型都通过网页界面使用,和企业通过接口、加了提示词和术语表的生产流程不一样。
- 任务类型没拆开:翻译、创译、创作三种任务各自的结果没有单独公布,没法判断AI的优势主要来自哪一种。
- 细分数据未公开:文章里的分模型数据比已发布的完整报告更细,外部读者没法逐项复核。
另外补一句提醒:分数差距没有给出置信区间,2.8分这种量级在不同评分人之间可能就会波动。作者说不会拿它做六位数的决定,这个态度本身就是读这类基准最好的方式。
完整的方法说明和报告,可以在Jademond的基准报告下载页找到。
常见问题解答
这项本地化基准测试是谁做的?
本地化服务商EC Innovations和Jademond Digital联合完成,作者Marcus Pentzek是Jademond Digital的合伙人。两家公司都卖相关服务,作者在文中做了披露。
测试的是哪个翻译方向?
英语译成中文。国内外贸团队常做的中译英没有覆盖,结果不能直接套用。
SEO文案用AI翻译可以吗?
直出不行,所有模型直出都明显落后。千问或豆包加人工校对得71.3分,人工74.1分,差2.8分,作者认为大致持平,可以按成本和交付时间选。
为什么人工翻译营销文案得分最低?
EC Innovations认为译员习惯把语言改得规范正式,磨掉了营销文案需要的当下语感。人工在这一类排第10,比第一名低22.2分。
人工校对一定能提高AI译稿的质量吗?
不一定。平均提升5.6分,用户生成内容上最高提升30.6分,但ChatGPT和Kimi的营销文案、ChatGPT的技术文档在校对后反而降分。
国产大模型和海外大模型哪个翻译更好?
按类别比没有意义。SEO文案上两组平均都是60.7分,但国产四个模型之间最多差22.3分,应该按具体模型比。
译后编辑是什么意思?
先由AI或机器翻译出初稿,再由专业译员修改定稿,文中简称PE。测试里每个模型都有直出和译后编辑两个版本。
为什么Google翻译加人工校对在SEO文案上表现不错?
它拿了66.7分,超过所有直出的大模型。作者据此建议,已有翻译记忆库和术语库的成熟机器翻译流程,先加一层人工校对,比直接换成大模型直出更划算。
创译和翻译有什么区别?
翻译要求忠实原文,创译允许为目标市场改写表达,只要意思和效果到位。营销口号、社交内容通常更需要创译。
这个测试结果多久会过时?
模型都停在2025年12月的版本,作者自己说几个月前的快照在这个领域就是历史文件。具体排名随时可能被新版本改写,比较方法可以长期用。
测试了哪些模型?
ChatGPT(GPT-5.2)、Gemini 3.0、豆包1.6、千问Qwen 3、Kimi K2、DeepSeek-V3.2和Google翻译,都是2025年12月前后的网页版。
翻译质量分数高能带来更好的排名吗?
这项测试没有采集任何排名、流量或转化数据,作者明确说不能把质量差距当排名效果。公开研究里内容质量指标和排名的关联也不强。
人工翻译还值得请吗?
值得,但要用在对的地方。在信息类和SEO文案上人工仍排第一,事实精度和术语一致要求高的内容交给专业译员更稳;营销、界面、技术和社交内容,数据显示付人工的钱并不划算。
做百度SEO先抓翻译质量还是先抓备案?
作者认为百度更看重域名历史、ICP备案和服务器位置这类站点信号,备案和主机没解决之前,花大钱升级翻译是先做了更贵的那件事。
团队怎么自己做翻译模型比选?
选三四个候选模型,用自有内容按类型抽样,出直出稿和校对稿,按准确、流畅、风格三个维度盲评,按内容类型分别看排名,六个月后重做一次。
权威参考资料
本文标题:《英译中本地化基准:人工校对过的AI在6类内容里赢了4类,SEO文案人工只领先2.8分》
本文链接:https://zhangwenbao.com/english-chinese-localization-benchmark-ai-post-editing-vs-human.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0