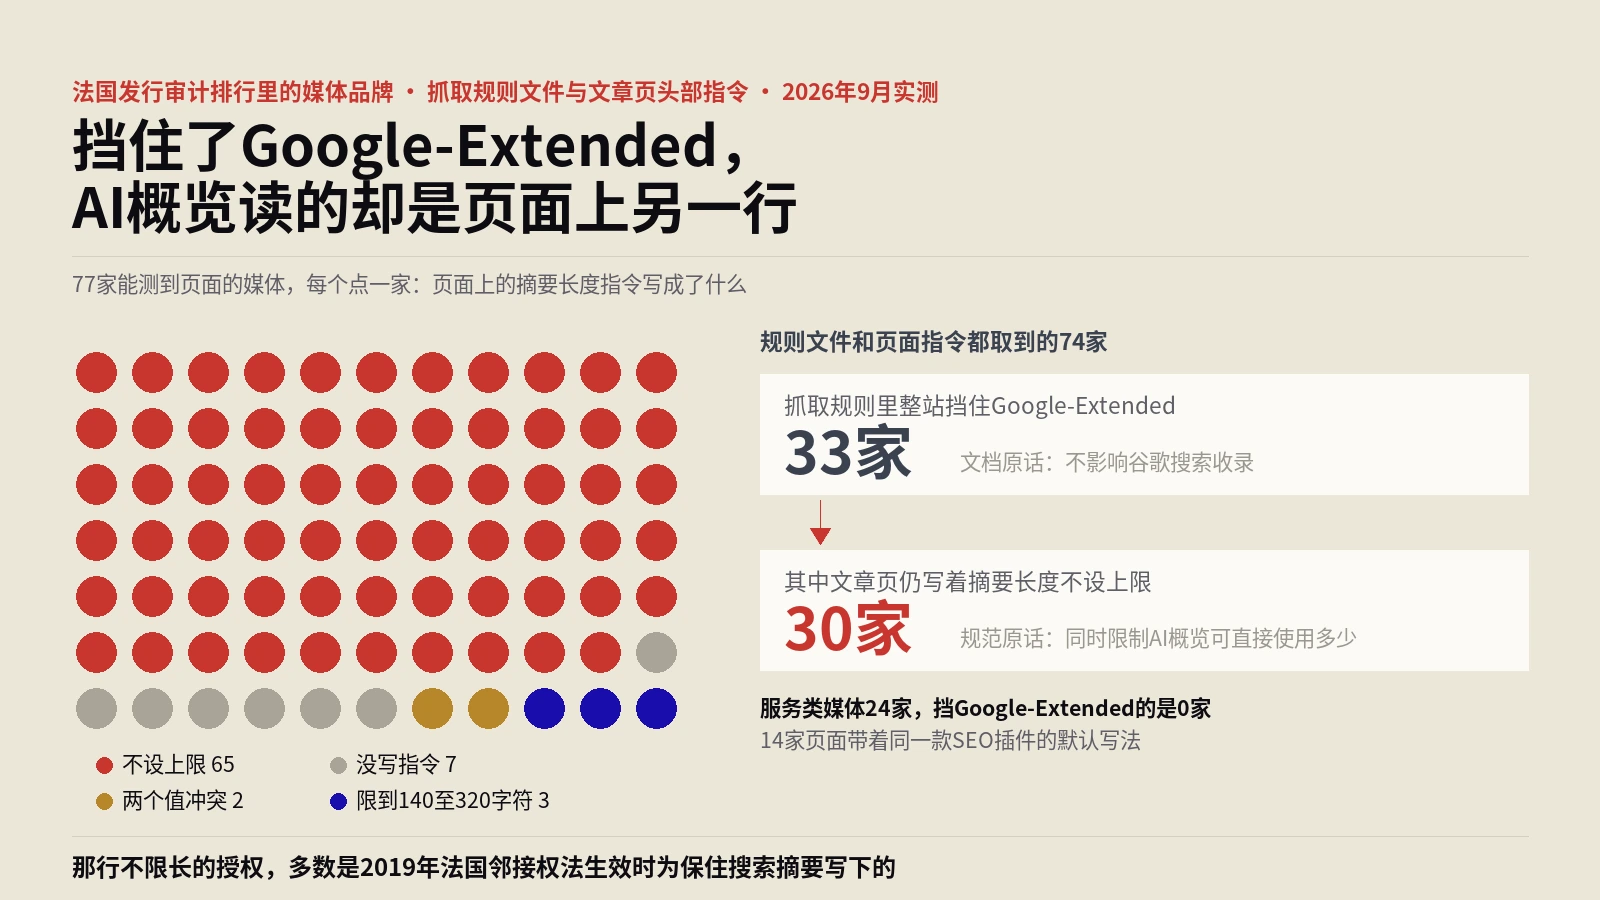
Google-Extended挡不住AI概览:77家法国媒体,84%的摘要授权没设上限
核对办法:从法国发行审计机构八月数字品牌排行里挑出98个媒体品牌,逐家取回抓取规则文件与文章页头部的摘要指令,被防护挡住的用真浏览器补抓;再对照谷歌指令规范、爬虫文档、新闻授权计划说明与2019年法国预览政策,判断每条设置实际管到哪里。
AI到底凭什么推荐某个品牌、引用某篇内容?这里拆解AI引用机制与可见度,从信源选择、训练数据共现、引用滞后到提及与引用差距和E-E-A-T信号演化,帮你看懂AI时代被看见的底层规则。
核对办法:从法国发行审计机构八月数字品牌排行里挑出98个媒体品牌,逐家取回抓取规则文件与文章页头部的摘要指令,被防护挡住的用真浏览器补抓;再对照谷歌指令规范、爬虫文档、新闻授权计划说明与2019年法国预览政策,判断每条设置实际管到哪里。
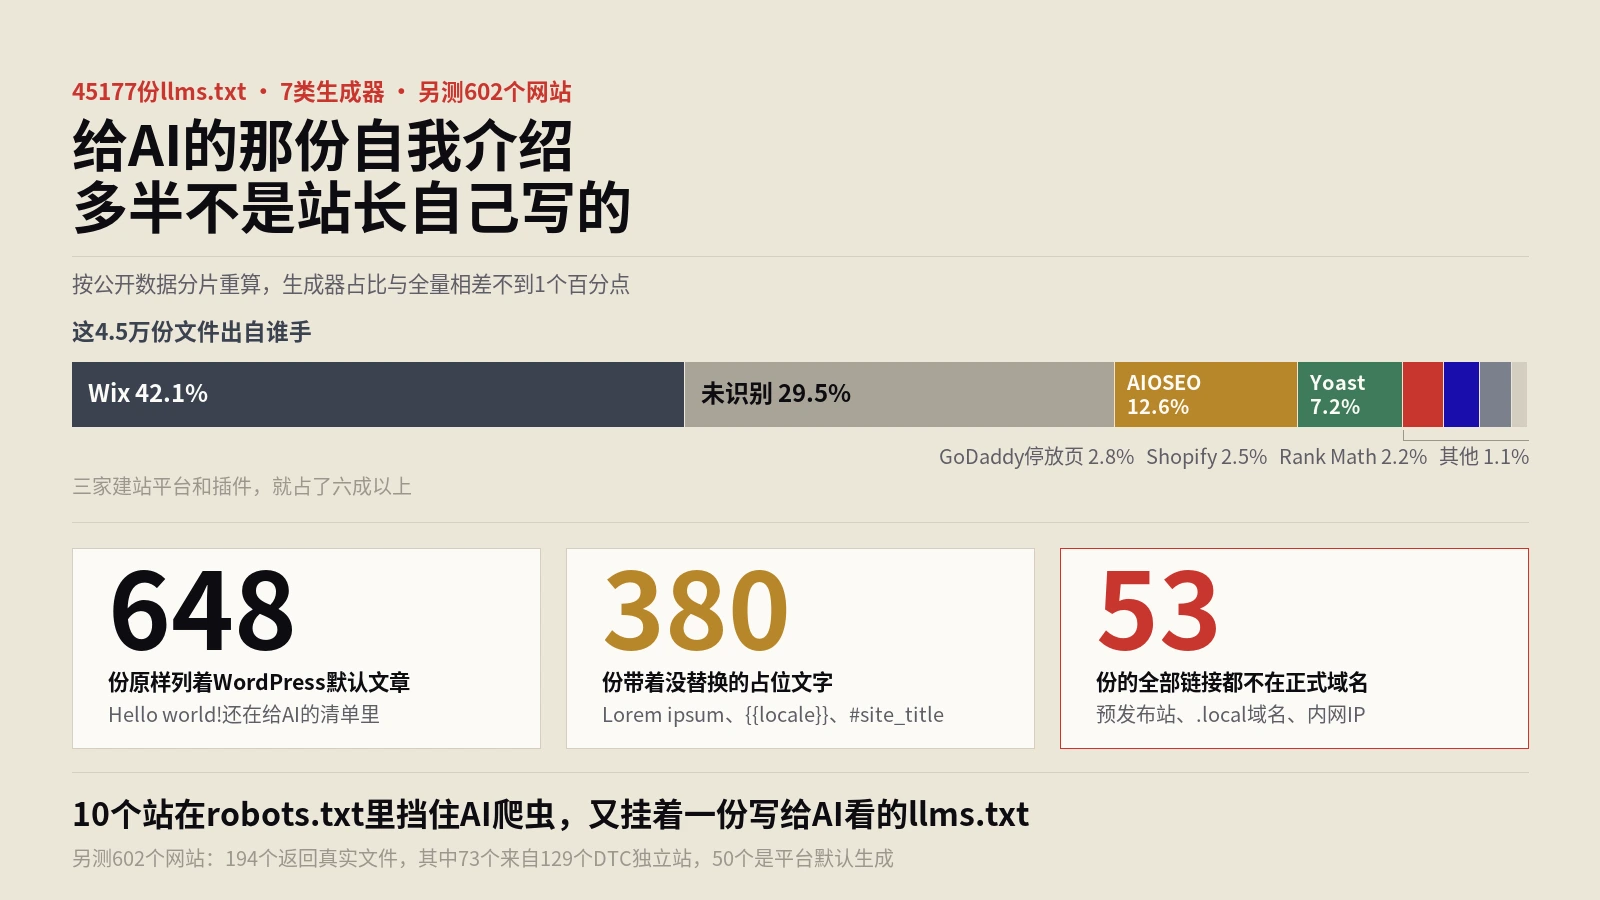
做法:下载Common Crawl公开的llms.txt数据分片,按署名与结构骨架识别生成器,逐份检查默认示例文章、未替换占位符、链接主机是否为预发布或本地地址、政策性语句;另抓602个网站的llms.txt与robots.txt逐条对照,并对抽样链接做两轮存活复测。
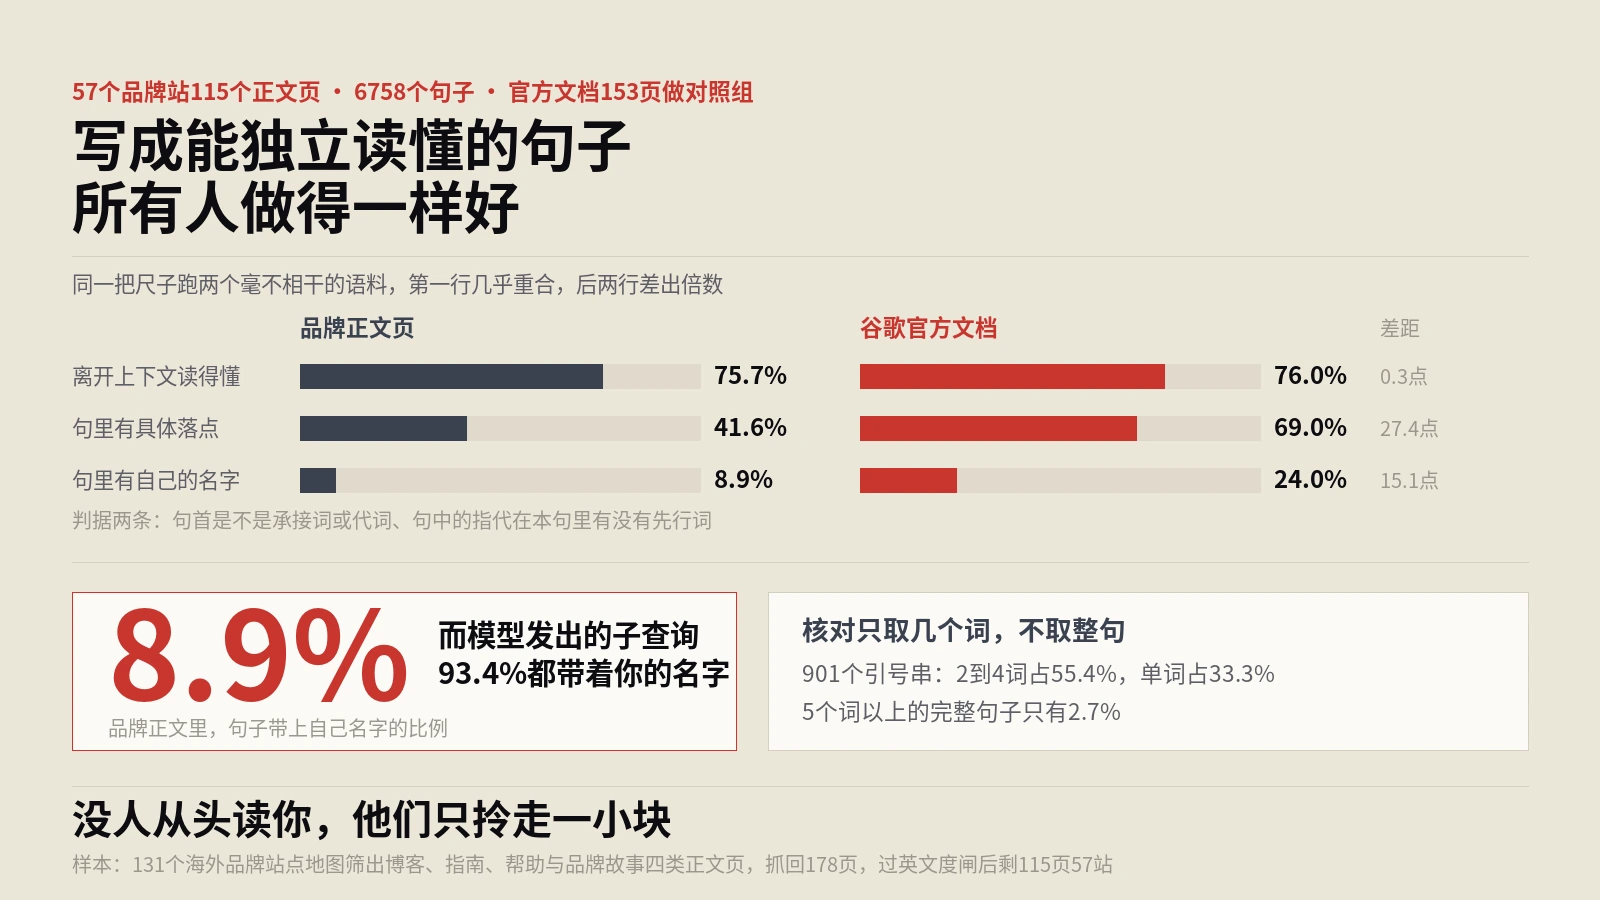
测法写清楚了好复现:从131个站的站点地图筛出博客、指南、帮助与品牌故事四类正文页,低并发抓回178页,先过一道英文度闸剔掉非英文页,再剔掉跨页样板句,最后按句首承接、悬空指代、具名落点、品牌落款四条规则逐句判定,并用谷歌官方文档的153个页面跑同一把尺子做对照。
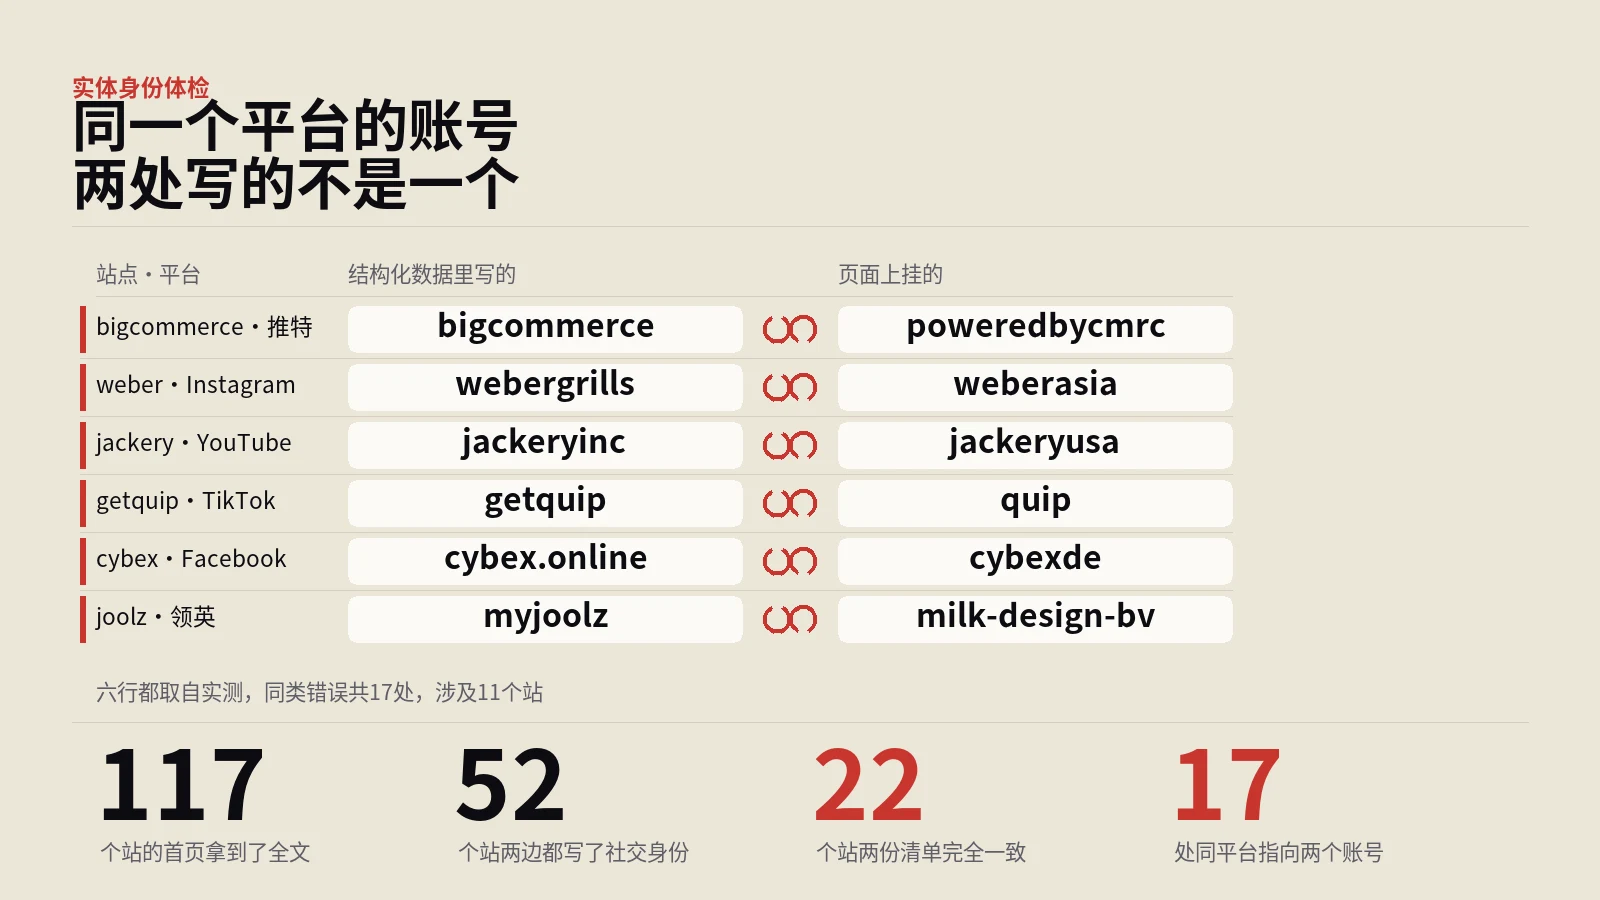
做法是只抓首页一次,把结构化数据里的sameAs、页面上的社交链接和twitter:site三份一起取出来就地比对,先归一到平台粒度再逐个对账号,全程不去社交平台验活。平台判定表里一条写法把整个google.com都吞了进去,凭空造出八个站的Google+残留,修完只剩一个。
要判断一段内容的来源能不能被核实,有一套可以照着跑的量法。先把目标站的首页抓下来存成文件,从中取出机器可读的结构化数据块,把代表组织的那个实体找出来;然后逐字段清点有无,把字段按外人能不能独立查证排成一列——名称和描述属于纯自述,网址和标志一点就知道,关联主页要去对面看,法定名称和税号能在登记处查;最后画出填写率随可核验度变化的那条线,看它在哪一档出现断崖。整套逻辑不到两百行,唯一要留神的是结构化数据的嵌套解析,只在顶层找会漏掉一大半样…

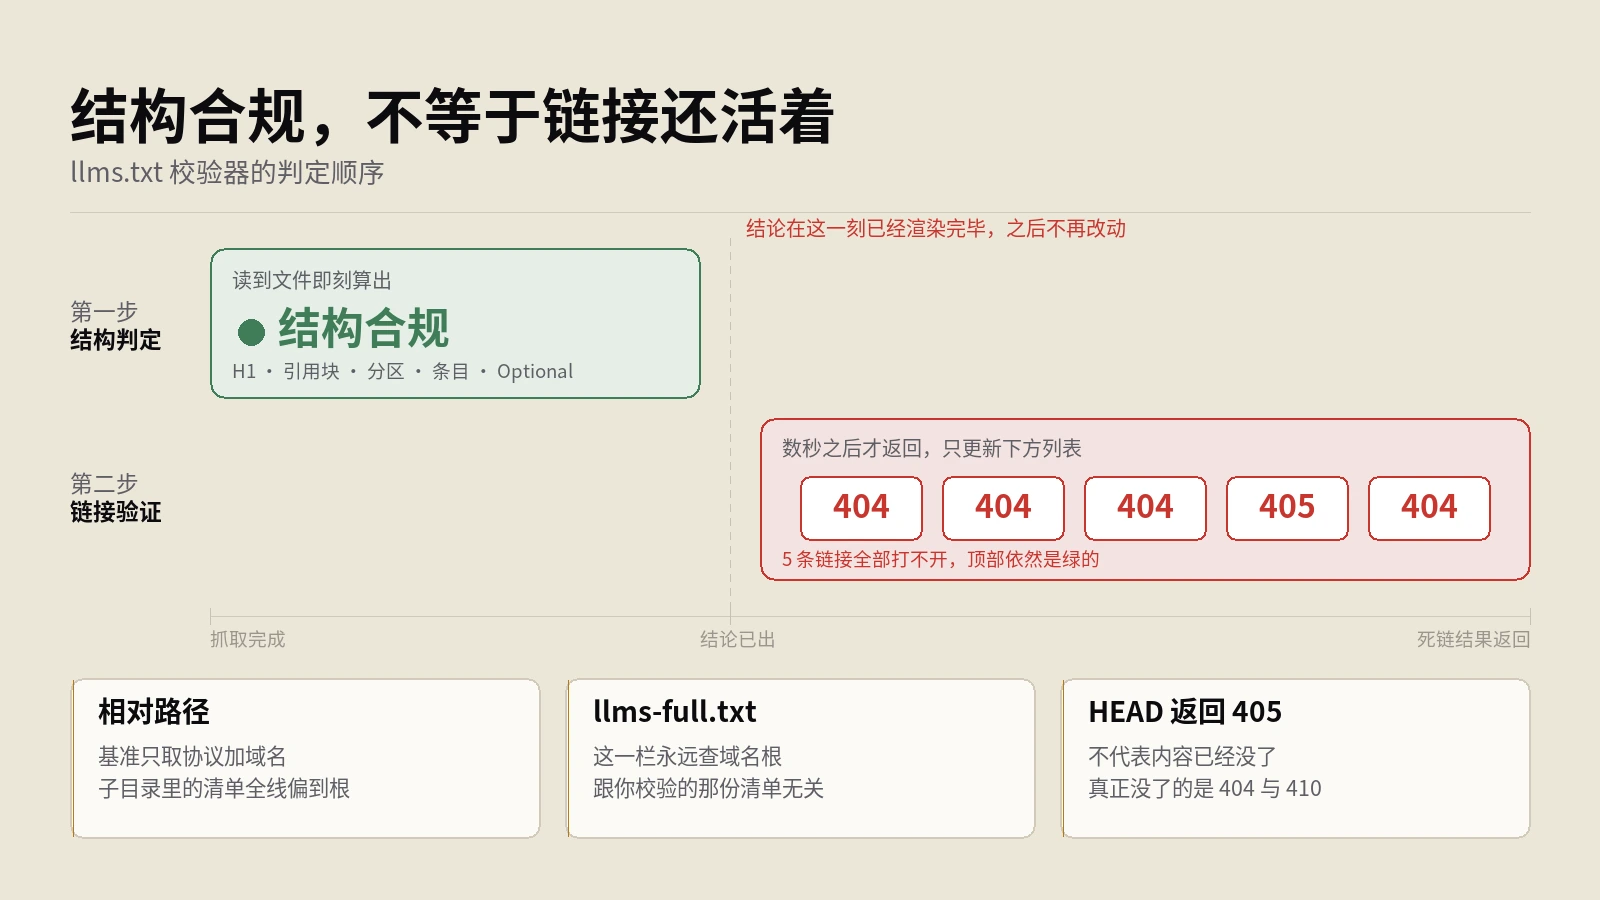
llms.txt校验器的六项结构检查怎么读、哪些黄灯不用理?实测结构合规的绿灯与链接死活无关,相对路径按域名根拼接,llms-full.txt永远查根目录,405也不等于内容不存在。
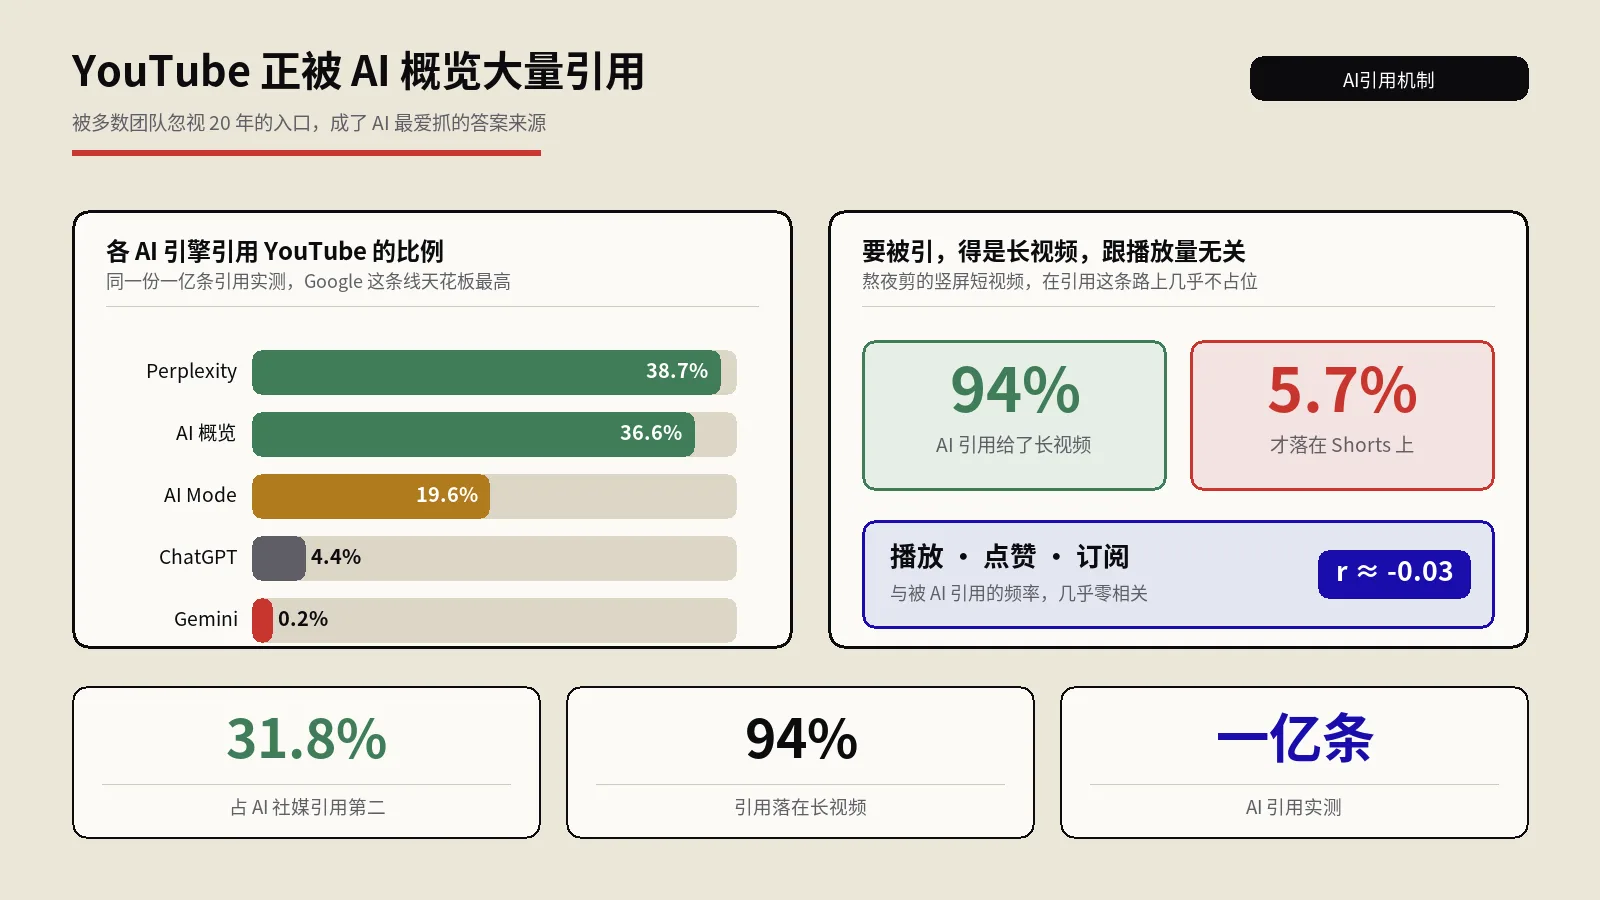
YouTube已是AI社媒引用来源第二,长视频吃掉94%的视频引用。本文用OtterlyAI与牛津经济研究院的数据讲清缘由,并拆解创作者甄别、工作流并轨、预算分账、出海适配这些落地环节。
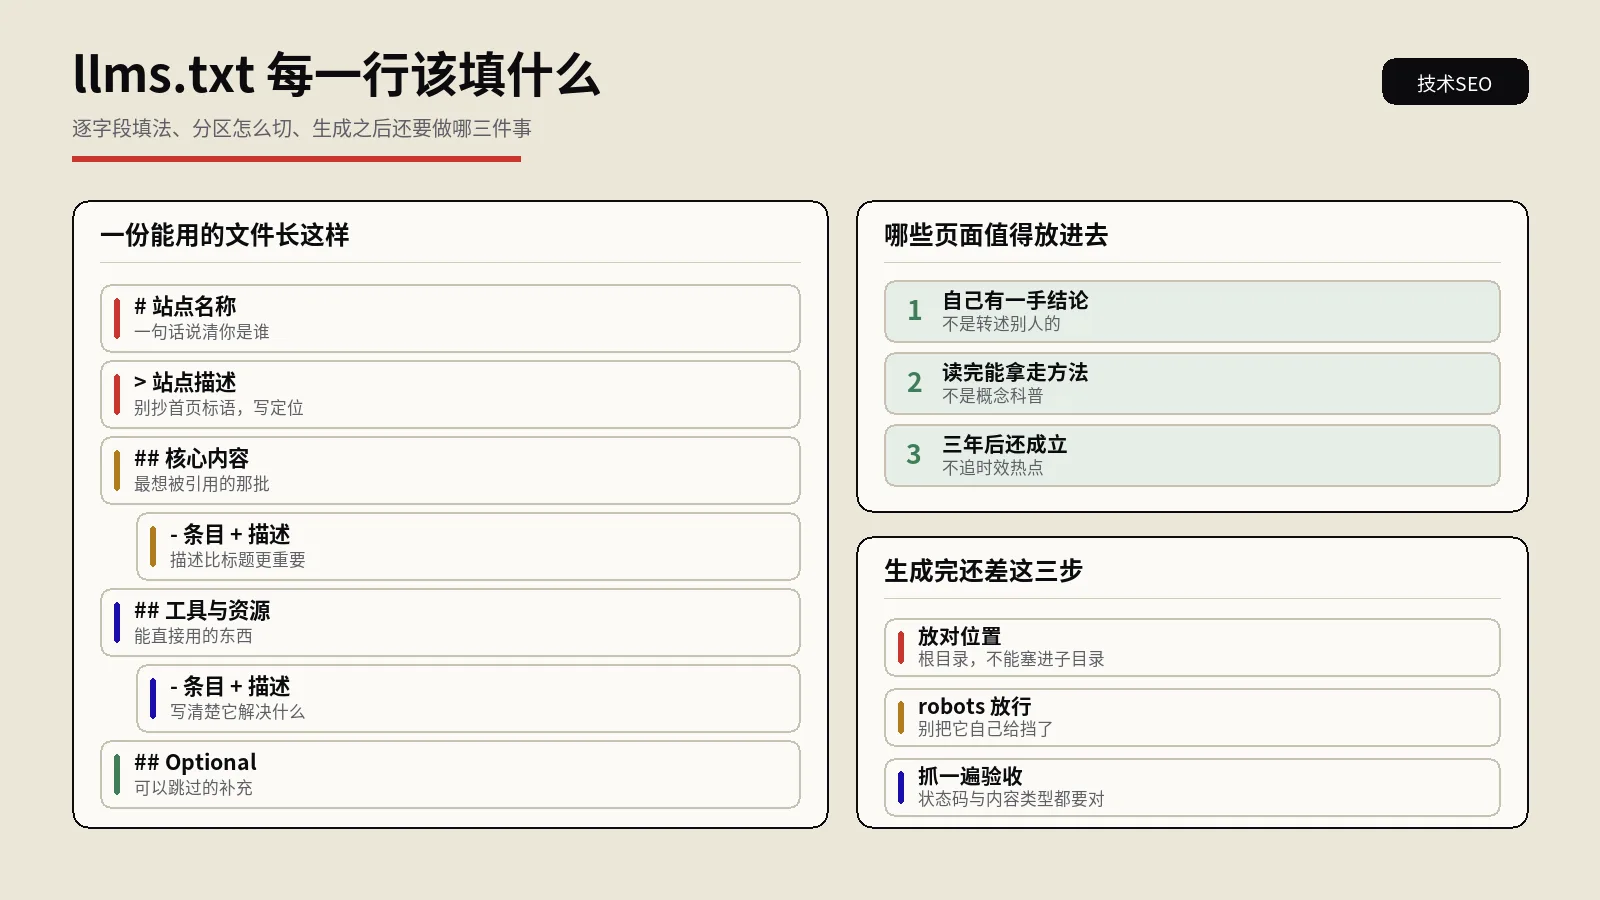
llms.txt生成器的完整用法:站点名称、描述、分区各填什么,条目描述怎么写才有信息量,选内容的三条标准,以及生成后的部署位置、robots放行与校验闭环。
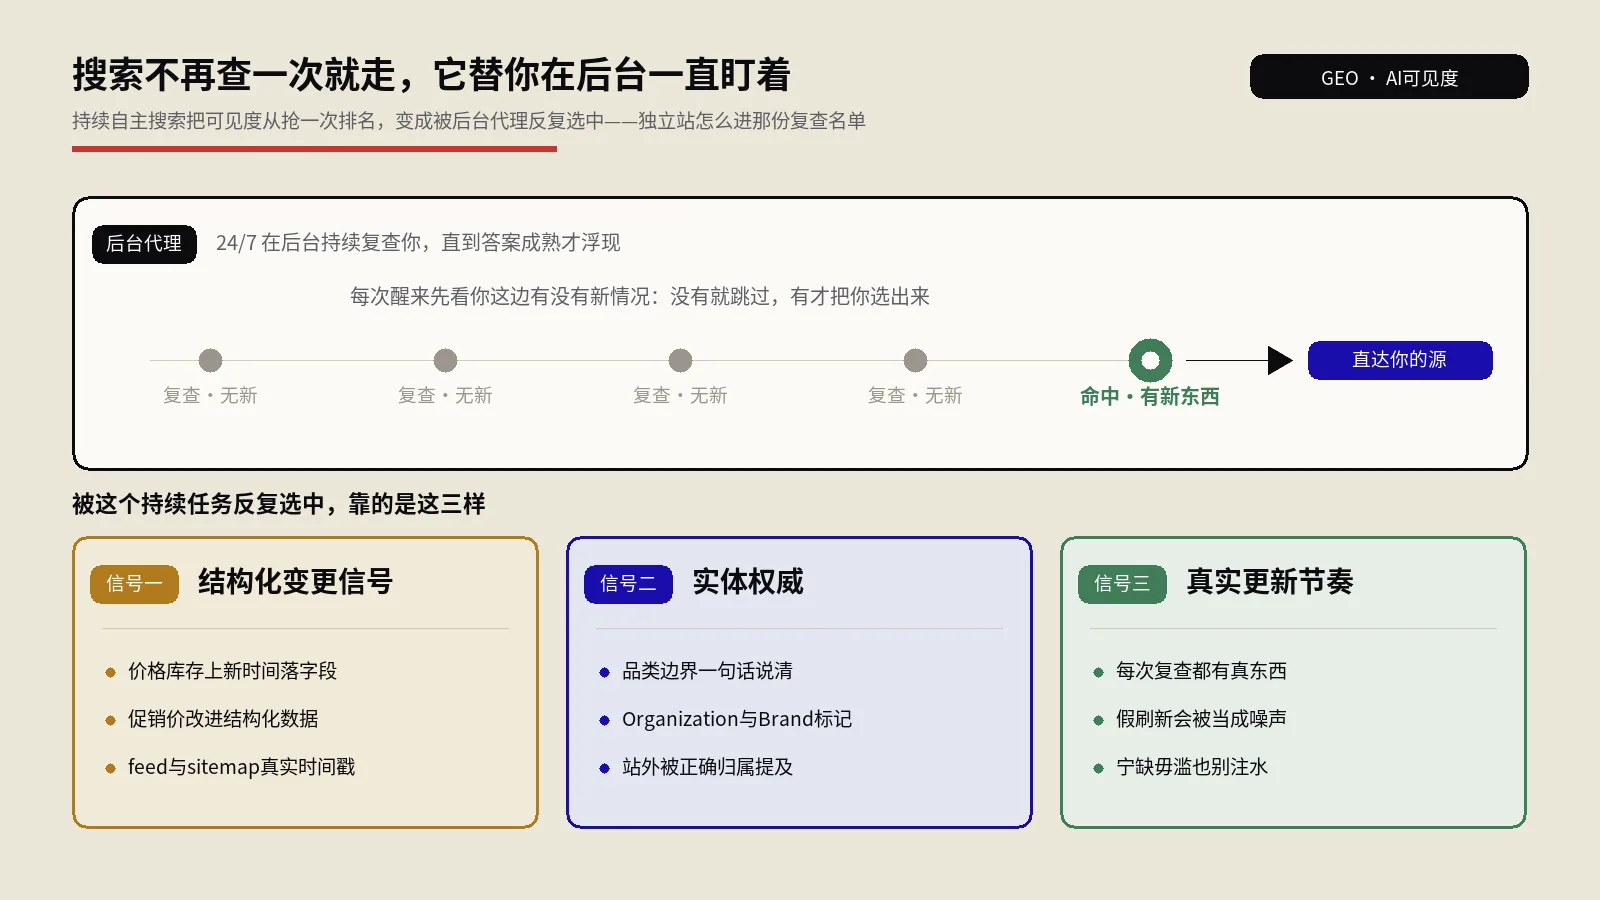
Google的Liz Reid谈agentic search:代理在后台替用户持续盯信息、成熟了再连同来源链接送达。本文讲清它和老式关键词提醒的分野、官方给出的上线范围与限制,并给出独立站能落地的动作——把上新做成结构化变更信号、建实体权威、养真实更新节奏。
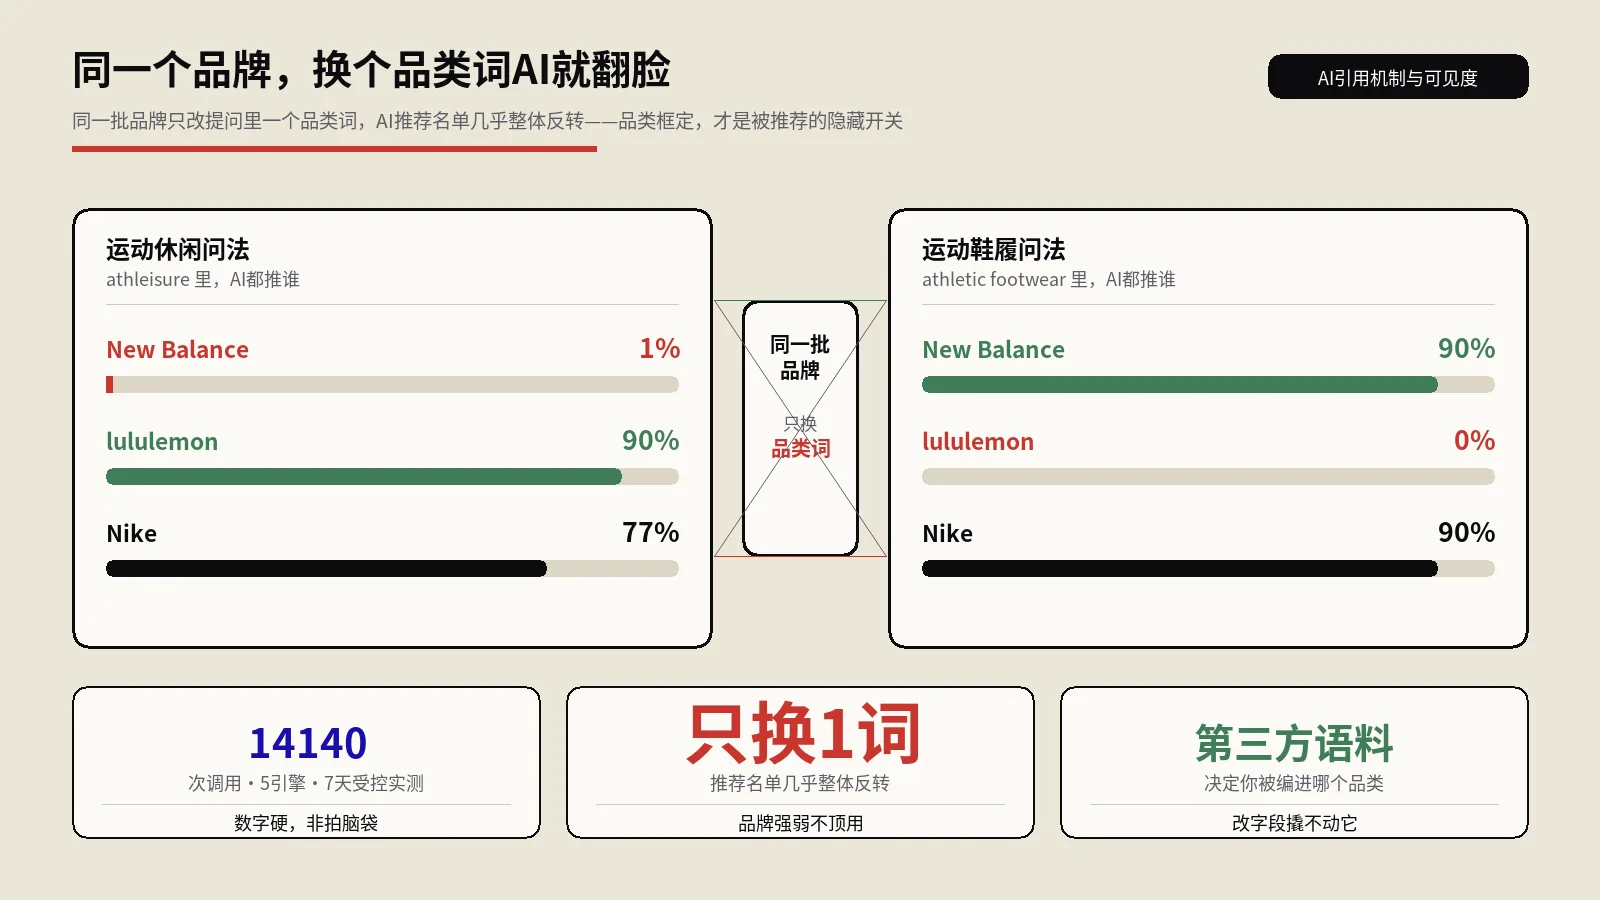
同样被AI认识的品牌,为什么有的被推荐、有的查无此人?本文拆解category coding机制:知识图谱描述定识别、第三方内容语料定推荐,用12个品牌14140次实测讲清品类框定如何决定AI推荐名单,并附品类自查表、共现语料打法与出海落地清单。
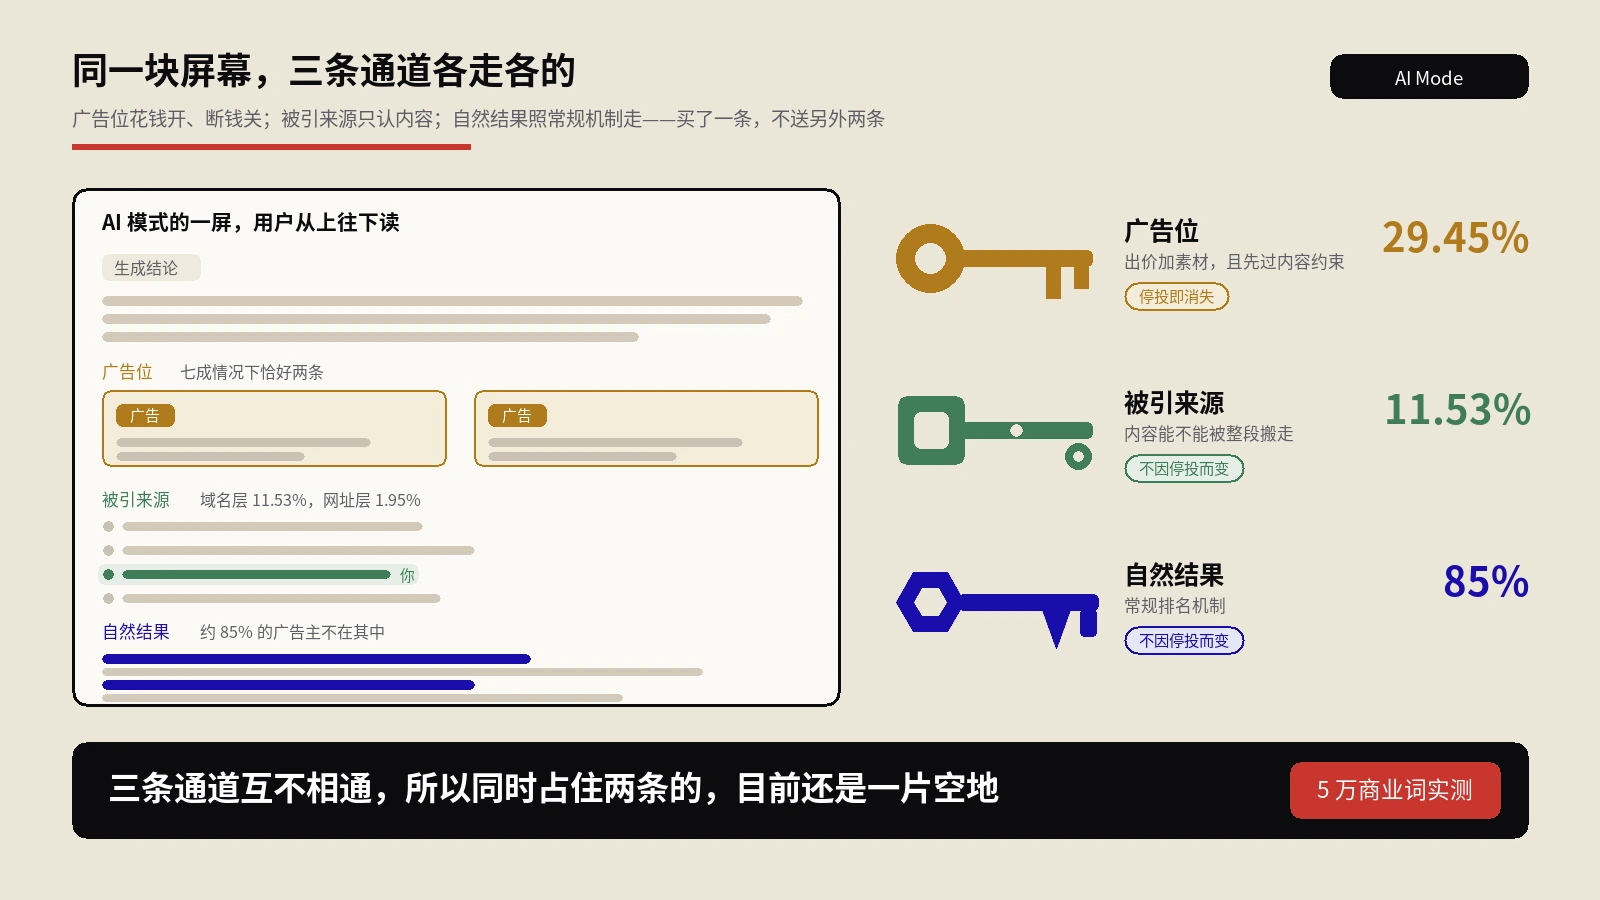
同一块屏幕上并排跑着三条互不相通的管道:花钱开、断钱关的广告位,认内容不认预算的被引来源,以及照常规机制走的自然结果。本文拆开这三者各自的准入条件与失效方式,并给出一套三十个核心词、两三个小时就能跑完的自测办法。
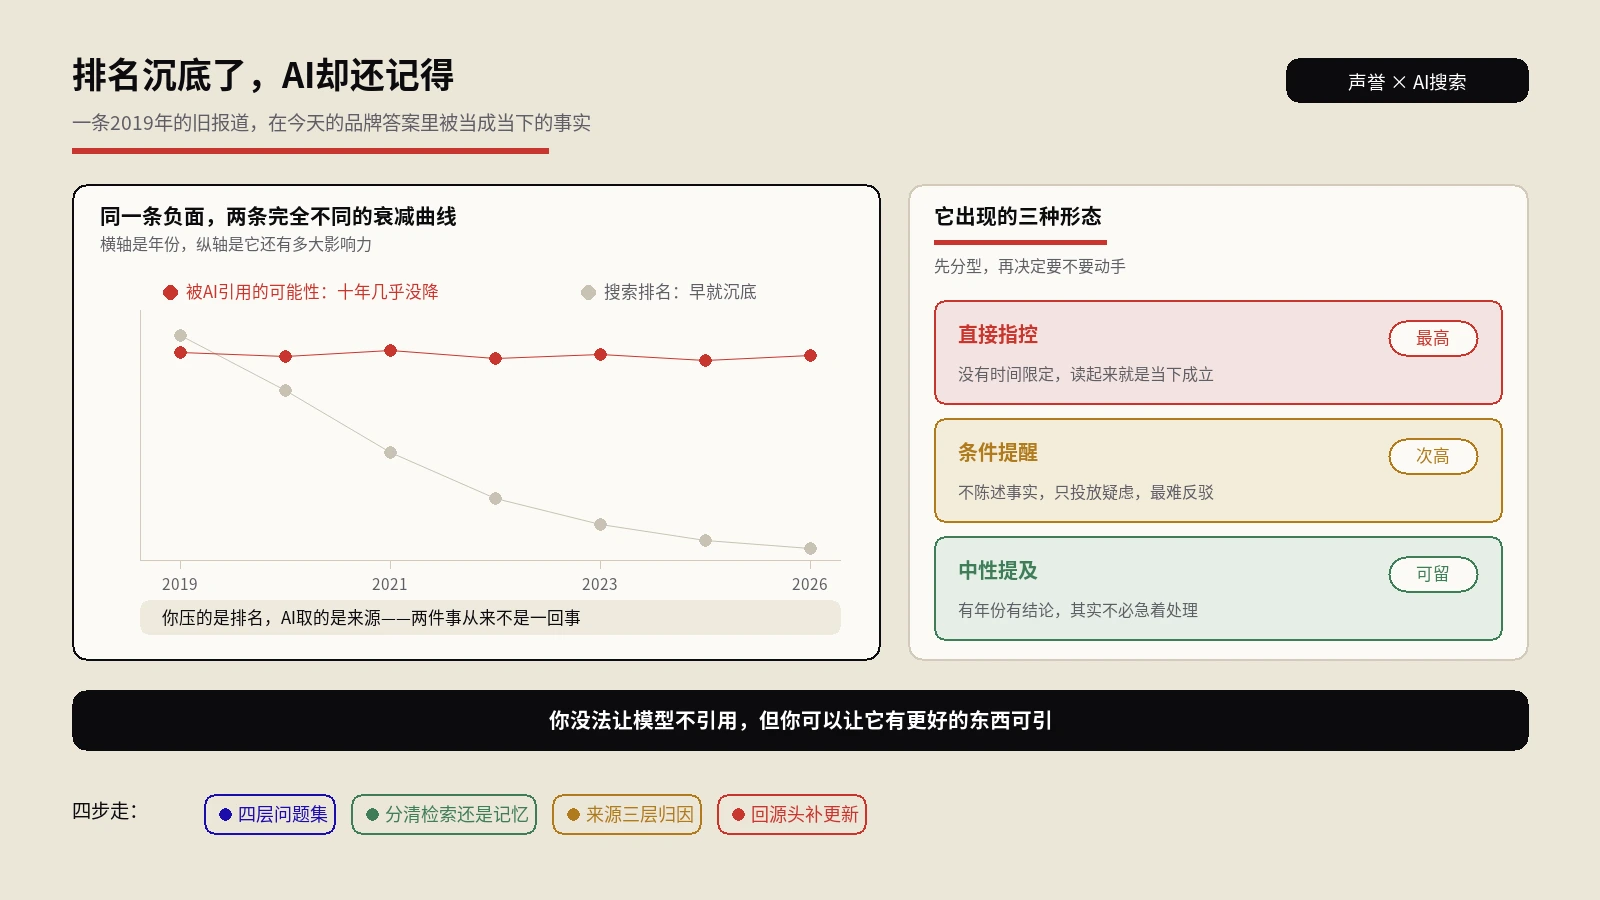
负面报道在搜索结果里沉底不代表它消失了。AI答案挑的是可信来源而不是排名位置,一条2019年的旧报道照样被拽进今天的品牌介绍,还不标年份。压制那套老办法对它基本无效。本文拆开检索路径与记忆路径的区别、六类高危旧内容、四步诊断法与三档投入优先级,附一个智能门锁品牌四个月掰回AI口径的完整过程。
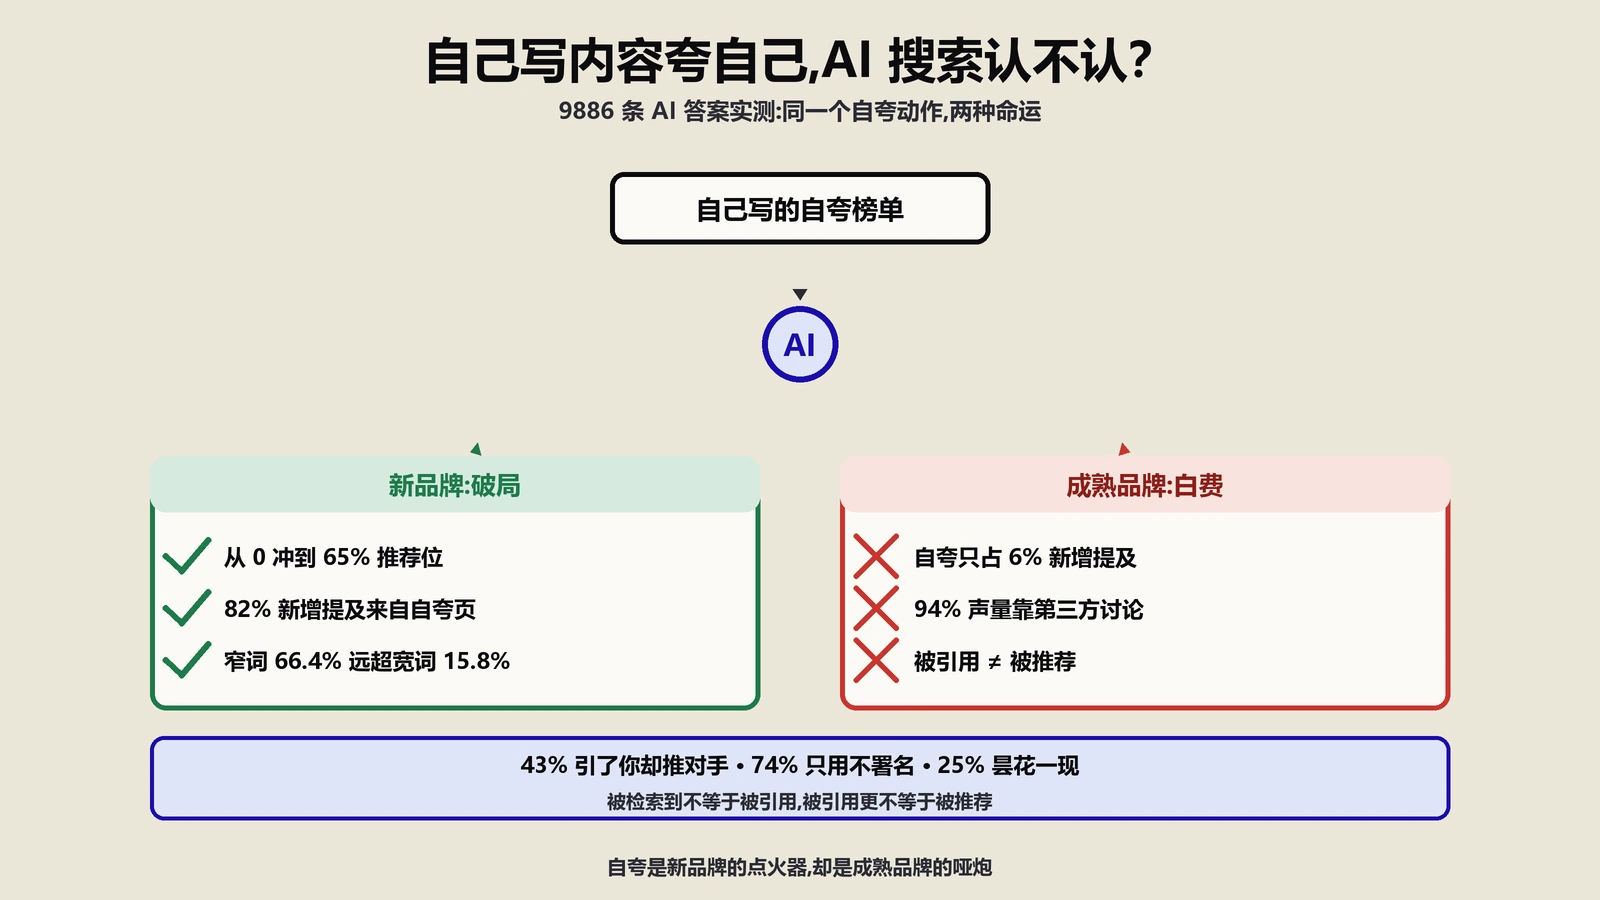
自己写榜单把产品塞进去,ChatGPT就会推荐你吗?扒了9886条AI答案后发现:名不见经传的新品牌自夸能破局,成熟品牌几乎白费,被引用还常给对手做嫁衣。这篇讲清自我推销在AI搜索里何时是杠杆、何时是自爆。
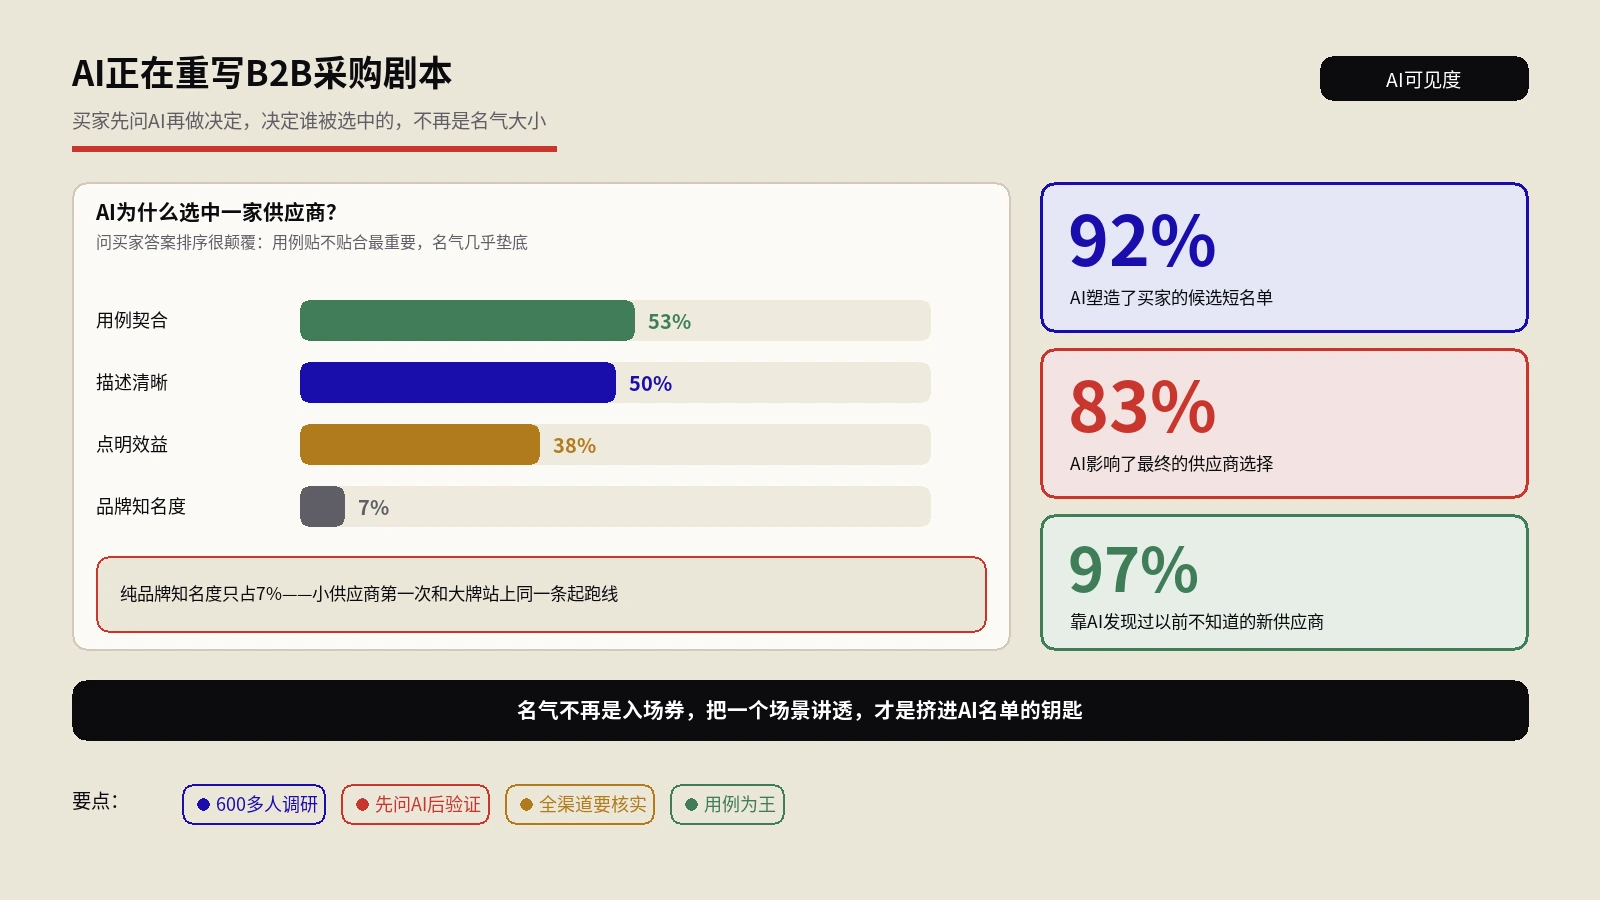
越来越多B2B买家先把需求丢给ChatGPT,再拿名单去验证。一项600多人的调研显示,92%说AI塑造了候选短名单、83%左右了最终选择,而决定谁被推荐的头号因素是用例契合而非品牌知名度。这篇讲清AI怎么重写采购剧本,外贸和独立站如何被AI选进名单。
重复问同一个问题,名单保留九成;加一句买家条件,却只剩两成八。这不是不稳定,是响应性。本文给出监控该怎么从单次提问改成整段对话、追问清单去哪儿找、按模型分头修的顺序,以及一份研究报告该怎么快速验真。

有人读ChatGPT发回浏览器的原始JSON,扒出每条来源上的result_source字段只有四个取值,其中两个直接指向商业抓取公司。本文讲清四条管线怎么分工、哪些问题压根不联网、被抓与被引为何是两回事,以及用开发者工具自己复现的完整步骤。

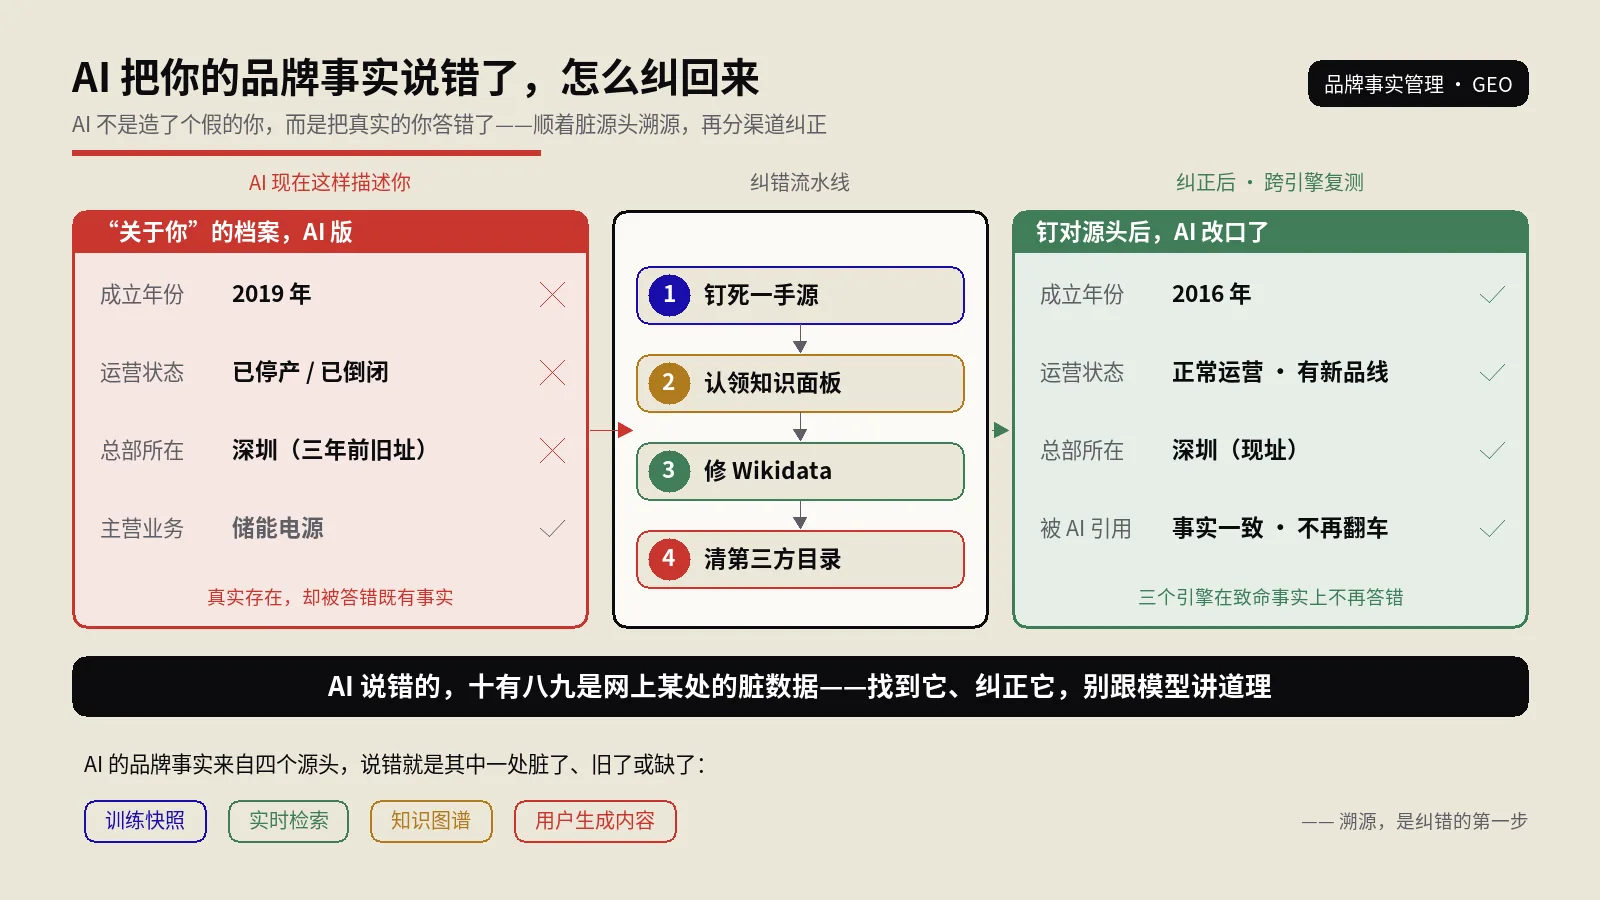
经销商在ChatGPT里查到你已停产、AI把成立年份说早三年——你真实存在却被答错既有事实。这篇教你先做跨引擎审计溯源,再按根因分渠道纠正,并说清哪些错误你根本控制不了。
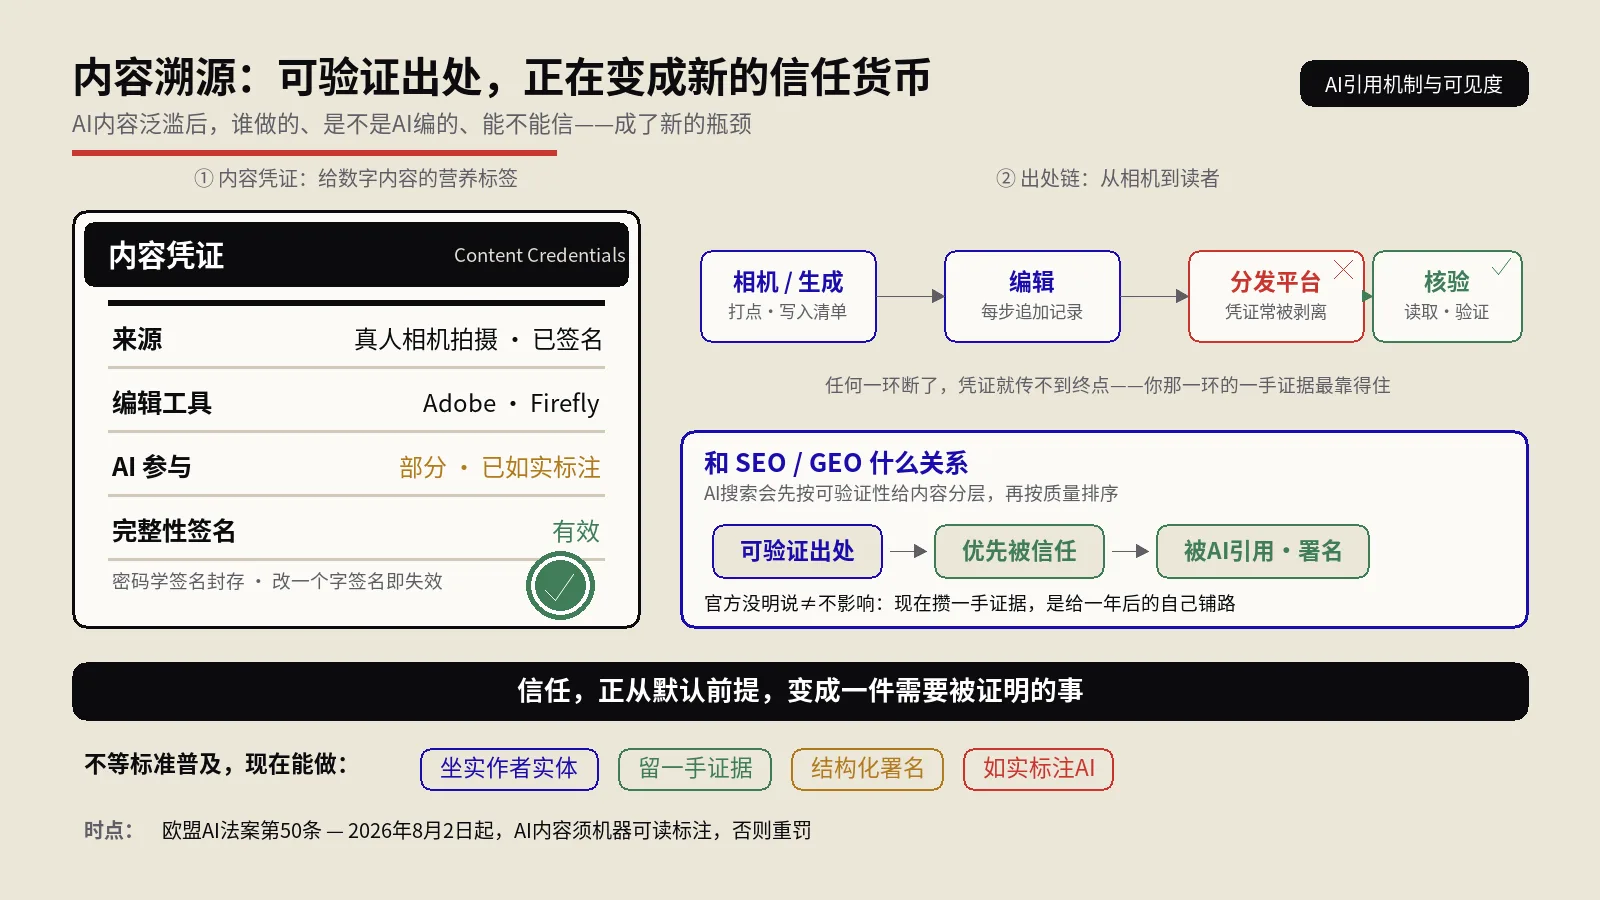
内容溯源(C2PA内容凭证)正从合规话题变成AI搜索的排序信号。本文讲清它是什么、密码学签名怎么运作、和GEO的真实关系,以及独立站主现在能落地的7件事,附一次真实的踩坑复盘。
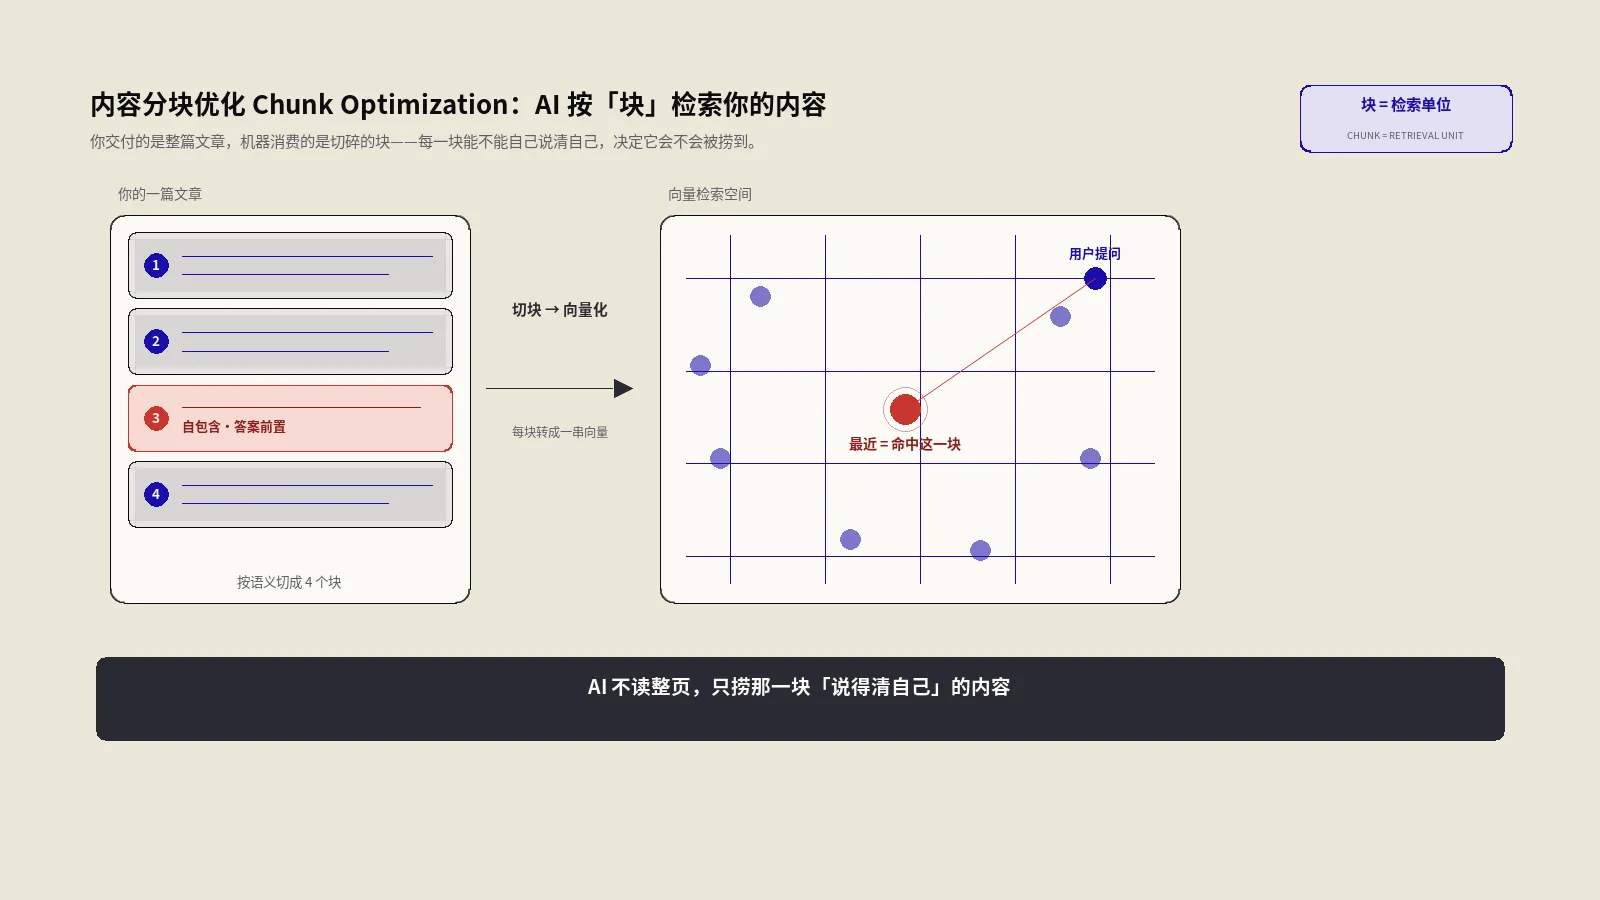
AI搜索引用你时不是读整页,而是把内容切成几百字的“块”做向量检索。本文讲透内容分块优化:块该切多大、重叠留多少、语义分块怎么选、最致命的块脱离上下文问题,并给外贸独立站一套自包含块改造清单。
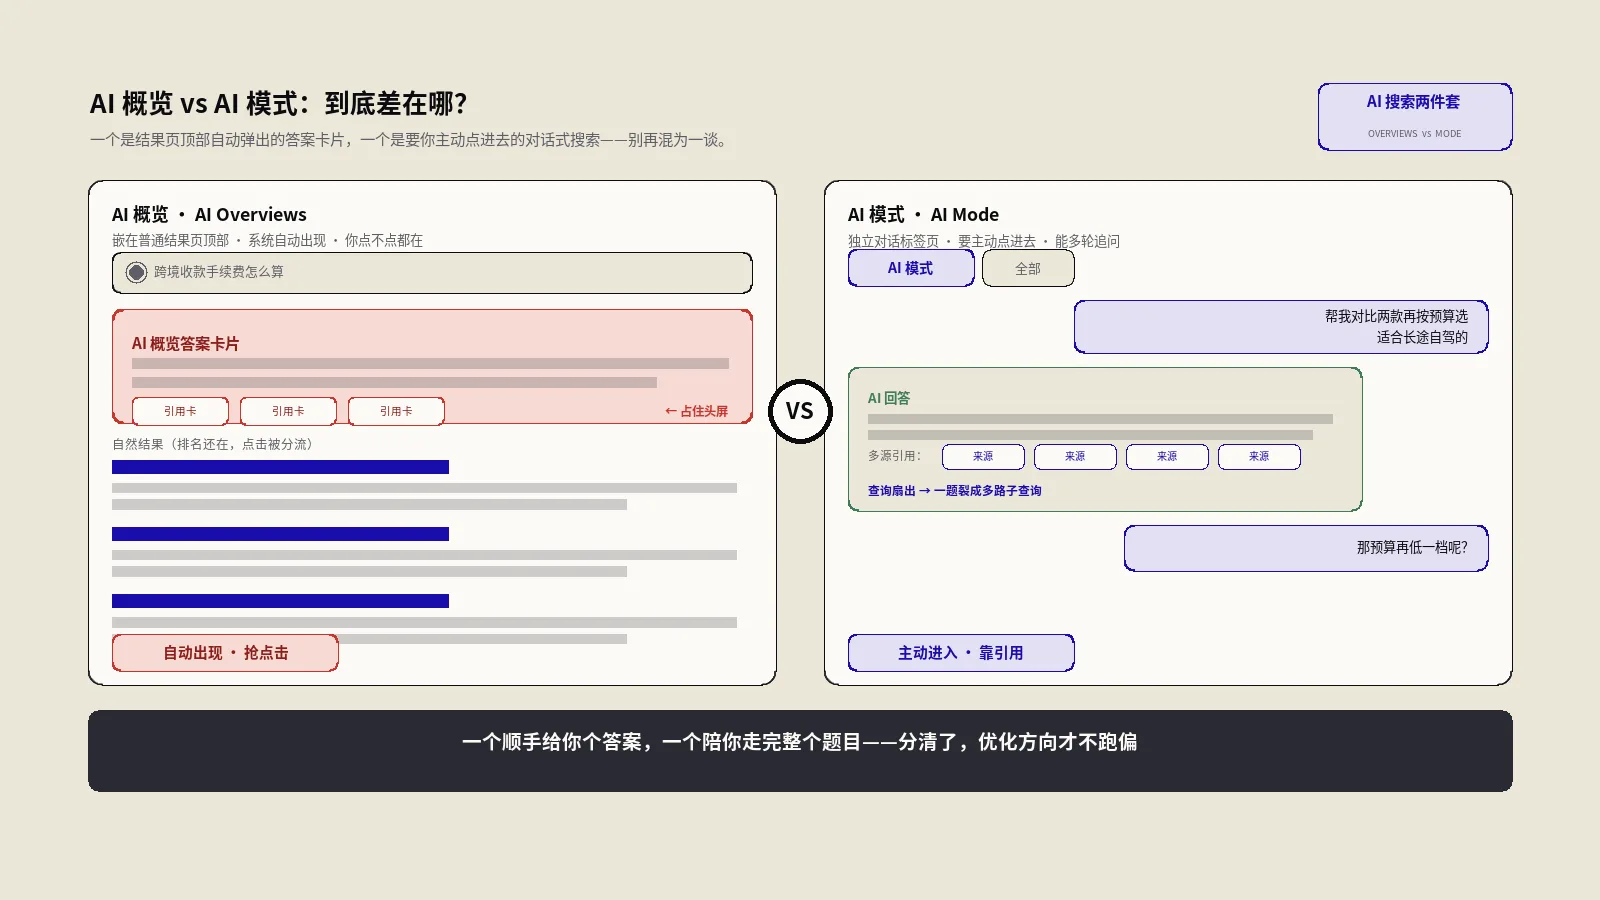
AI概览(AI Overviews)是嵌在搜索结果页顶部、自动出现的AI答案卡片;AI模式(AI Mode)是要主动点进去的独立对话式搜索标签页。本文从定义、时间线、查询扇出机制到SEO/GEO打法逐项拆开,附12维对照表,帮外贸独立站分清两者、各个击破。