AI工作流怎么搭才见收入:Eric Siu在Moz讲的技能、评分规则与循环
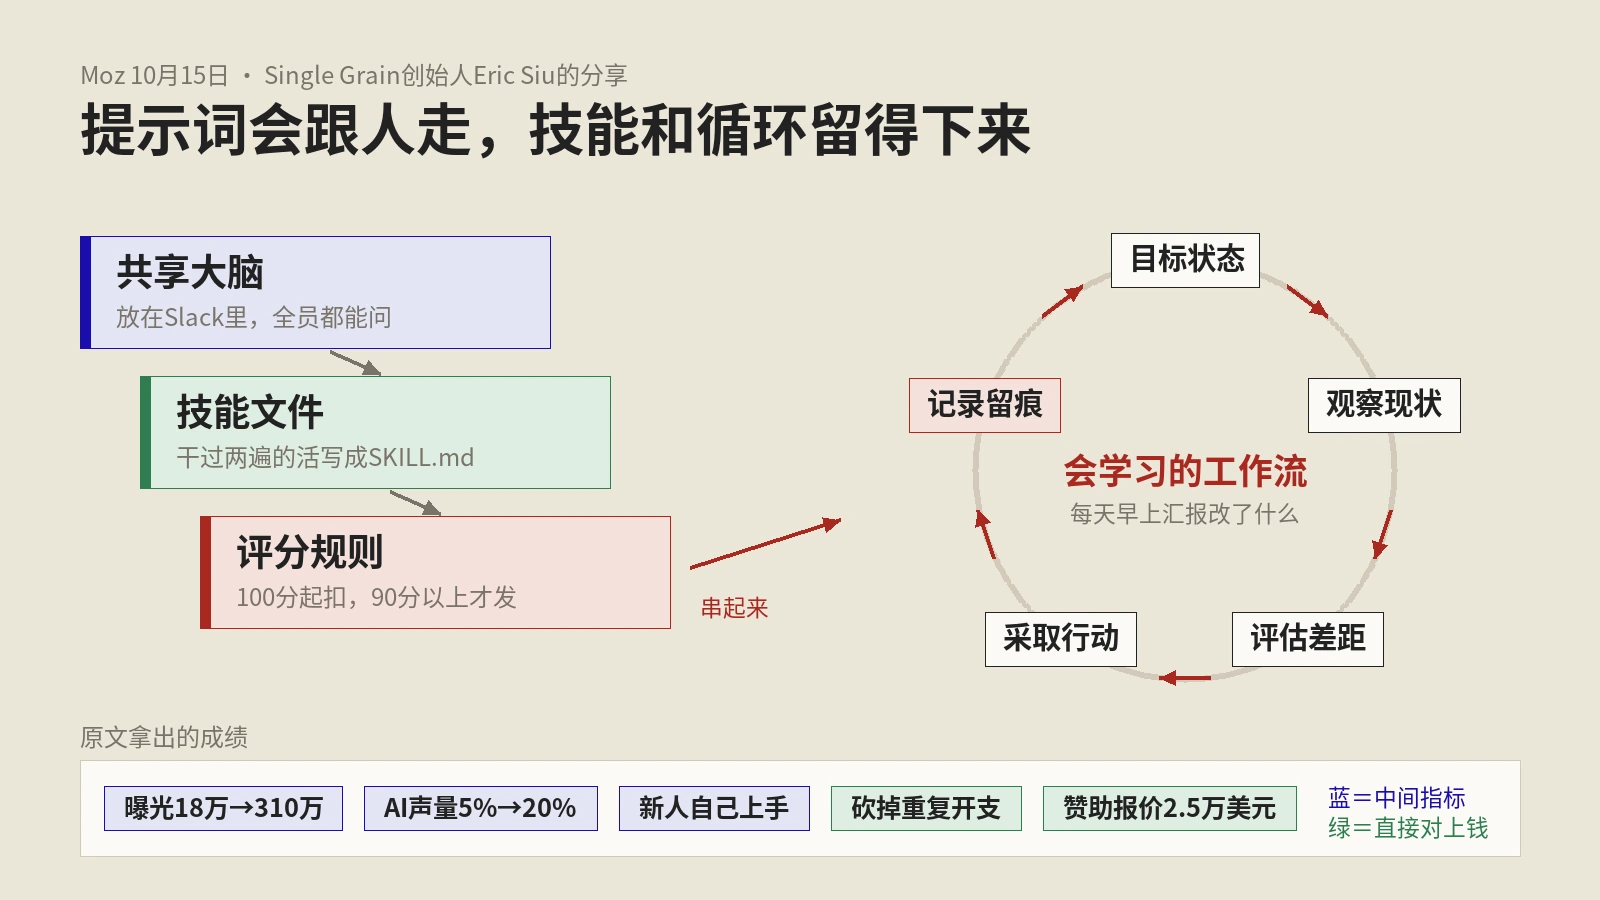
以Moz 10月15日Eric Siu的长文为主体,讲他怎样在Slack里搭共享AI大脑,把重复活写成SKILL.md技能,用100分扣分制的评分规则把关,再把技能串成带目标状态和行动记录的循环,并核对Panopto、BCG、Pew三项研究的样本口径,给出每个循环挂收入指标和留对照组的做法。
标签
保哥笔记 AI内容 标签下共 22 篇文章合集,含《AI工作流怎么搭才见收入:Eric Siu在Moz讲》《Google核心更新预测96.8%可信吗?熊猫式质量》《内容自动化从哪一步做起?Ahrefs把12份数据榜单》等,与 E-E-A-T、Google算法、内容质量 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
以Moz 10月15日Eric Siu的长文为主体,讲他怎样在Slack里搭共享AI大脑,把重复活写成SKILL.md技能,用100分扣分制的评分规则把关,再把技能串成带目标状态和行动记录的循环,并核对Panopto、BCG、Pew三项研究的样本口径,给出每个循环挂收入指标和留对照组的做法。
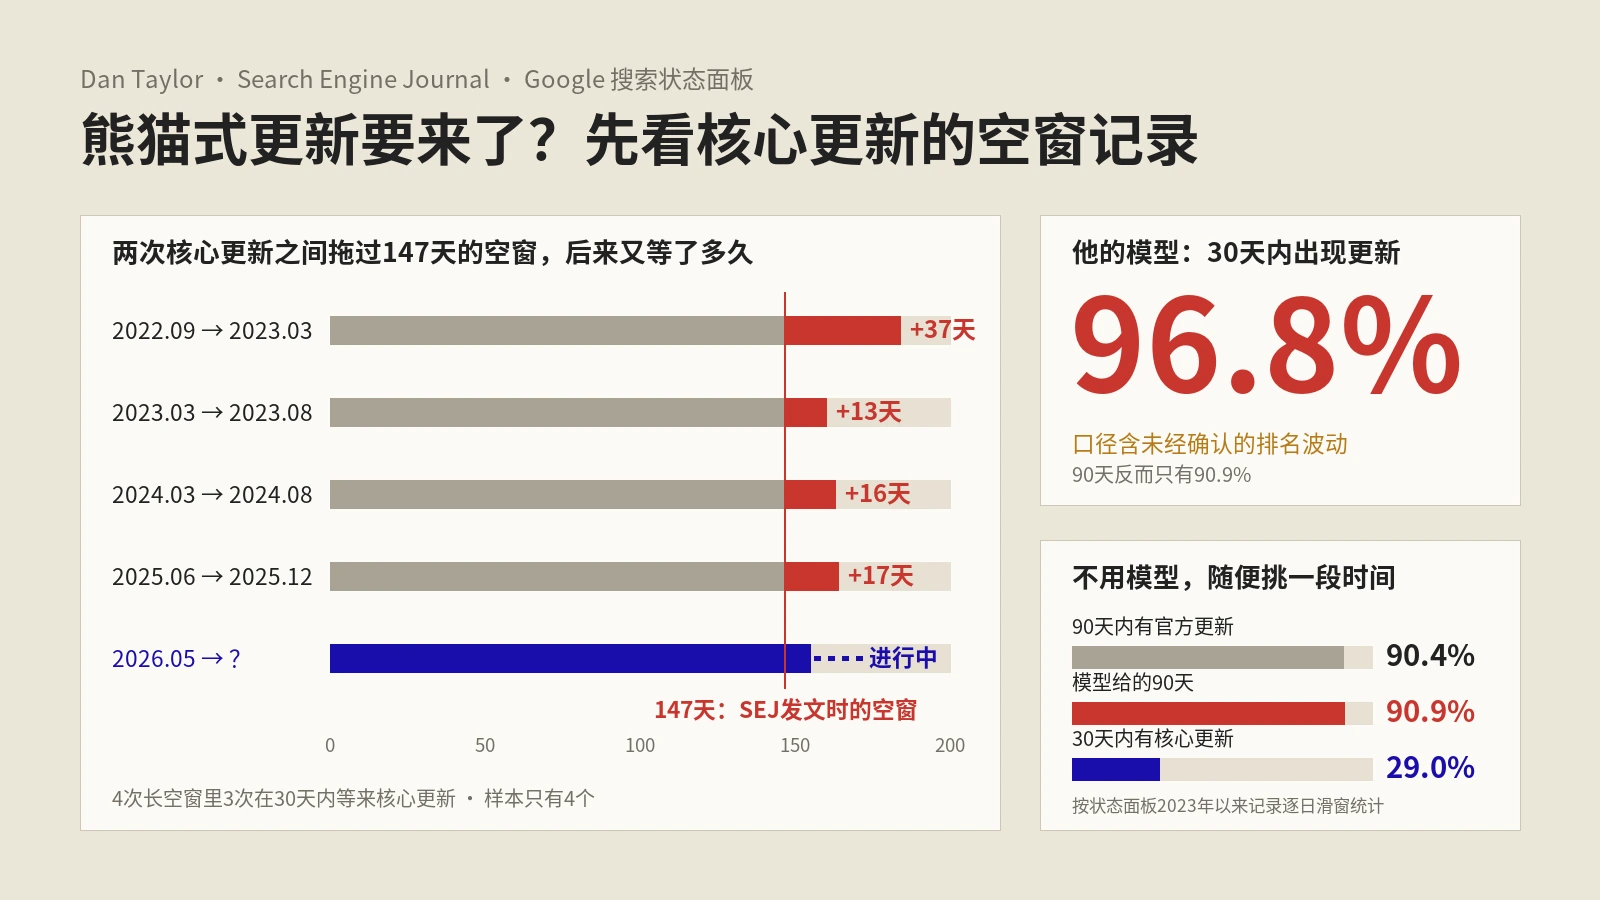
以SEJ专栏作者Dan Taylor的熊猫式更新预测为主体,对照Google搜索状态面板历年核心更新记录、2011年熊猫上线公告和10月新改的AI内容与有用内容文档,讲清这个概率的口径问题、熊猫被误读成字数标准的来由、站点级与页面级的区别,以及外贸站更新前的清点和汇报做法。
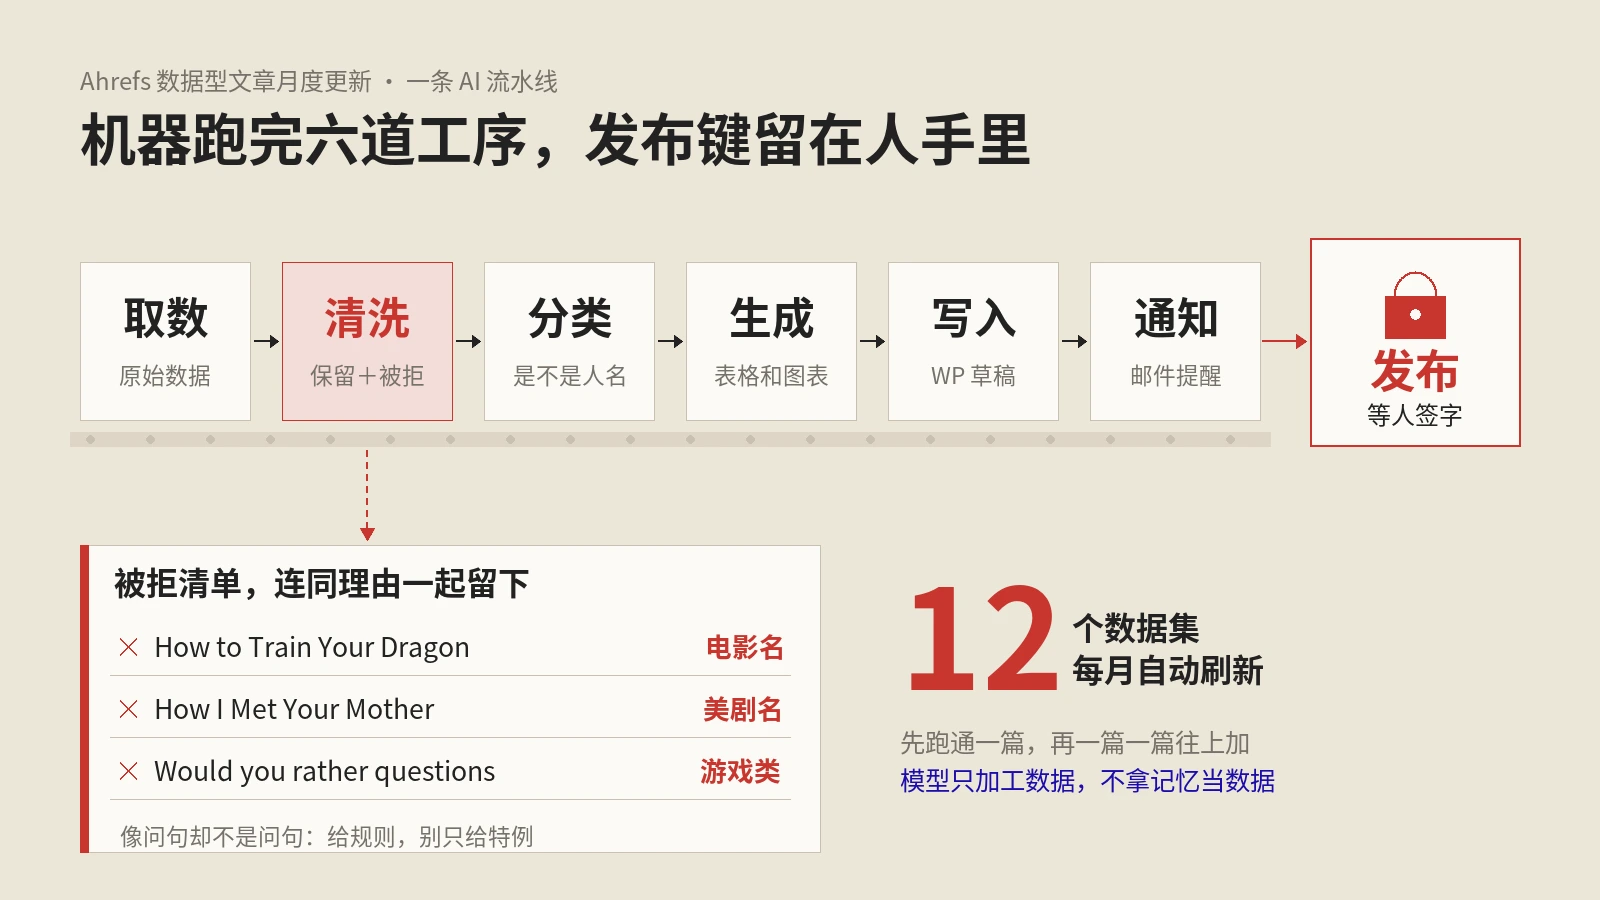
以Ahrefs 10月16日的跟做指南为主体,讲清Si Quan Ong怎样按五条标准挑出数据型文章的月度更新,用采访提示词把操作习惯写成技能文件,指定数据来源,用正反样例和被拒清单训练判断,分六个环节留存中间结果,先单篇后扩展,以及模型升级、共用工作区等会让流程失效的地方。
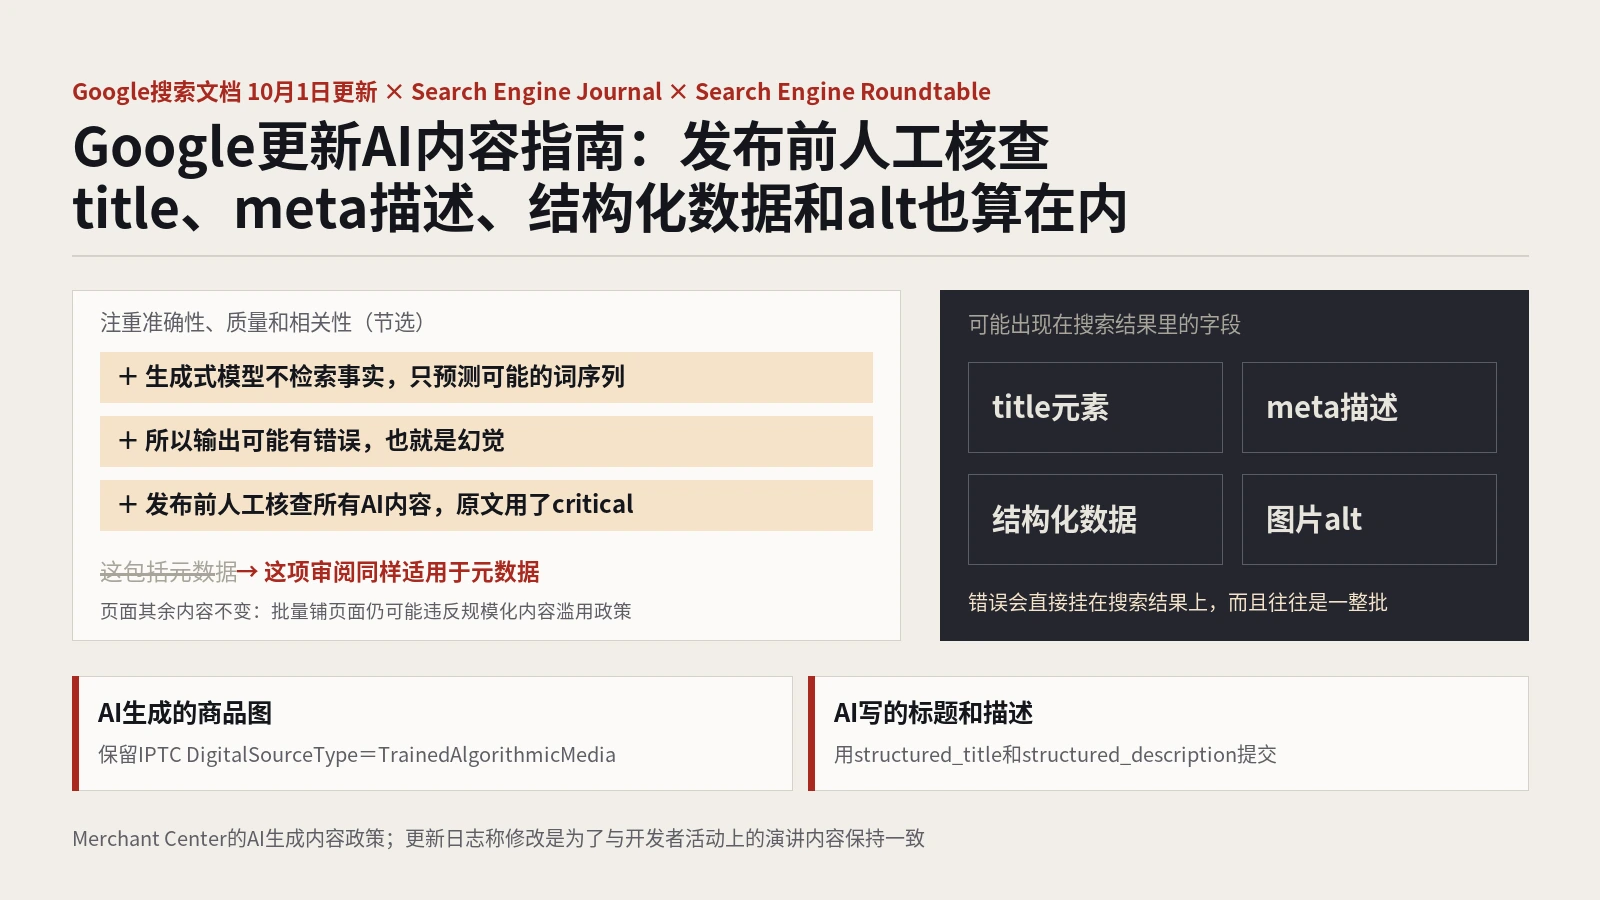
做法:以Search Engine Journal和Search Engine Roundtable对10月1日文档改动的逐句对比为主体,对照Google生成式AI内容指南原文、更新日志和Merchant Center的AI生成内容政策,整理新增三句话、未变的规模化内容警告、元数据为何被点名、AI商品图与商品数据的标注写法,以及审稿分工和核查清单。
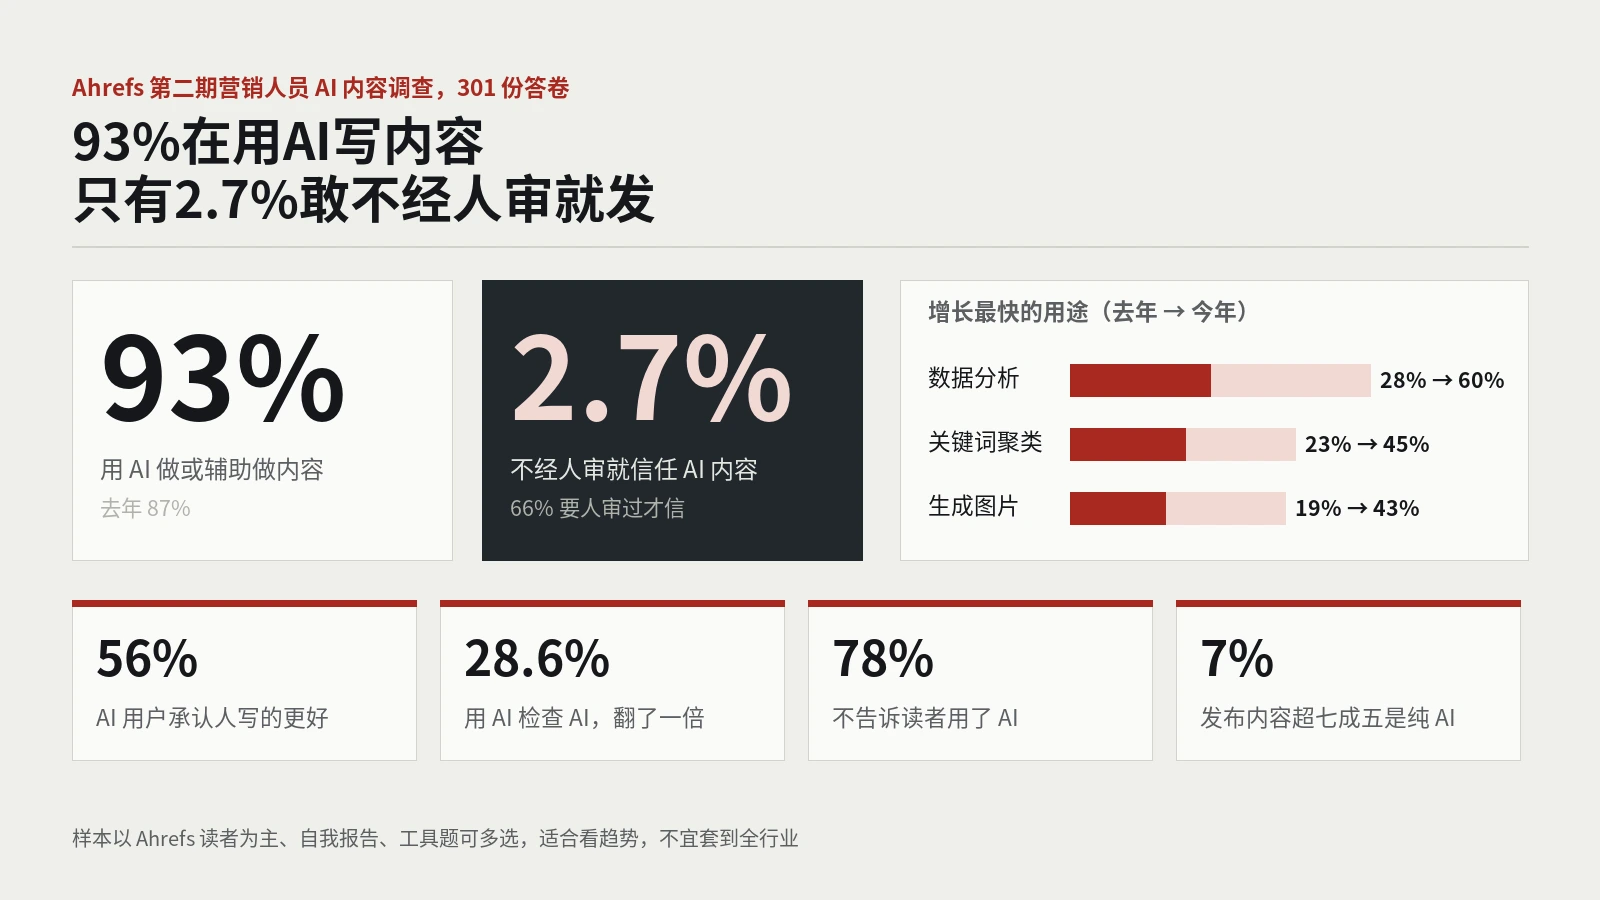
做法:以Ahrefs 9月30日发布的第二期营销人员AI内容调查为主体,对照2025年第一期报告和Google垃圾内容政策,整理AI普及率、增长最快的用途、工具与技能文件、信任与审核、质量评价、成本和披露数据,逐项说明样本局限,并给出外贸内容团队的分工建议和技能文件示例。
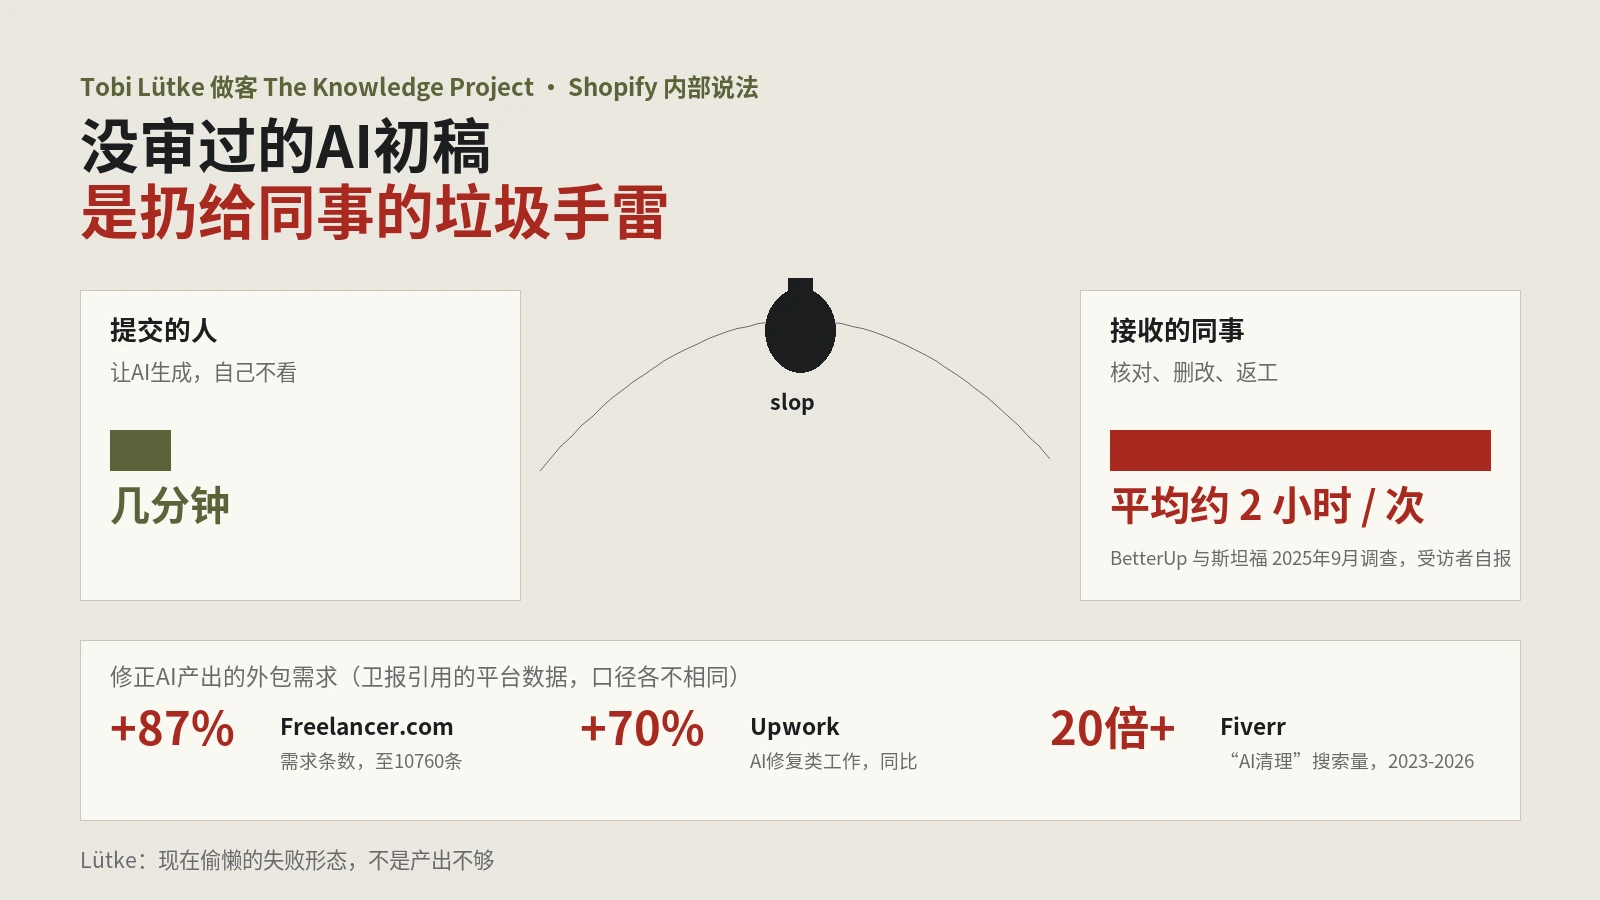
以SEJ 9月21日报道为主体,整理Shopify首席执行官Tobi Lütke在播客里关于slop grenade的原话、Shopify从2025年AI备忘录到全员使用的过程,以及卫报引用的修正AI外包数据和BetterUp的workslop调查,讲内容与外贸团队怎么把审稿时间算进AI成本、立哪些规矩。
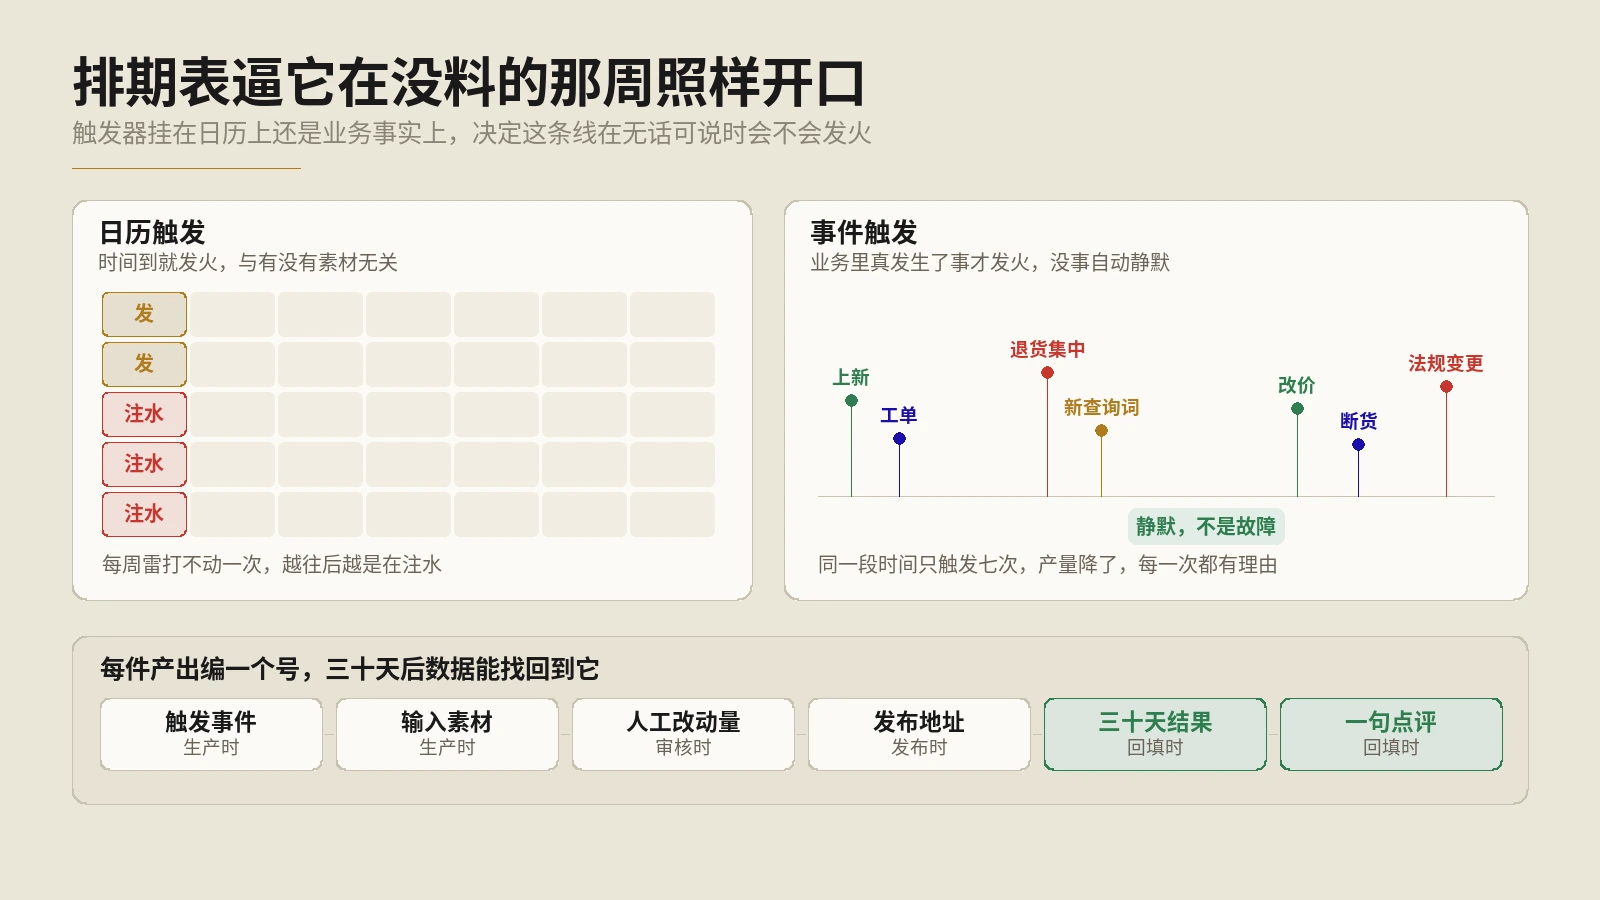
内容自动化的三段结构、六类可用事件源与阈值防抖去重键三参数、产出回执六字段清单、四周落地次序,附独立站页面类型的AI风险对照表与AGPL自部署提醒。
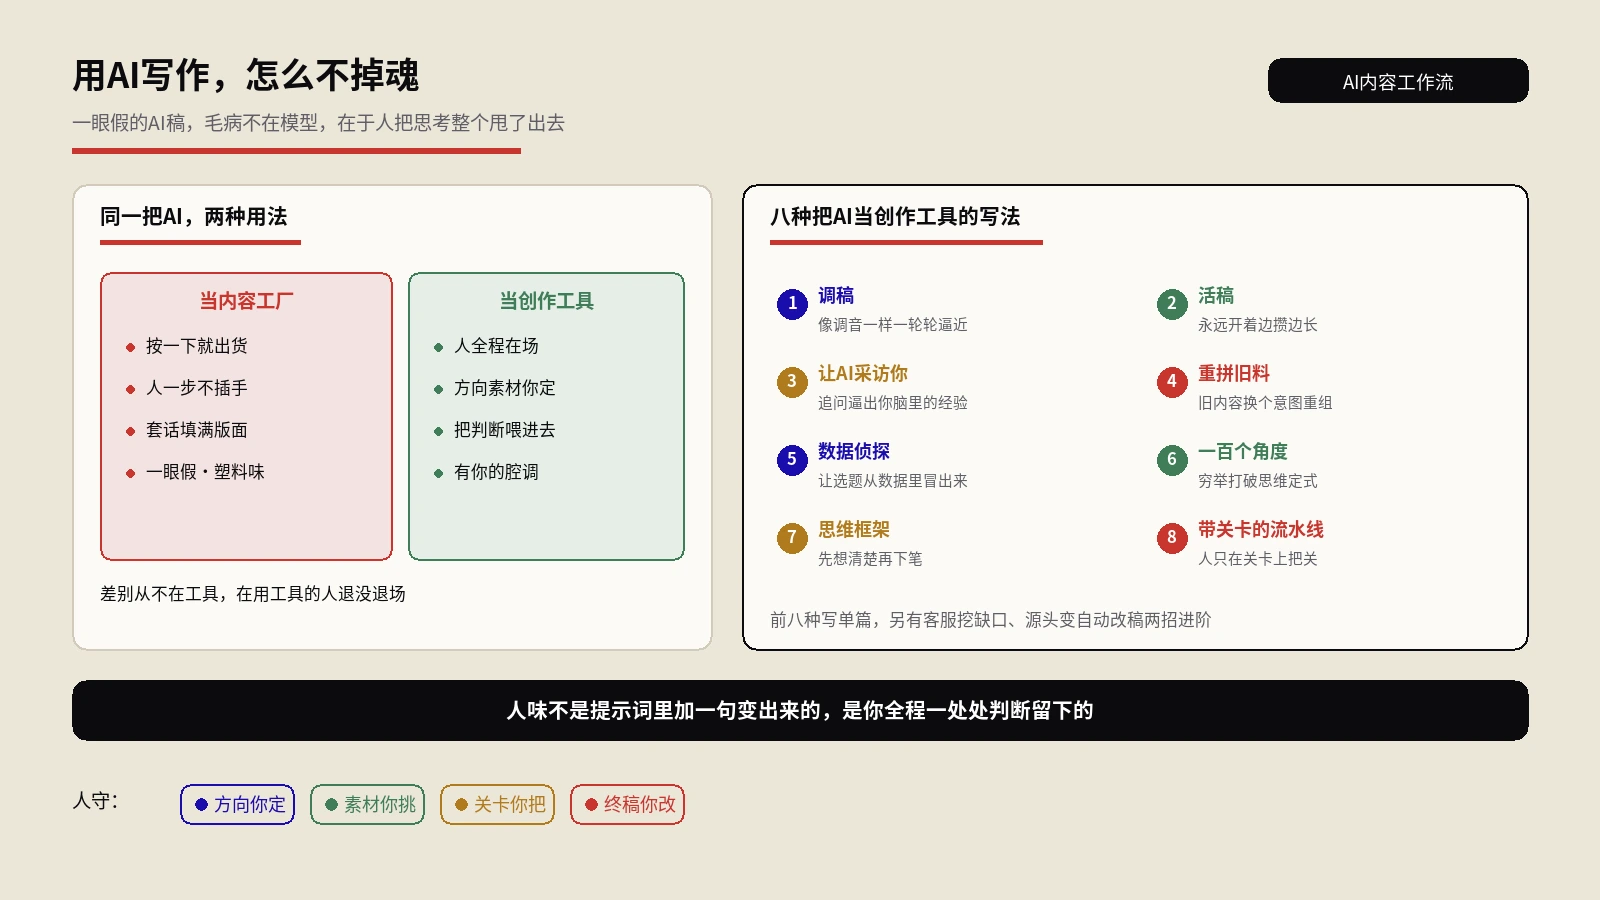
一眼假的AI稿,毛病往往不在模型,在于人把思考整个甩了出去。想让成稿还带着你的腔调,关键是全程别退场。本文拆开调稿、活稿、让AI采访你、重拼旧料、数据侦探、一百个角度、思维框架、带关卡的流水线八种写法,配一张什么内容用哪种的决策表,讲清人味从哪保住。
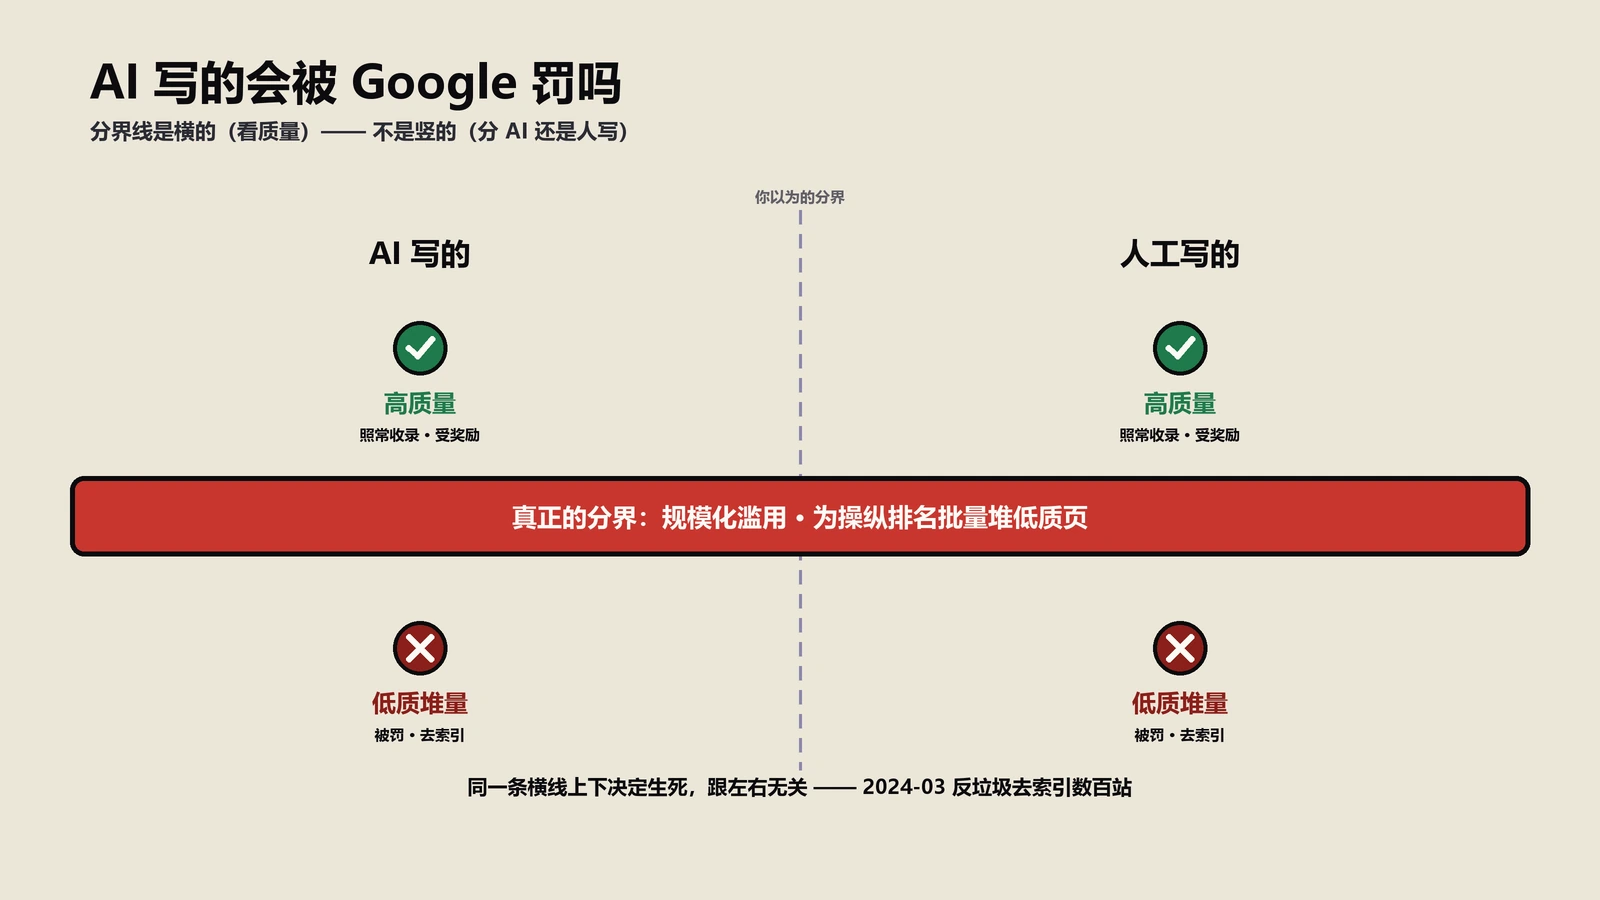
很多人怕用AI写作被Google降权,其实Google从没惩罚过AI内容本身。这篇用官方原话和2024年3月那波更新讲清:被罚的是规模化灌水,人写照样罚,并附上安全用法与红线清单。
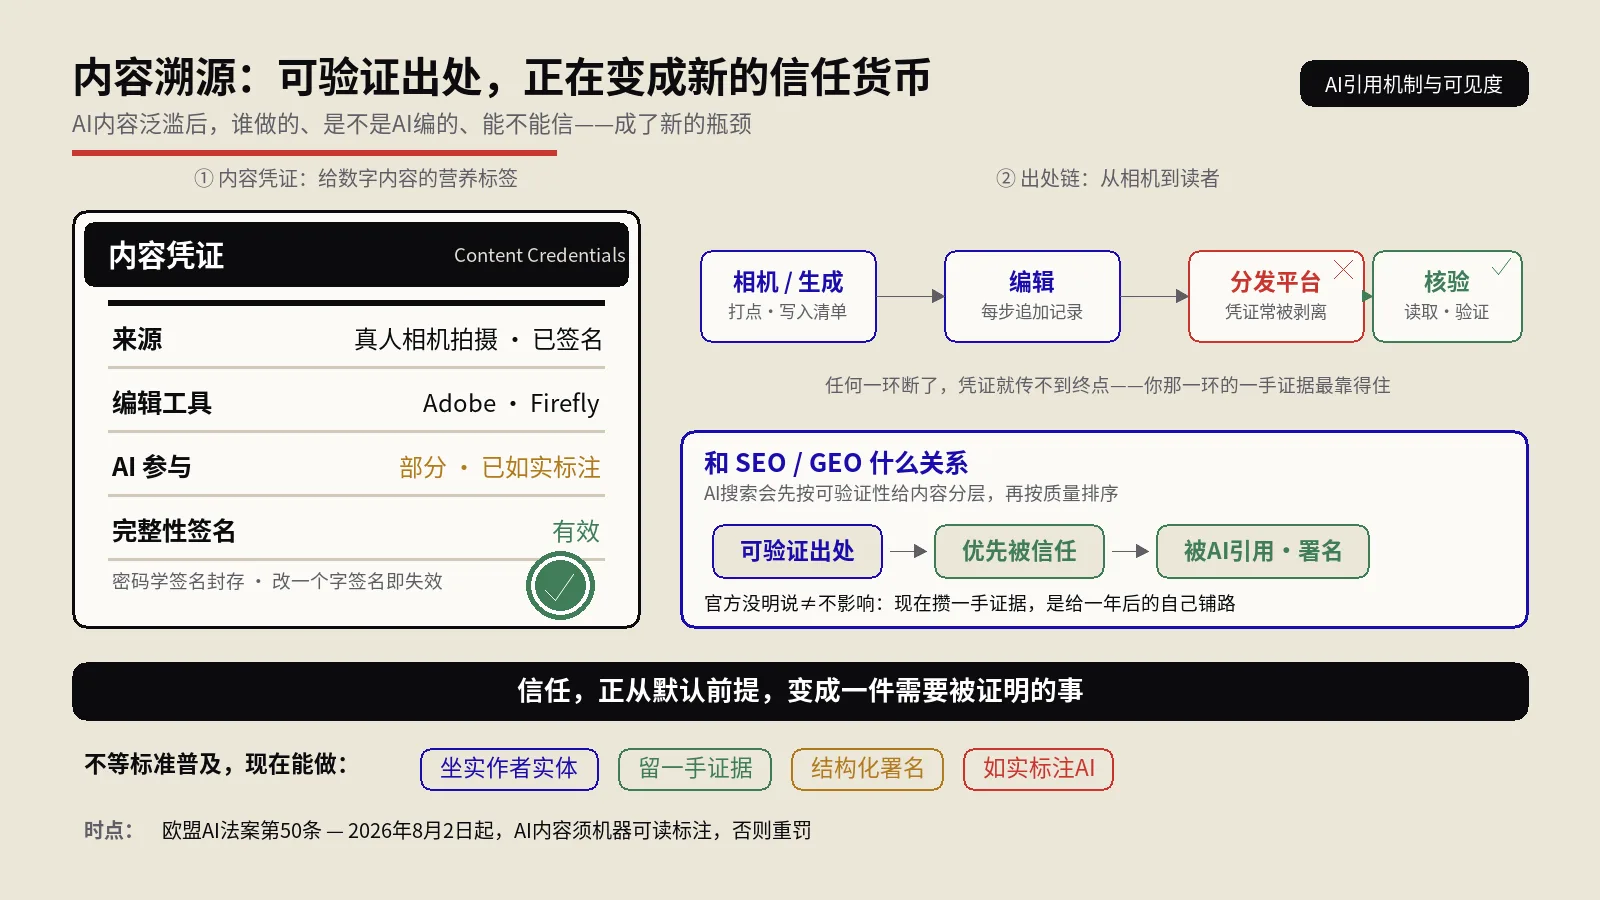
内容溯源(C2PA内容凭证)正从合规话题变成AI搜索的排序信号。本文讲清它是什么、密码学签名怎么运作、和GEO的真实关系,以及独立站主现在能落地的7件事,附一次真实的踩坑复盘。
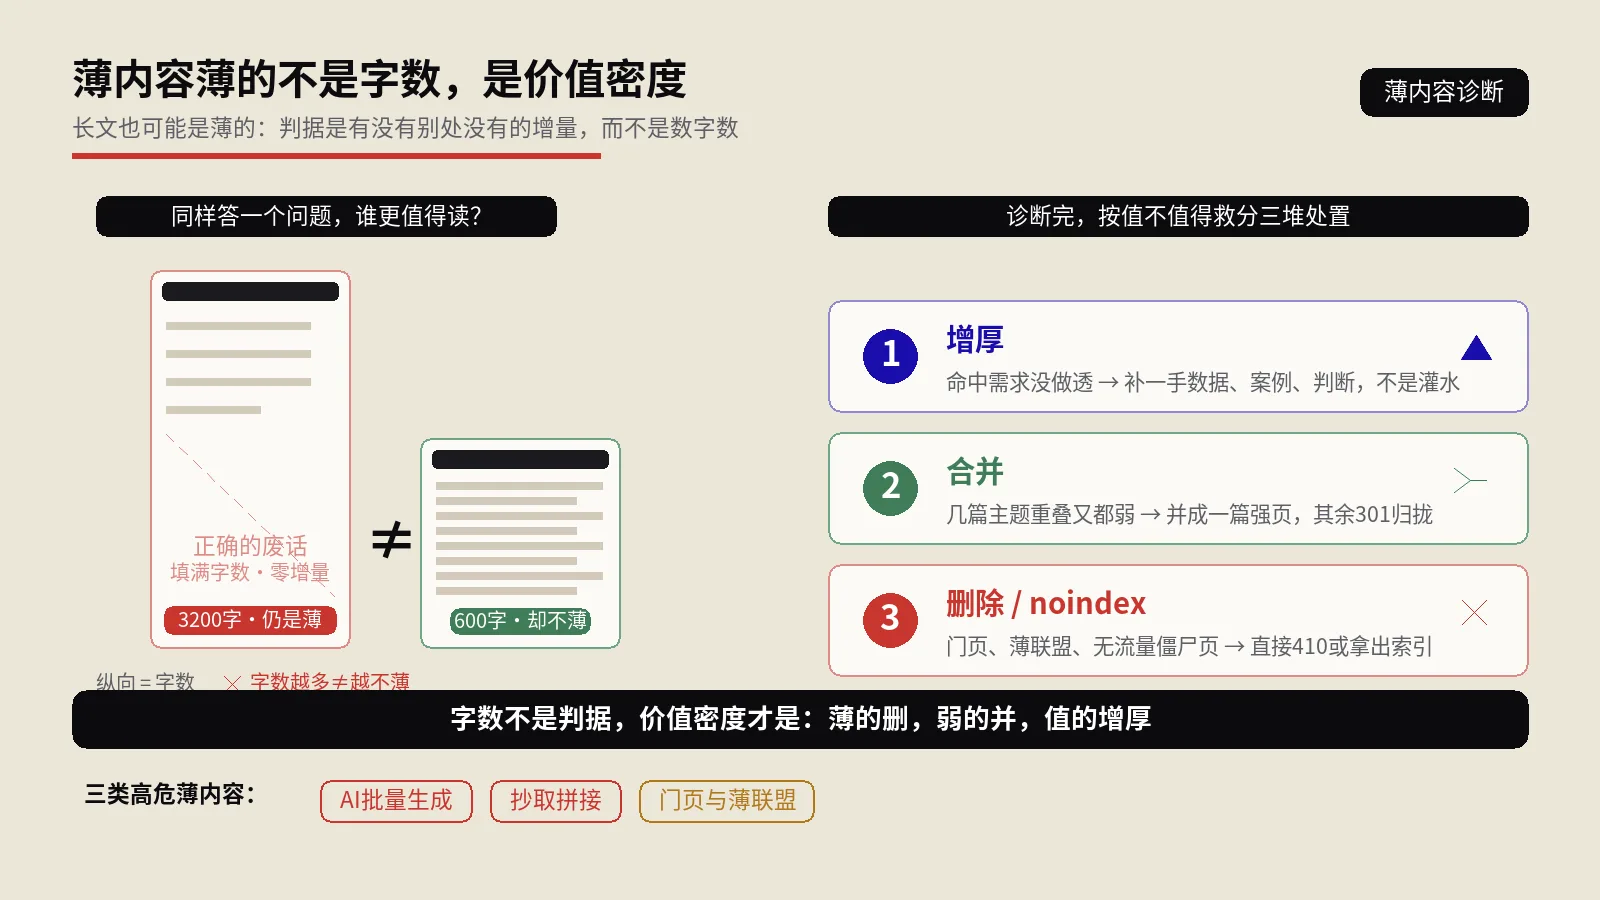
薄内容薄的不是字数是价值密度。这篇从熊猫算法讲到2024年规模化内容滥用政策,给出六类薄内容对号入座、为什么长文也可能薄、诊断四步和增厚合并删除重写的修复决策树,帮你把稀释全站质量的薄页系统清干净。
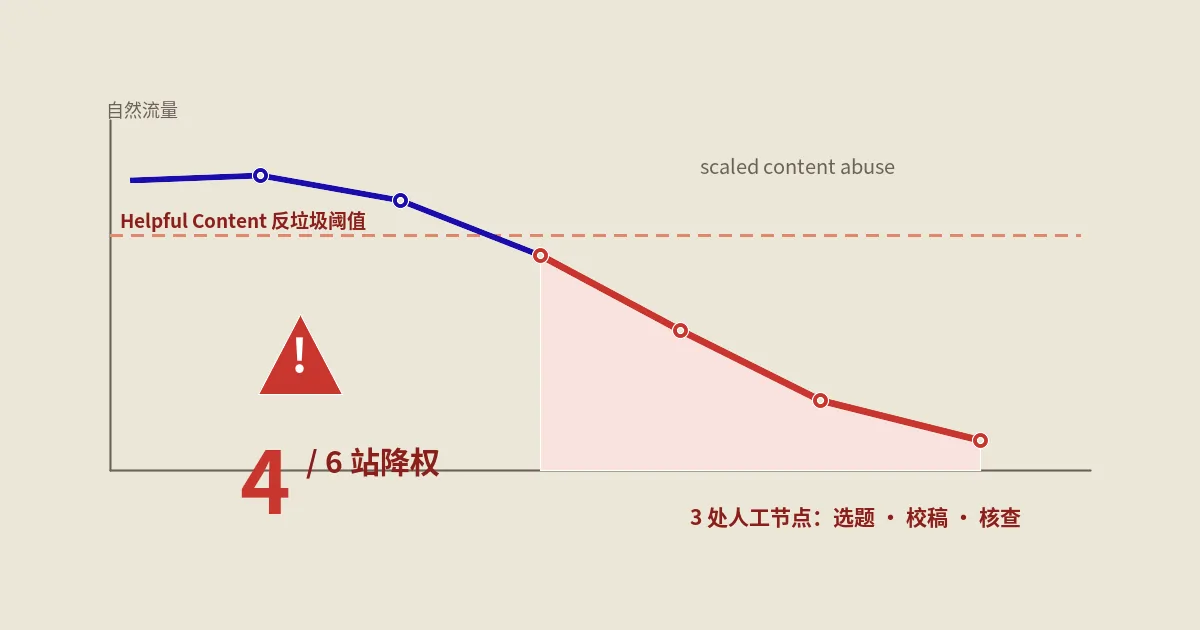
AI内容生产流水线踩过的6个独立站案例真实复盘:DTC美妆站每天50篇被算scaled content abuse的边界识别、B2B SaaS站AI翻译批量发布的去索引路径、跨境母婴站AI改写竞争对手内容触发的Helpful Content降权机制、Marketplace站AI自动SKU描述的集体掉权、活下来的测评站与Headless媒体站AI流水线的合规设计;Google反垃圾政策2024年3月更新对AI内容边界的具体红线、3处必须保…
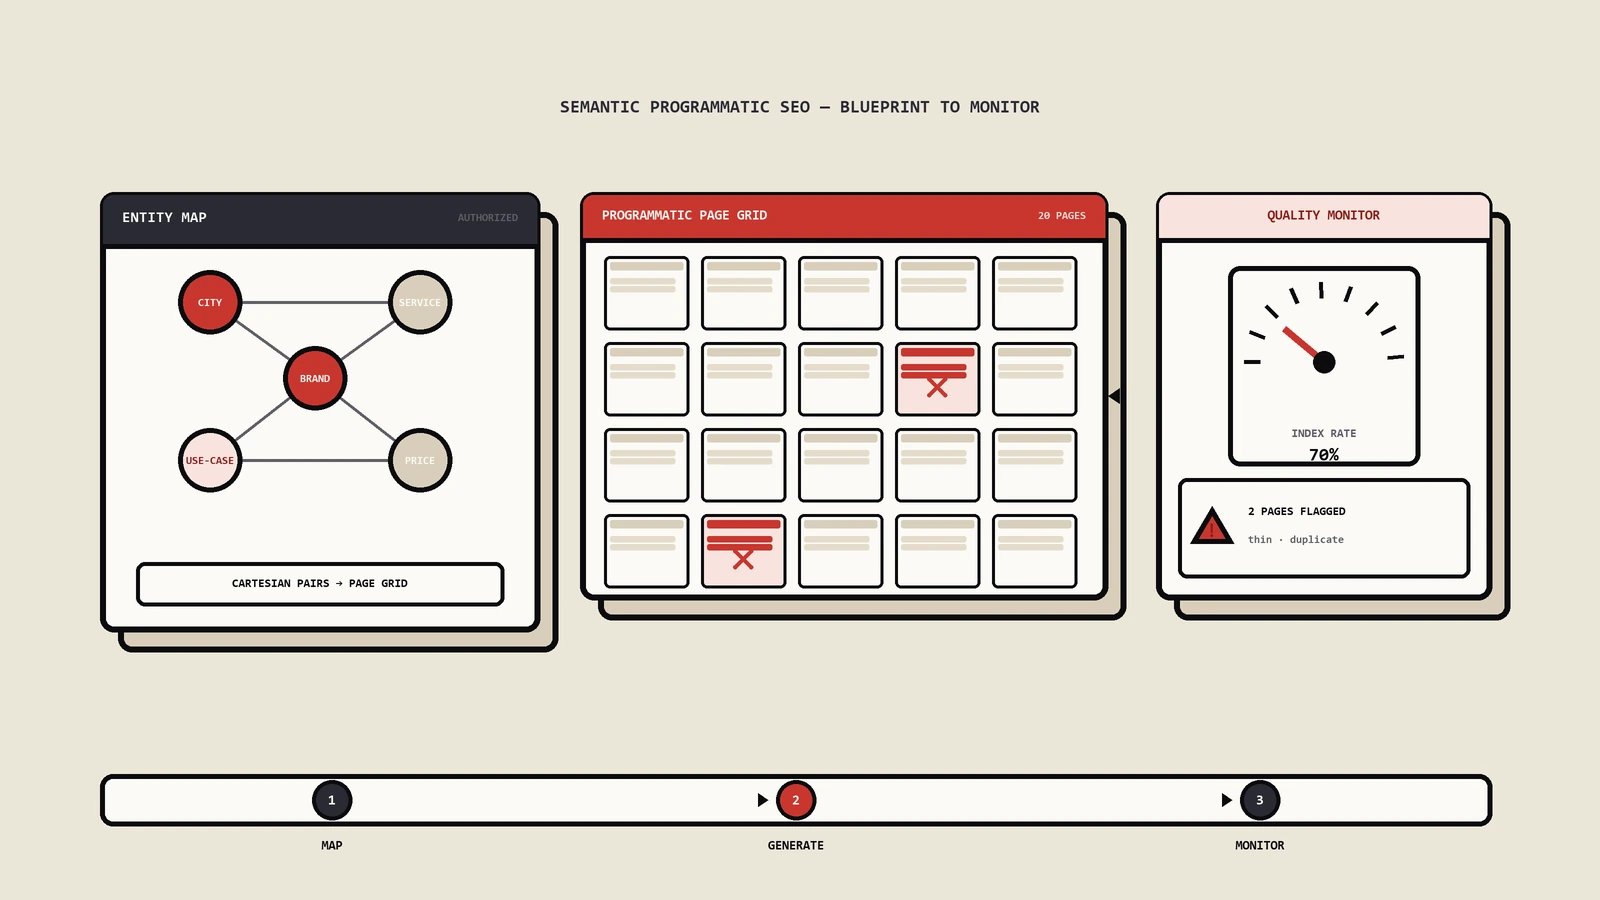
很多人一听程序化SEO就想到批量复制城市名灌出几千个垃圾页,结果被Google按规模化滥用整片打掉。这篇把老式模板填空和真正能跑的语义化做法掰开讲:从GSC授权地图怎么定能打的范围,到品牌护栏怎么防AI写跑偏,再到上千页面怎么靠语义网不变孤岛,最后给一套能照着落地的流水线和踩坑兜底。
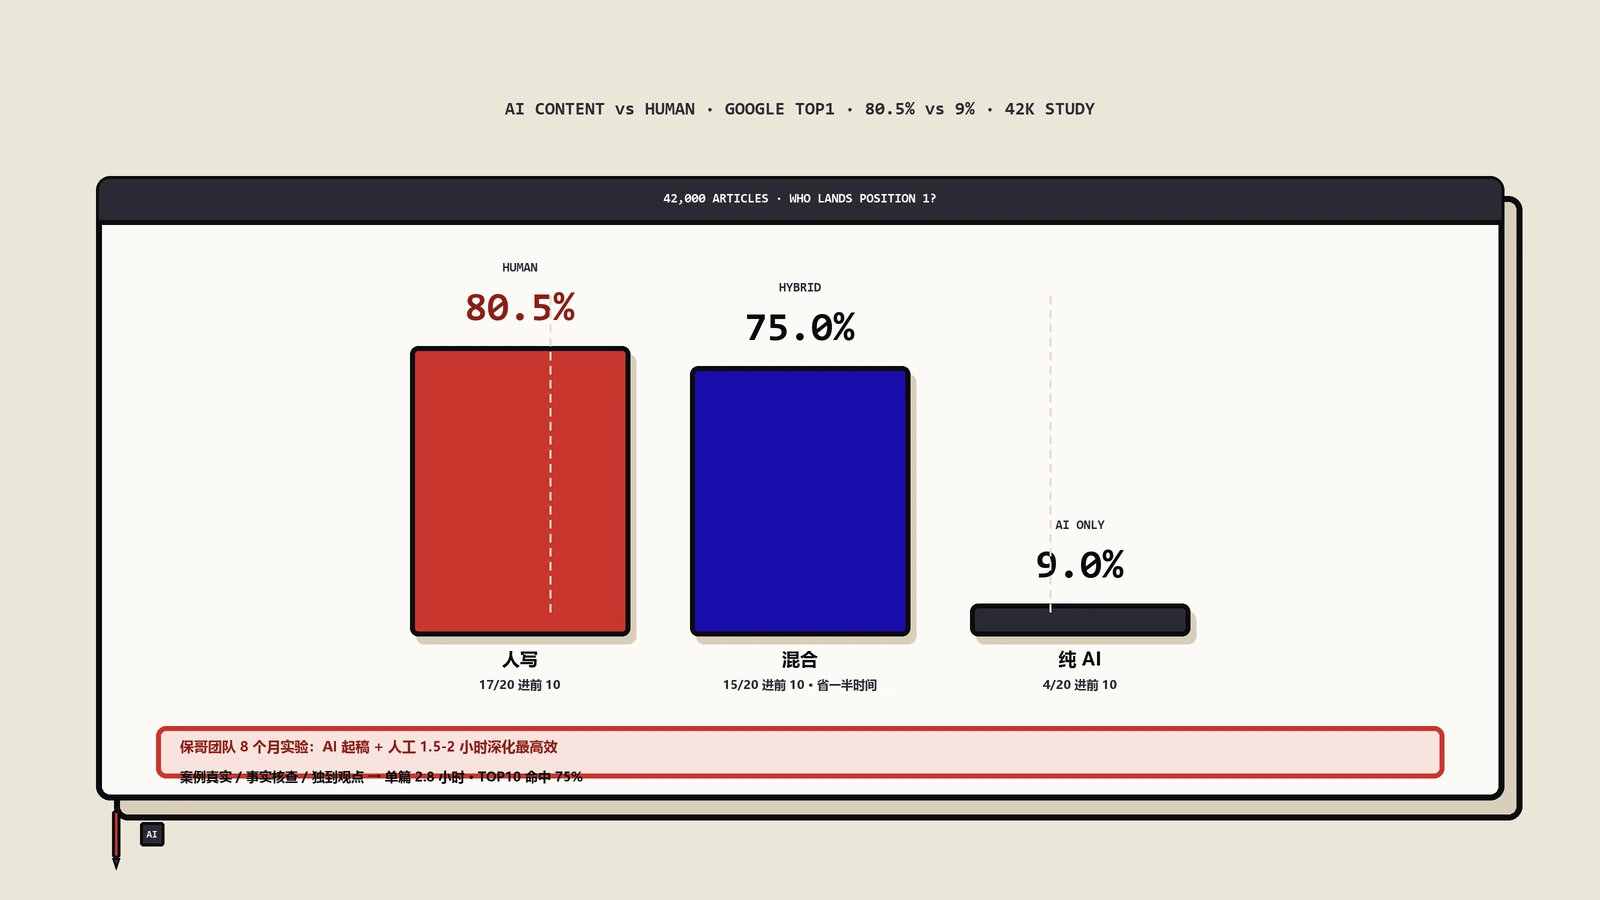
基于42000篇博客文章实测数据,人工内容登顶Google第1名的概率是AI内容的8倍。保哥深度解读研究方法论局限、排名分层逻辑、SEO从业者认知错位、E-E-A-T差异,并给出5个站点8个月对照实测和AI加人工协作的5步最优流程。
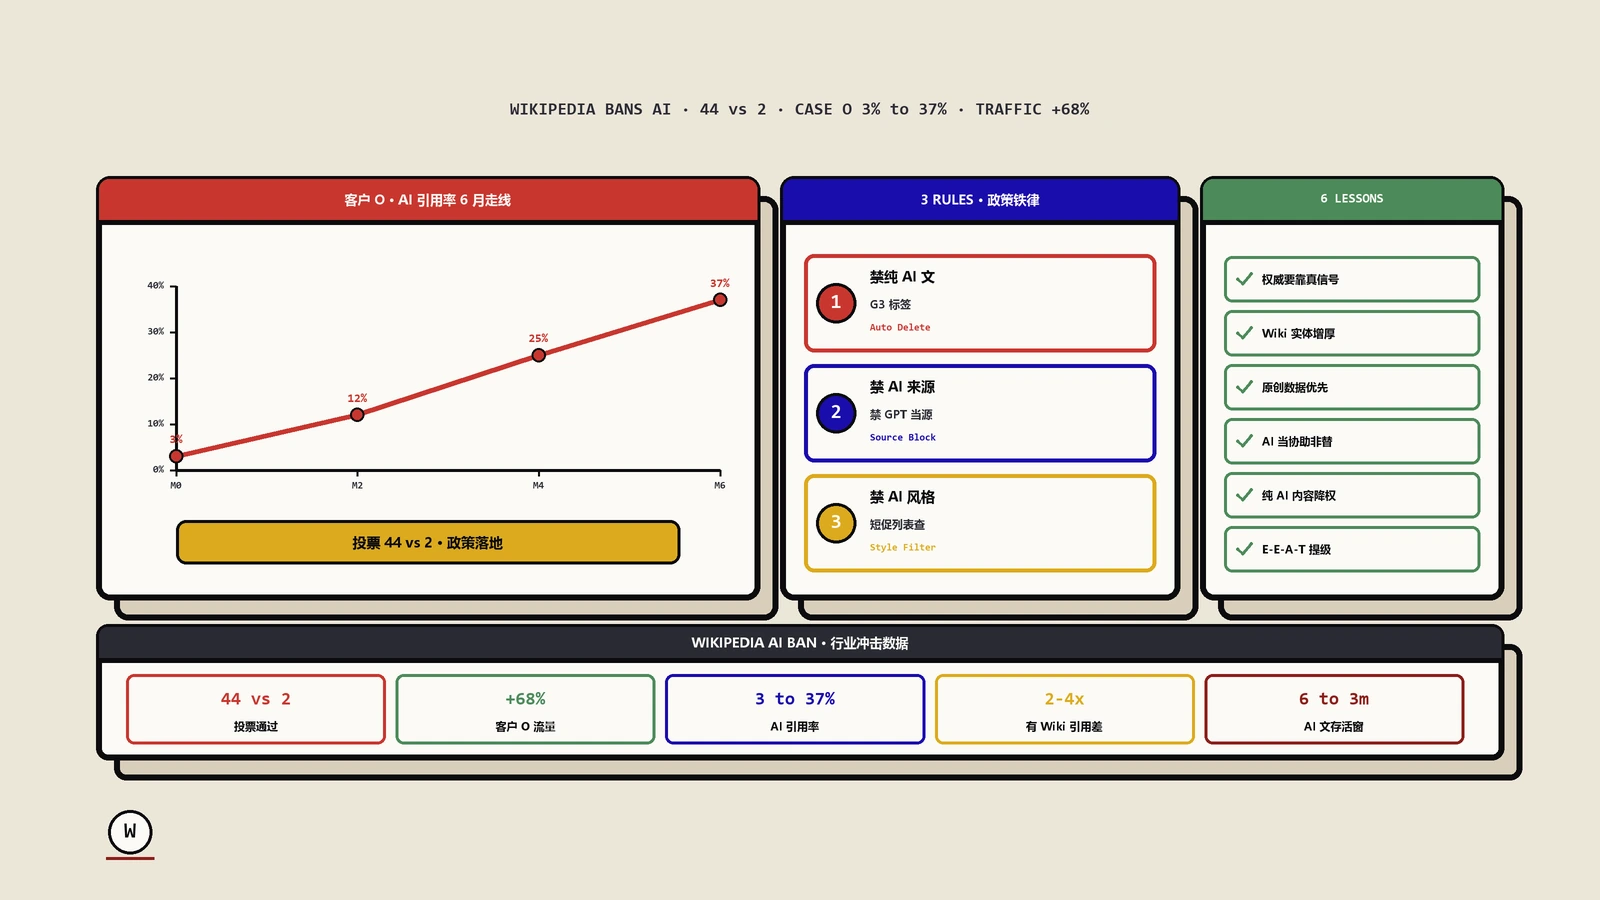
2026年3月20日英文维基百科以44比2的压倒性结果正式禁止AI生成内容。这不只是平台政策,更是全球权威信息生态的连锁信号。本文剖析三大被触犯的政策铁律、TomWikiAssist Agent事件全程、维基百科为何是SEO风向标,并给出6个深层启示、6类站点差异化策略、90天权威化日历以及客户O的6个月转型案例。
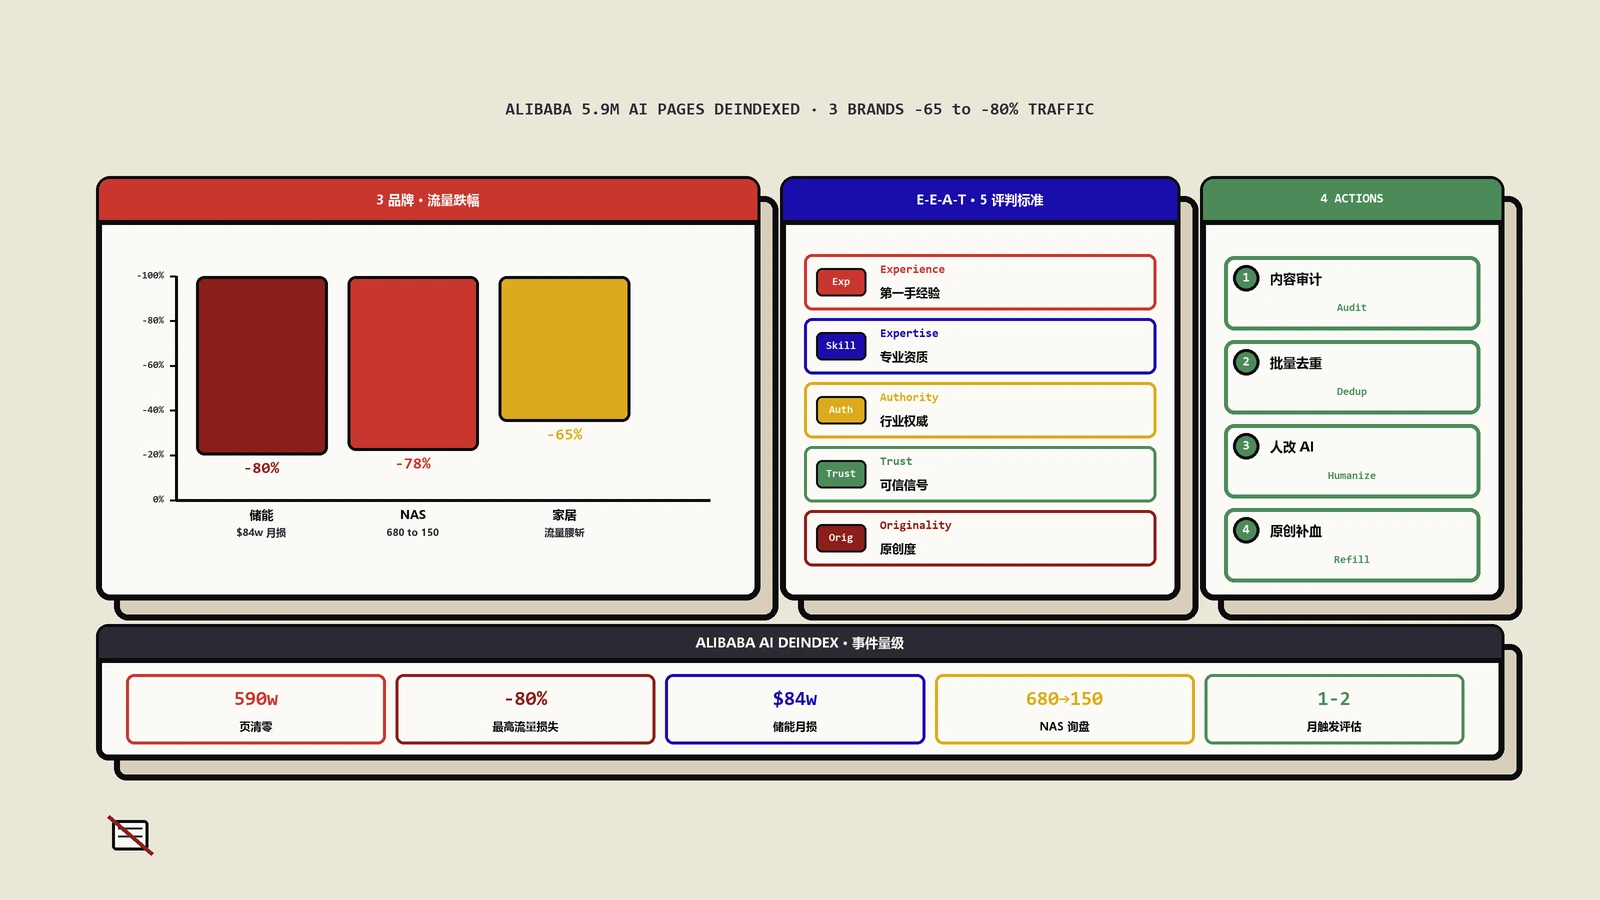
阿里巴巴国际站product-insights板块590万AI页面一夜被Google清零,国内DTC独立站同期流量集体断崖。本文还原事件、拆解SpamBrain与E-E-A-T评判逻辑、给出3家品牌真实翻车数据对比,并提供从内容审计到信任重建的7步自救方案。
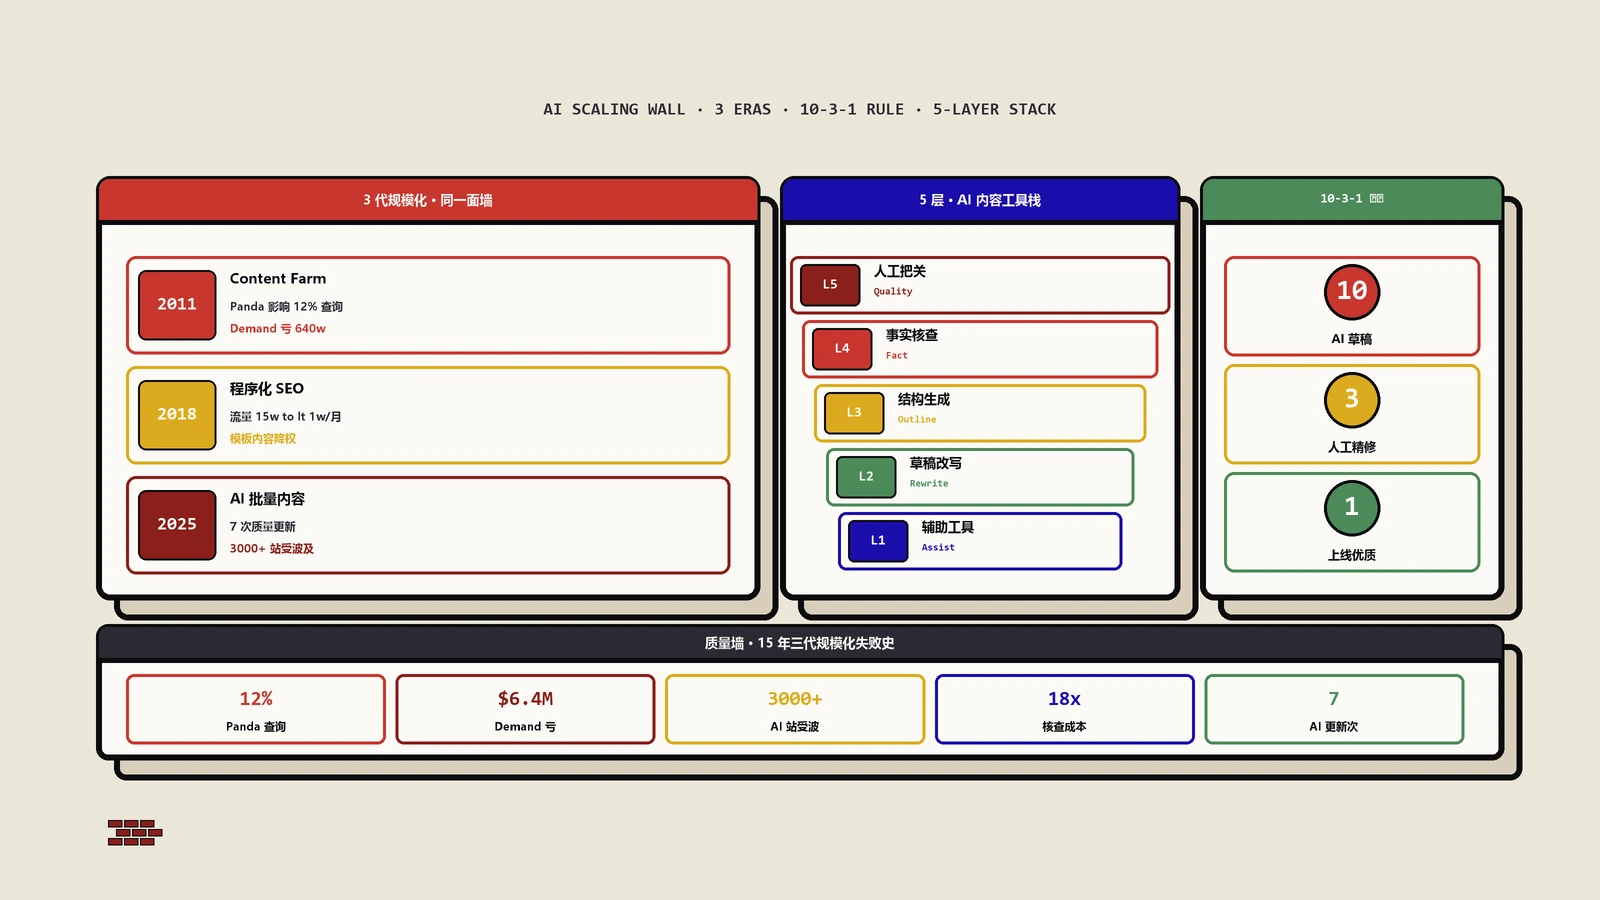
AI每月生产500篇就是真的规模化内容吗?保哥用15年三代规模化失败史告诉你为何质量墙不可逾越,并给出10-3-1法则、五层AI工具栈和3个对照站点案例的可落地内容策略。
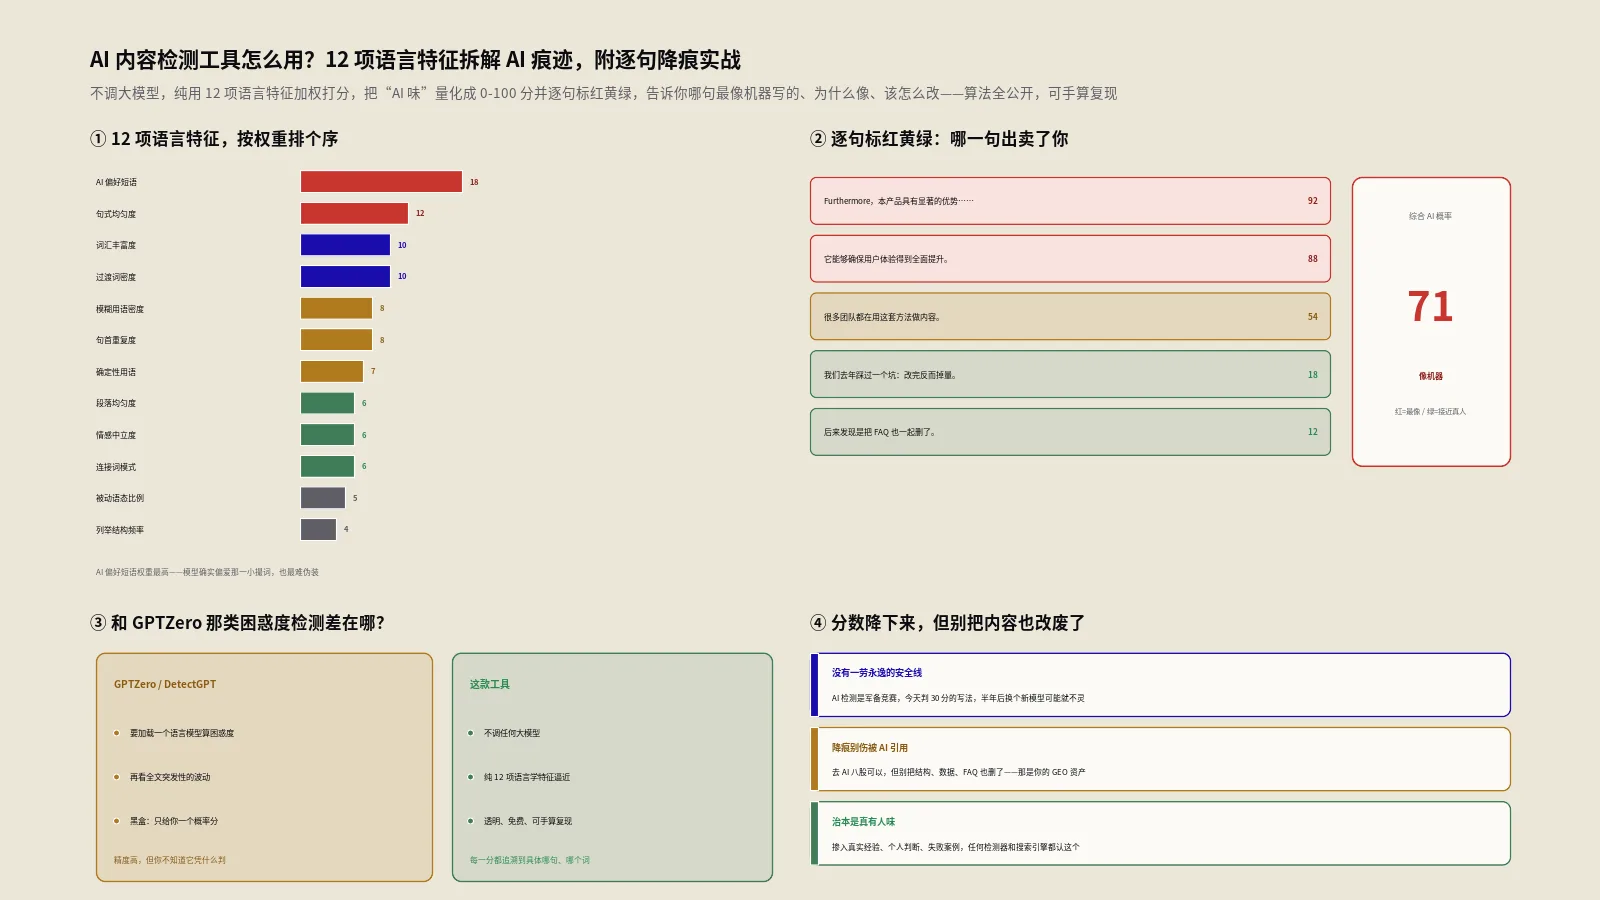
一篇稿被检测器判成AI生成,先别急着重写。AI味是可测量的语言指纹,这款工具拆出12项特征告诉你哪句最像机器、为什么、怎么改回真人腔。
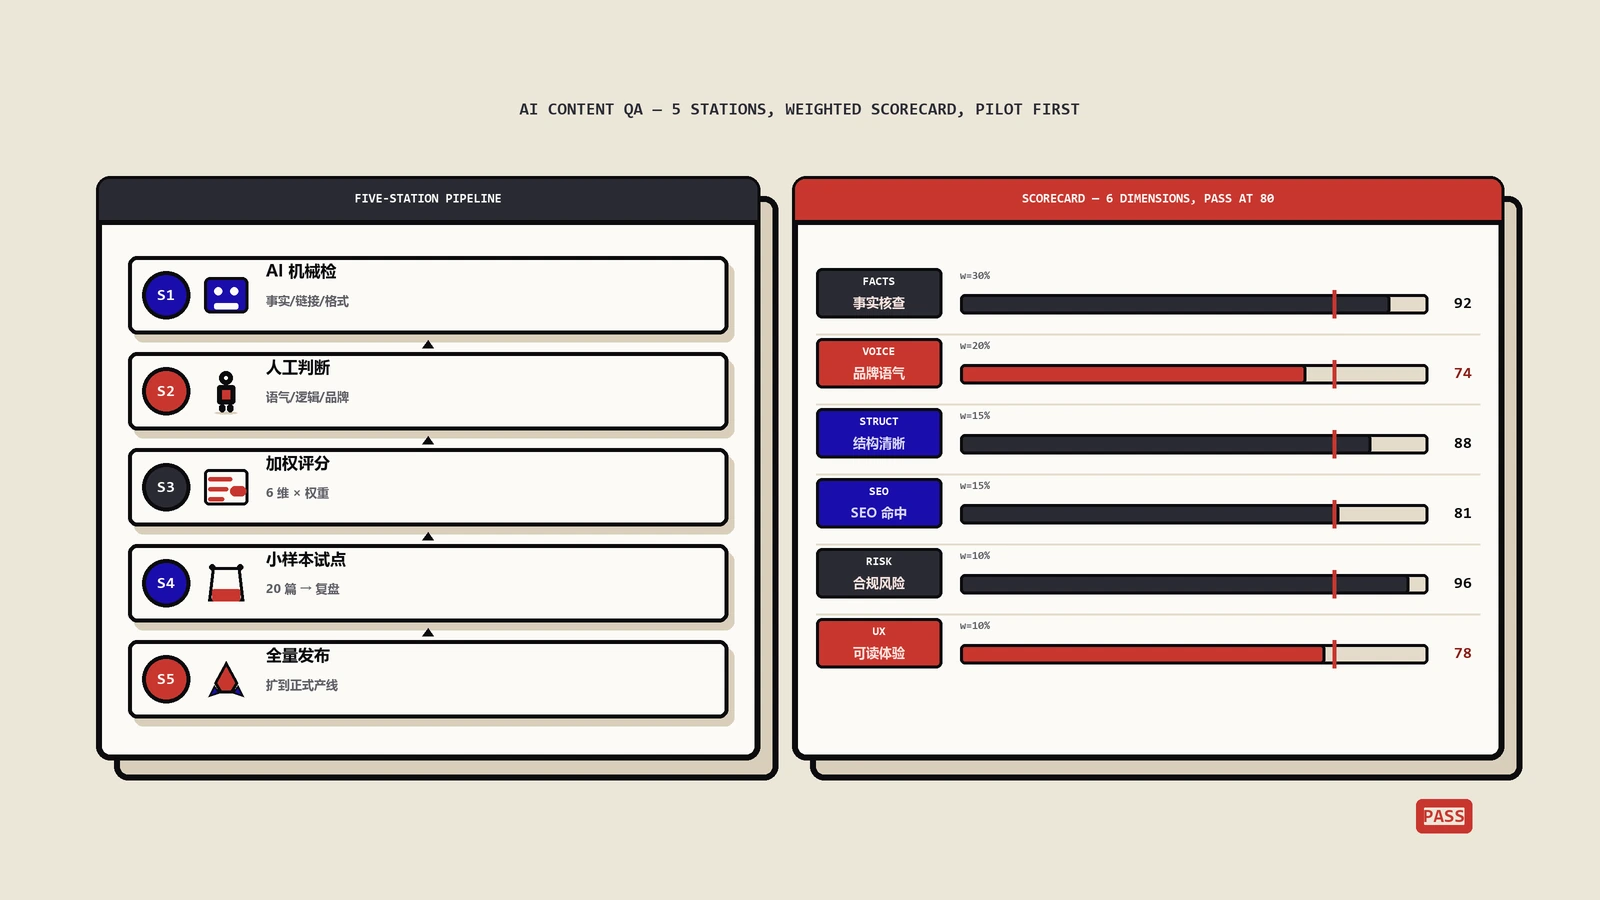
AI 内容规模化最容易崩在质检这一环,而崩的往往不是模型是流程。这篇把人机分工的质检流水线拆开讲:哪些检查交给脚本和 AI、哪些必须人来判断、加权评分卡怎么设一票否决项、事实核查协议怎么落地、为什么必须先试点再放量,并附一份能直接抄走的分层质检清单。
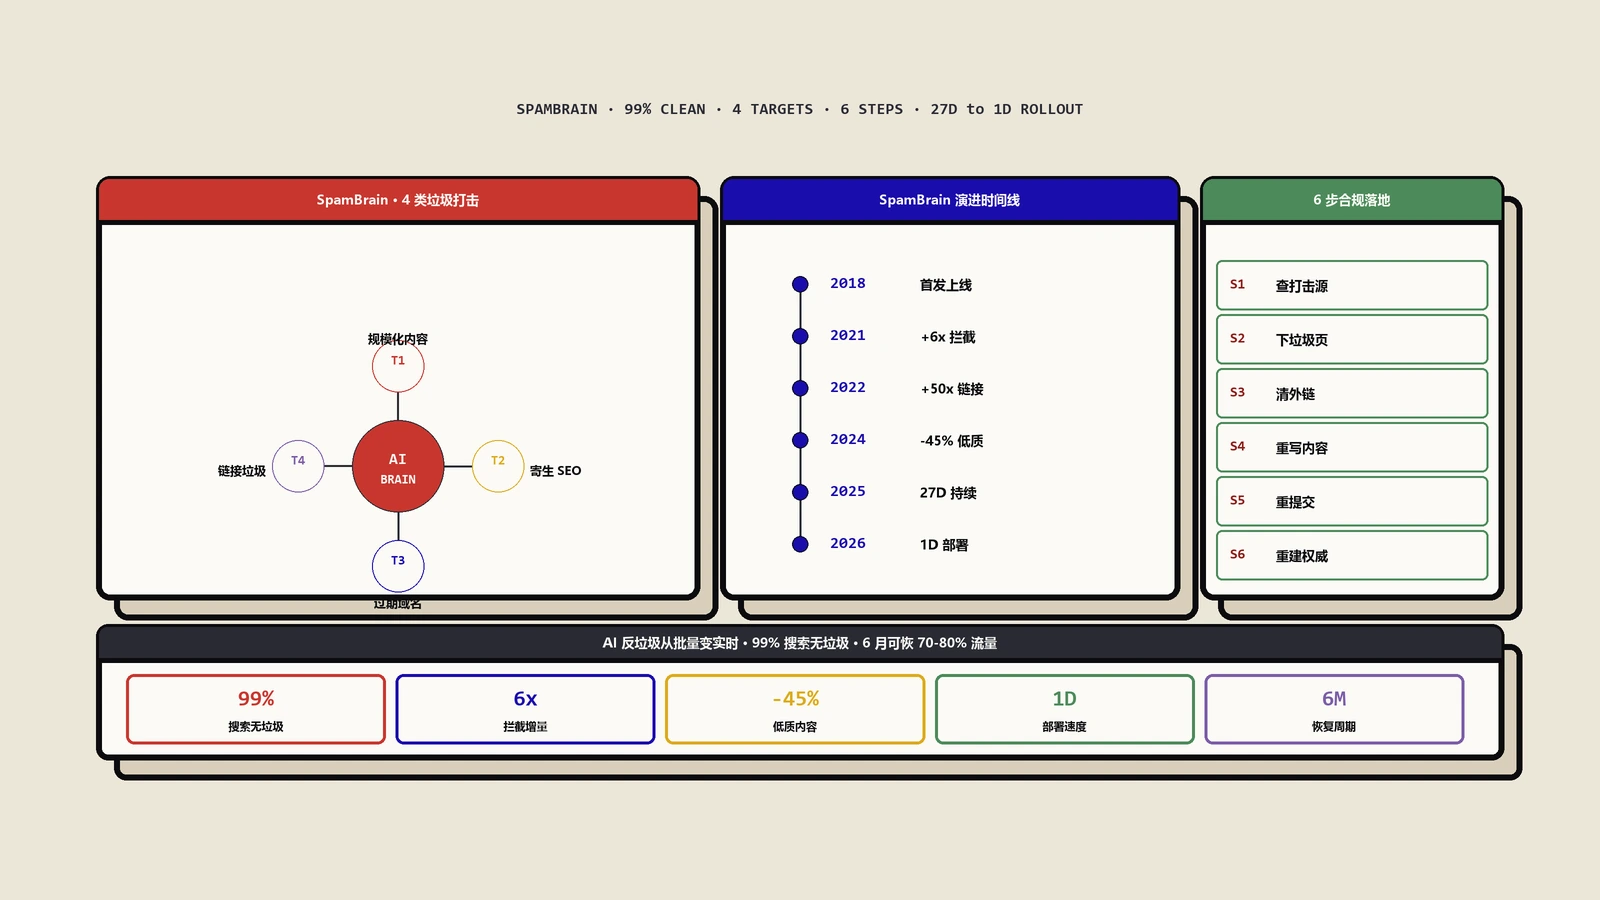
Google SpamBrain已部署8年并完成多次升级。这篇拆解它的底层机器学习原理、爬取阶段拦截机制、四类重点打击行为(规模化内容/寄生SEO/过期域名/链接垃圾),配3个真实客户被打击后6个月恢复数据。