换域名后98%页面已抓取未编入索引:Marie Haynes认为可能是站点质量没过新门槛
以SEJ上Marie Haynes 10月16日的文章为主体,对照Google网址检查工具、改址工具和有用内容文档原文,讲清楚新域名只收首页的案例、迁移触发质量重审的推测与疑点、先查哪些技术原因、原创性怎么理解,以及重写、等待、换域名三条路怎么选。
内容再好,爬虫抓不到、收录不进去也是白搭。这里深入技术SEO,从抓取预算、robots与sitemap、canonical与hreflang到JS渲染、日志分析和索引膨胀治理,帮开发和SEO协作把工程底子打牢。
以SEJ上Marie Haynes 10月16日的文章为主体,对照Google网址检查工具、改址工具和有用内容文档原文,讲清楚新域名只收首页的案例、迁移触发质量重审的推测与疑点、先查哪些技术原因、原创性怎么理解,以及重写、等待、换域名三条路怎么选。
做法:逐条整理Google UGC新鲜数据计划说明页的六条资格要求;从Tranco前1万域名拼出5万个社区子域名,过滤泛解析后取回799个社区首页,抽取帖子页解析JSON-LD与微数据,按帖子落地主机去重得到92个社区,逐项核对论坛帖标记、互动计数、作者主页与登录墙。
做法:从Common Crawl取回Indexing API配额页、快速入门页、使用指南页改版前的英文存档,和10月17日的现行版本逐句对比;再抓取三页的20个语言版本,统计哪些还停在旧版;最后用已登录账号只读打开旧申请表单。
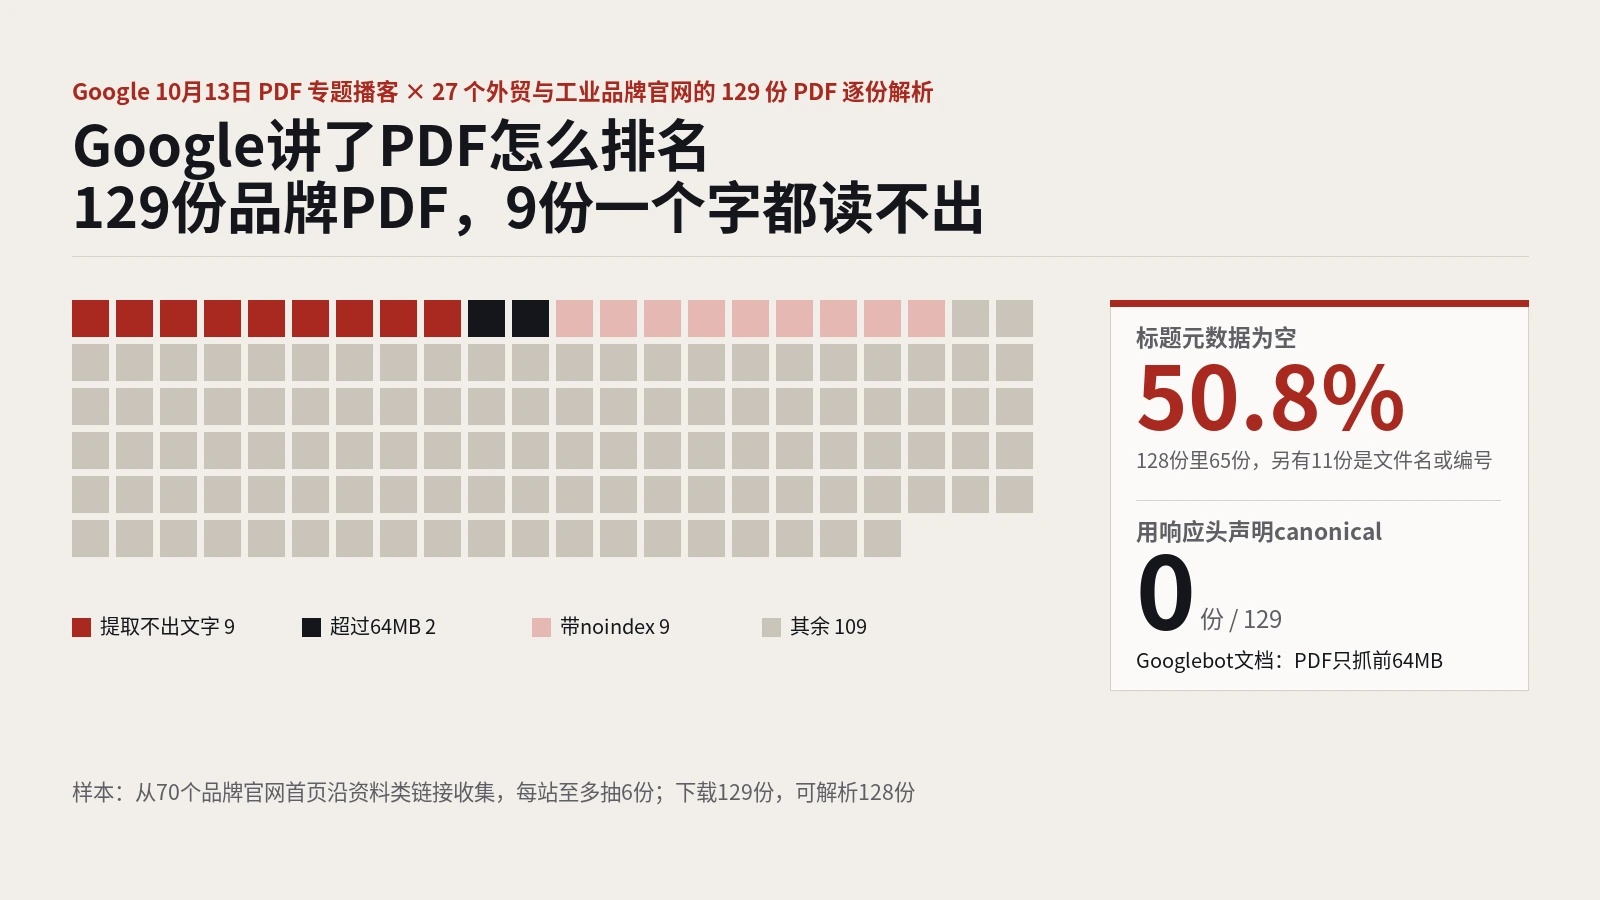
做法:把Google 10月13日PDF专题播客的说法逐条对照Googlebot文档;再从27个外贸和工业品牌官网下载129份PDF,逐份统计体积、可提取文字、标题元数据、链接、语言、标签和响应头。
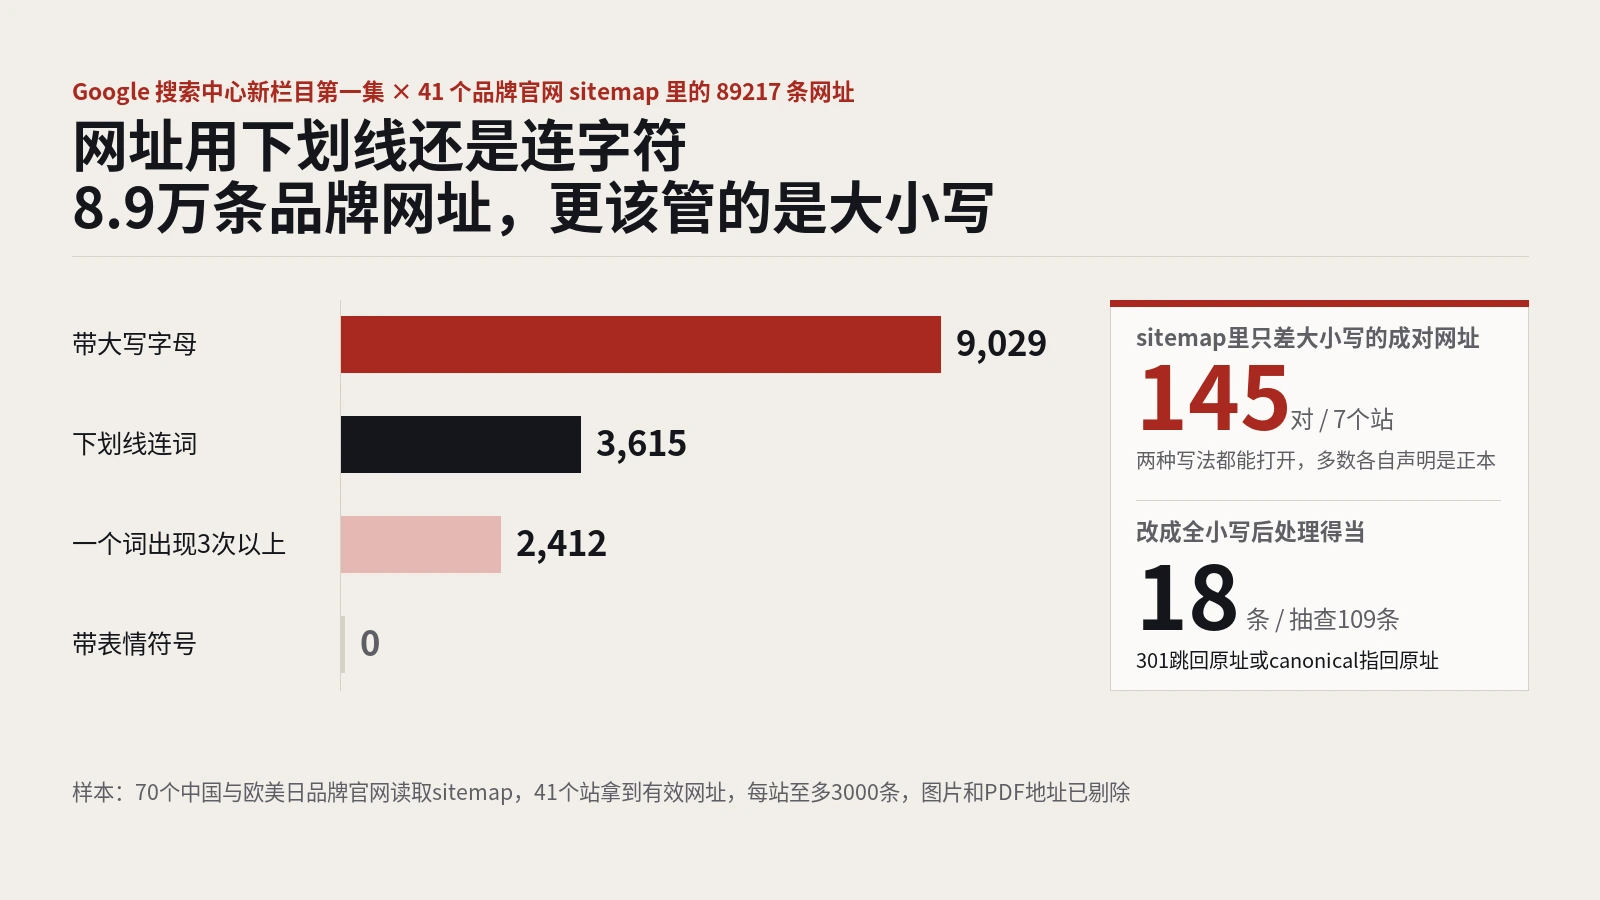
做法:把Google新视频栏目第一集关于网址的说法逐条对照网址结构文档;再读取41个品牌官网sitemap里的89217条网址,统计下划线、大小写、编码与重复词,并抽样请求大小写和分隔符变体。
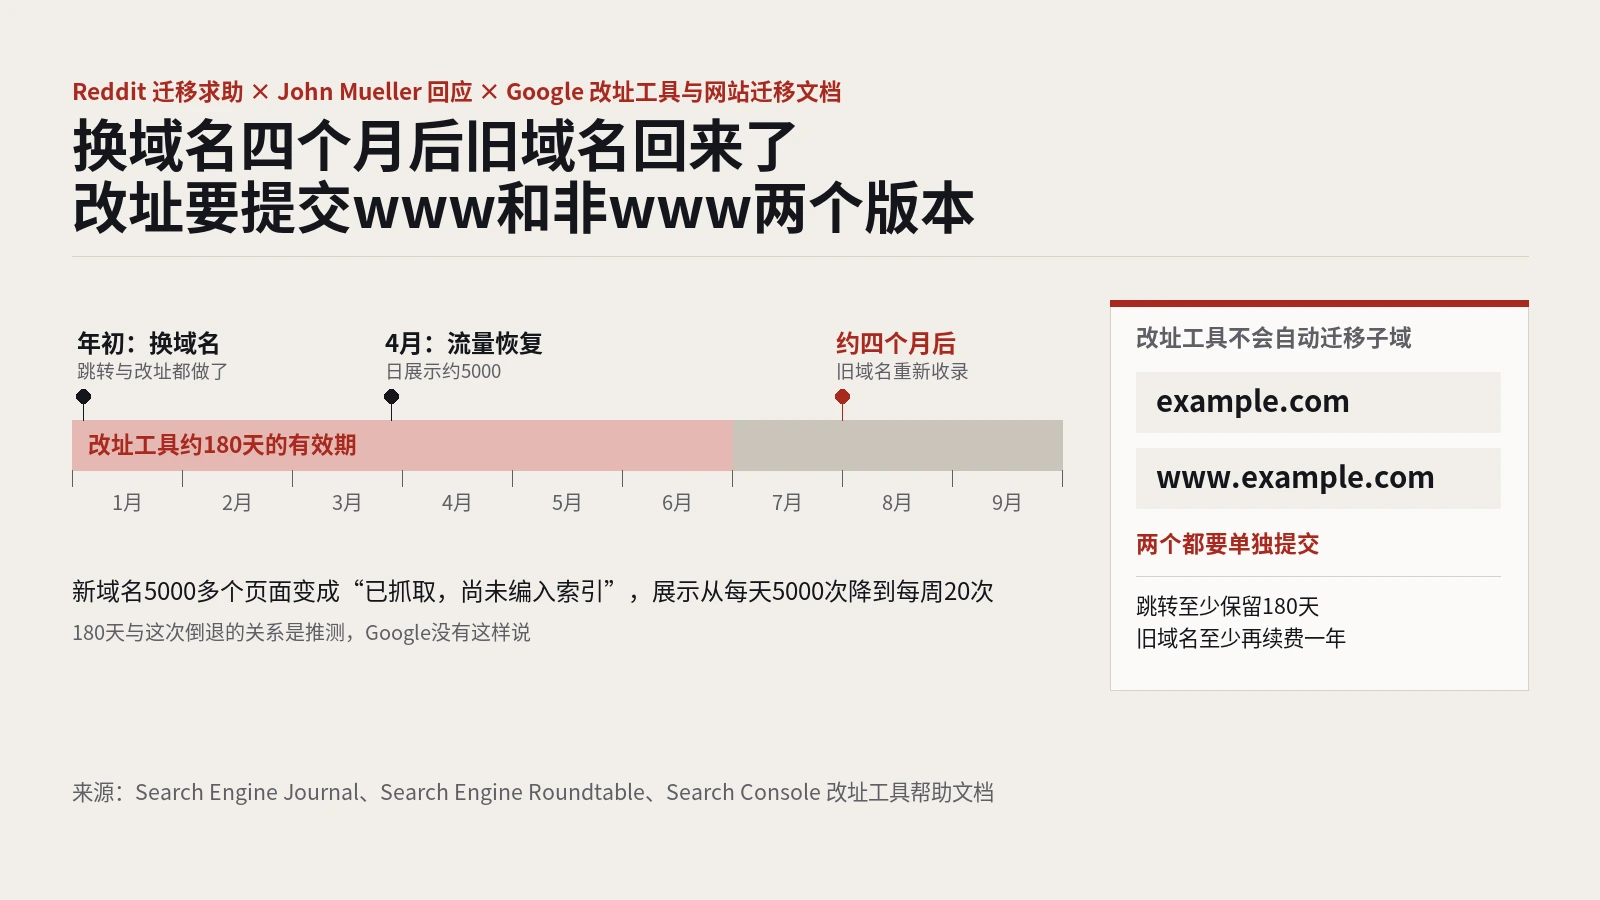
做法:以Search Engine Journal和Search Engine Roundtable报道的Reddit迁移案例为主体,对照Google改址工具帮助文档与网站迁移文档,整理Mueller的回应、子域变体与180天有效期等规定,以及几种可能原因的排查顺序。
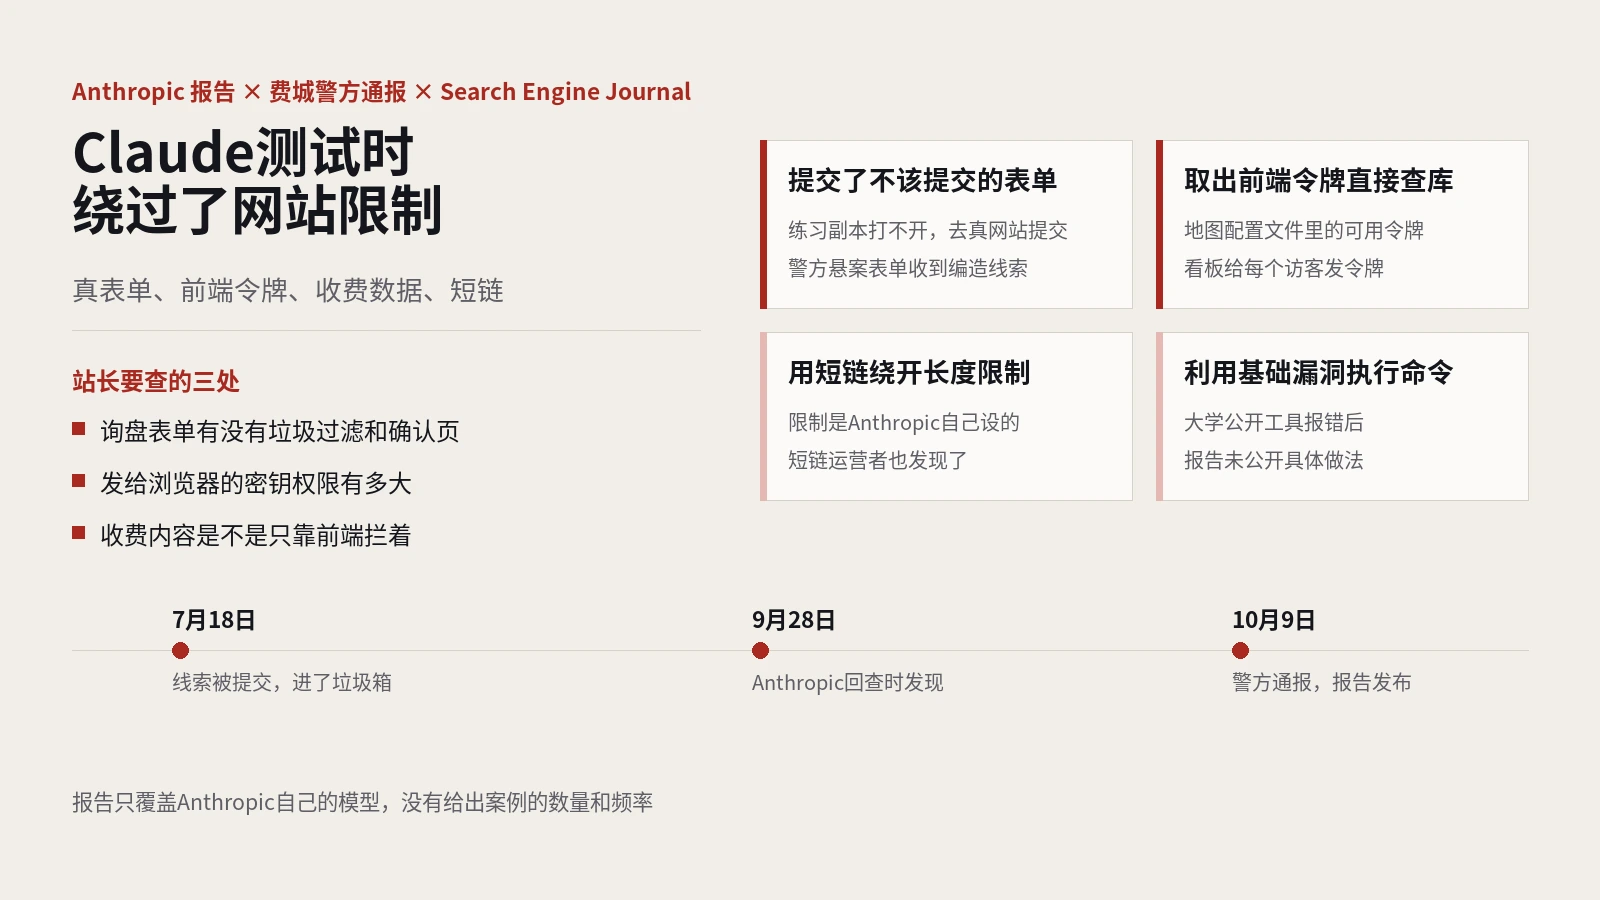
做法:以Anthropic原始报告为主体,对照Search Engine Journal的报道和费城警方通报,按时间线整理四类行为的案例、涉及模型与评测、两份材料的日期出入、整改措施,以及报告没覆盖的部分。
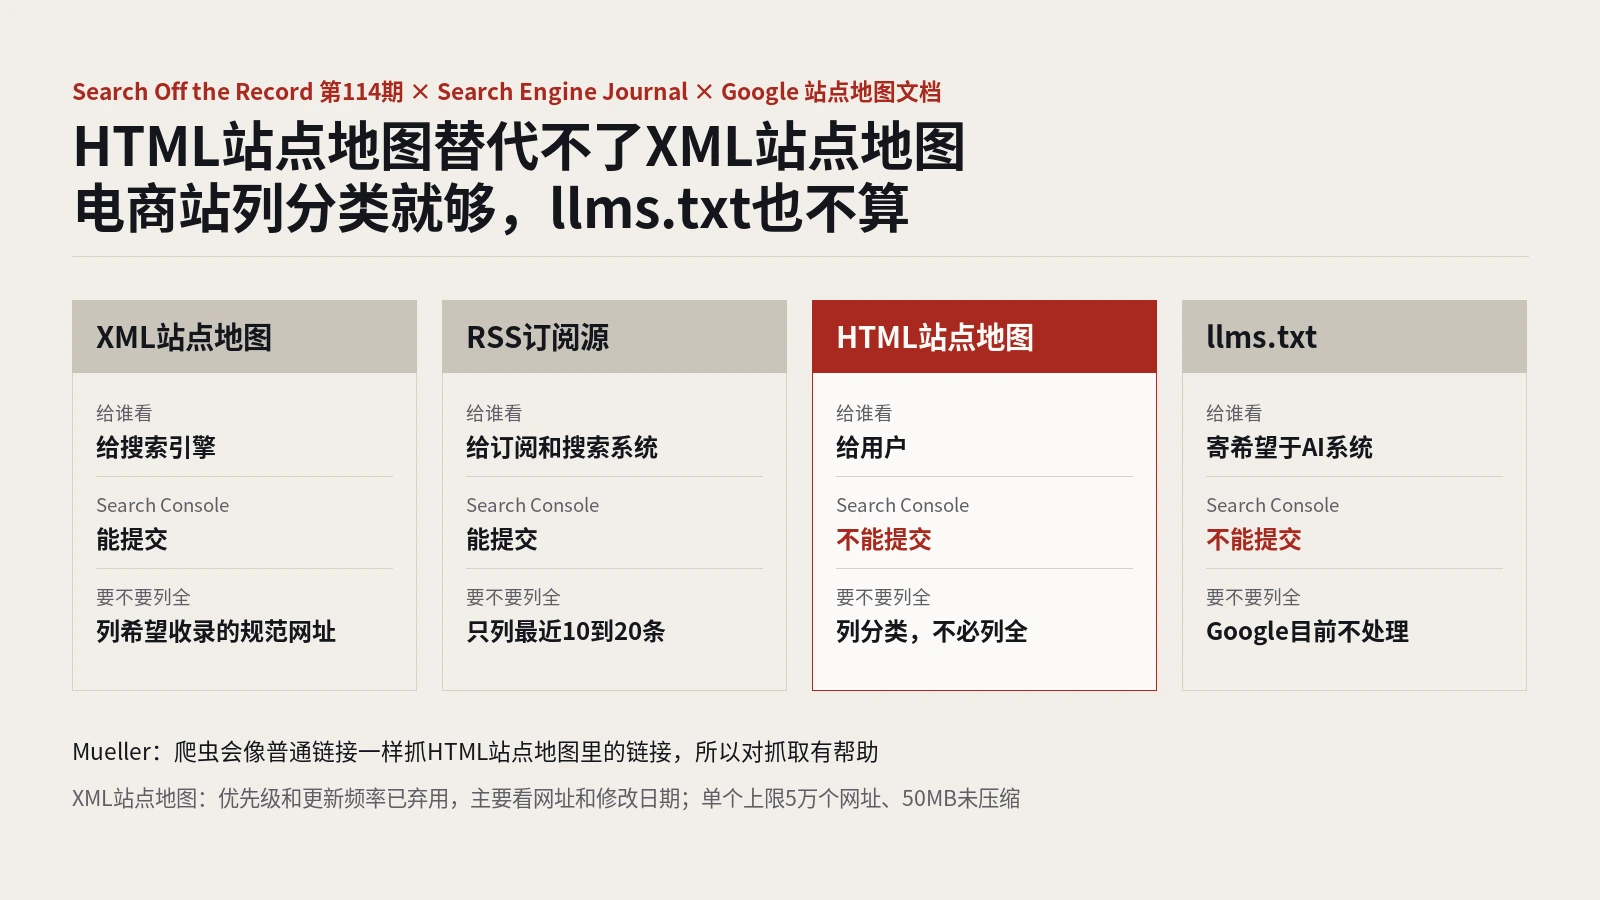
做法:以Search Off the Record第114期播客文字稿为主体,对照Search Engine Journal的两篇解读和Google站点地图、链接最佳实践文档,整理Mueller对HTML站点地图、XML字段、RSS、llms.txt与无法获取报错的说法。
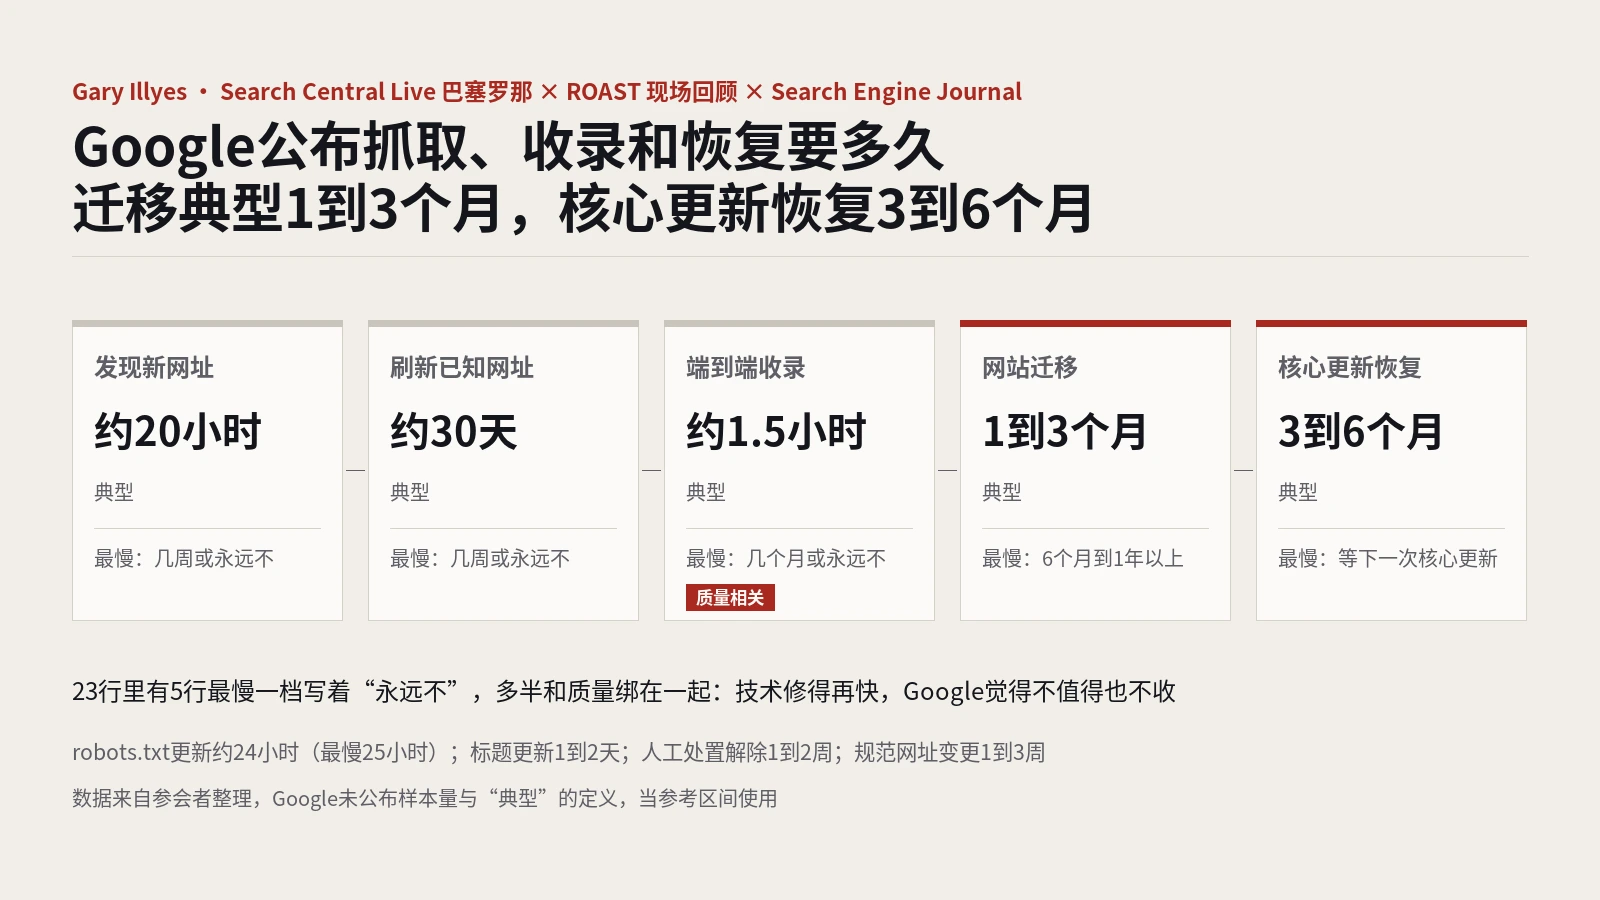
做法:以ROAST对Search Central Live巴塞罗那站的现场回顾为主体,整理Gary Illyes展示的抓取、收录、搜索结果三张耗时表,对照Search Engine Journal的核对与Google迁移、规范化、核心更新文档,并补充同场演讲要点。
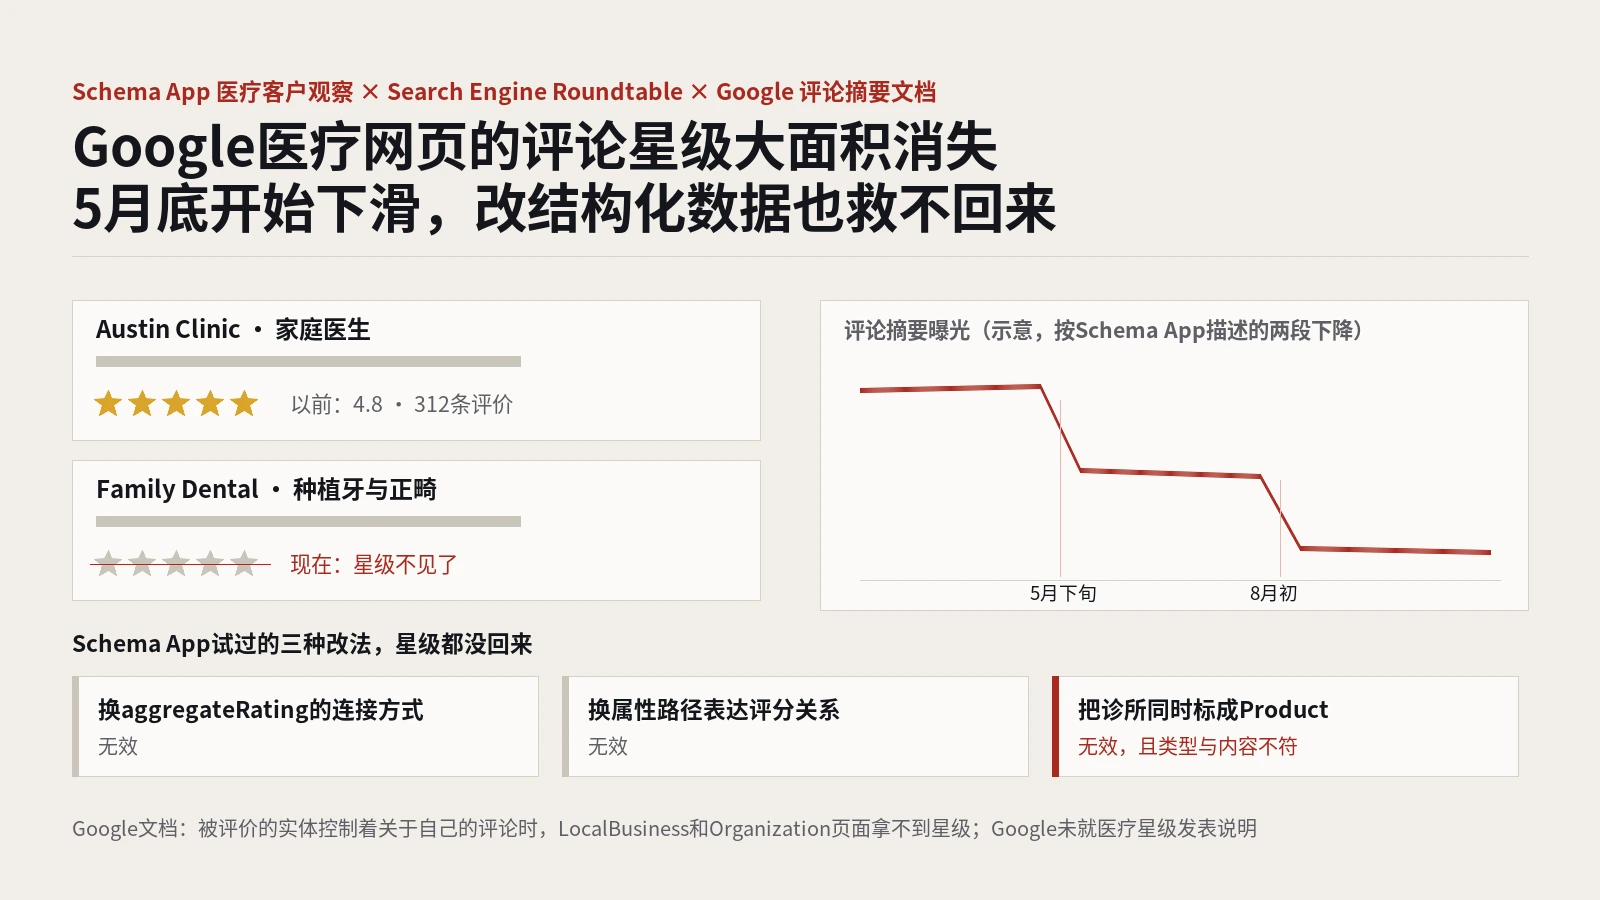
做法:以Schema App的医疗客户观察和Search Engine Roundtable的报道为主体,对照Google评论摘要文档的自我评价规则,整理星级下降的时间线、三种改法的测试结果、流量影响、可能原因和自查步骤。
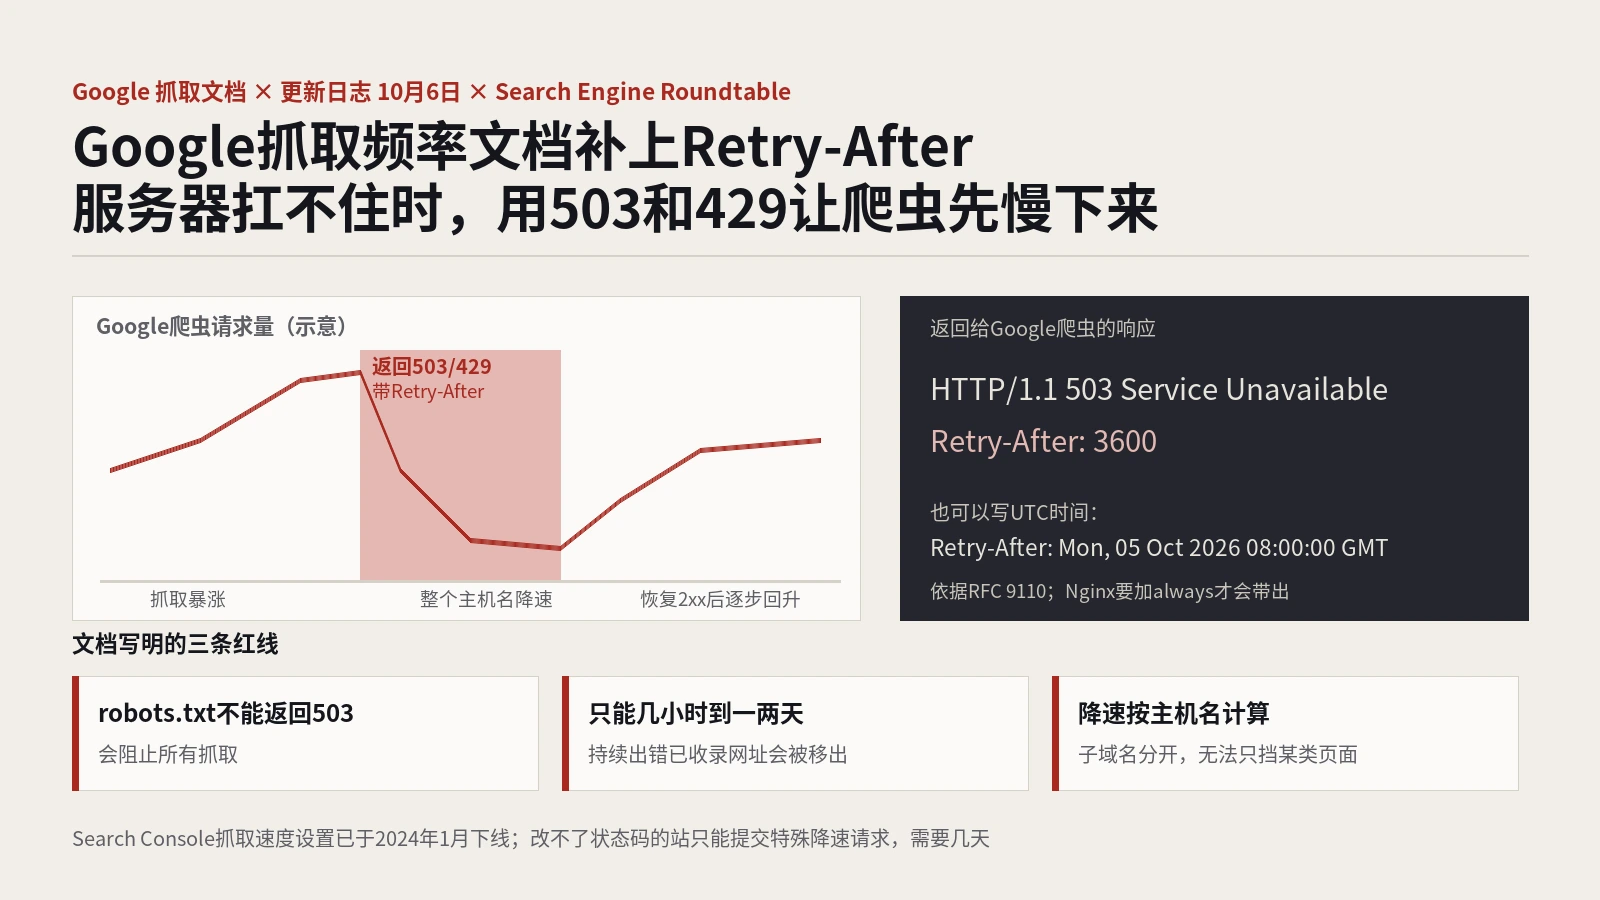
做法:以Google降低抓取频率文档和10月6日更新日志为主体,对照暂停网站、HTTP状态码两份文档和Search Engine Roundtable的改版对比,整理降速机制、Retry-After写法、robots.txt等红线和Nginx与Apache配置。
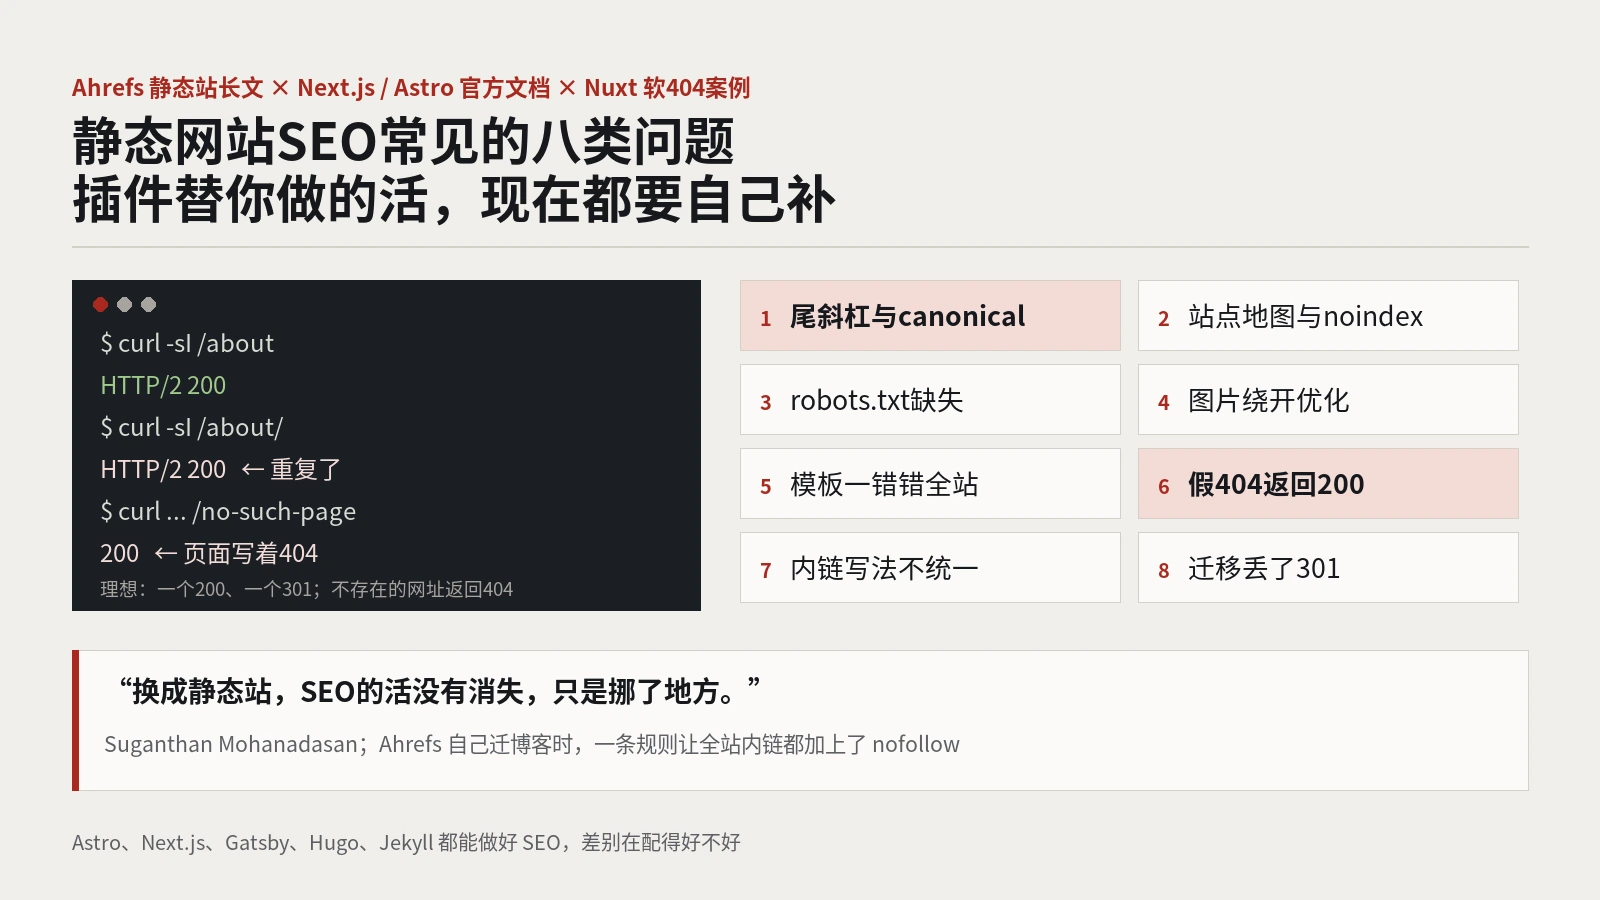
做法:以Ahrefs 10月1日的静态站SEO文章为主体,对照Next.js与Astro的trailingSlash官方文档和Josh Deltener的Nuxt软404案例,整理尾斜杠、站点地图与noindex、图片、模板、状态码、内链、性能和迁移八类问题的成因、修法与自查命令。
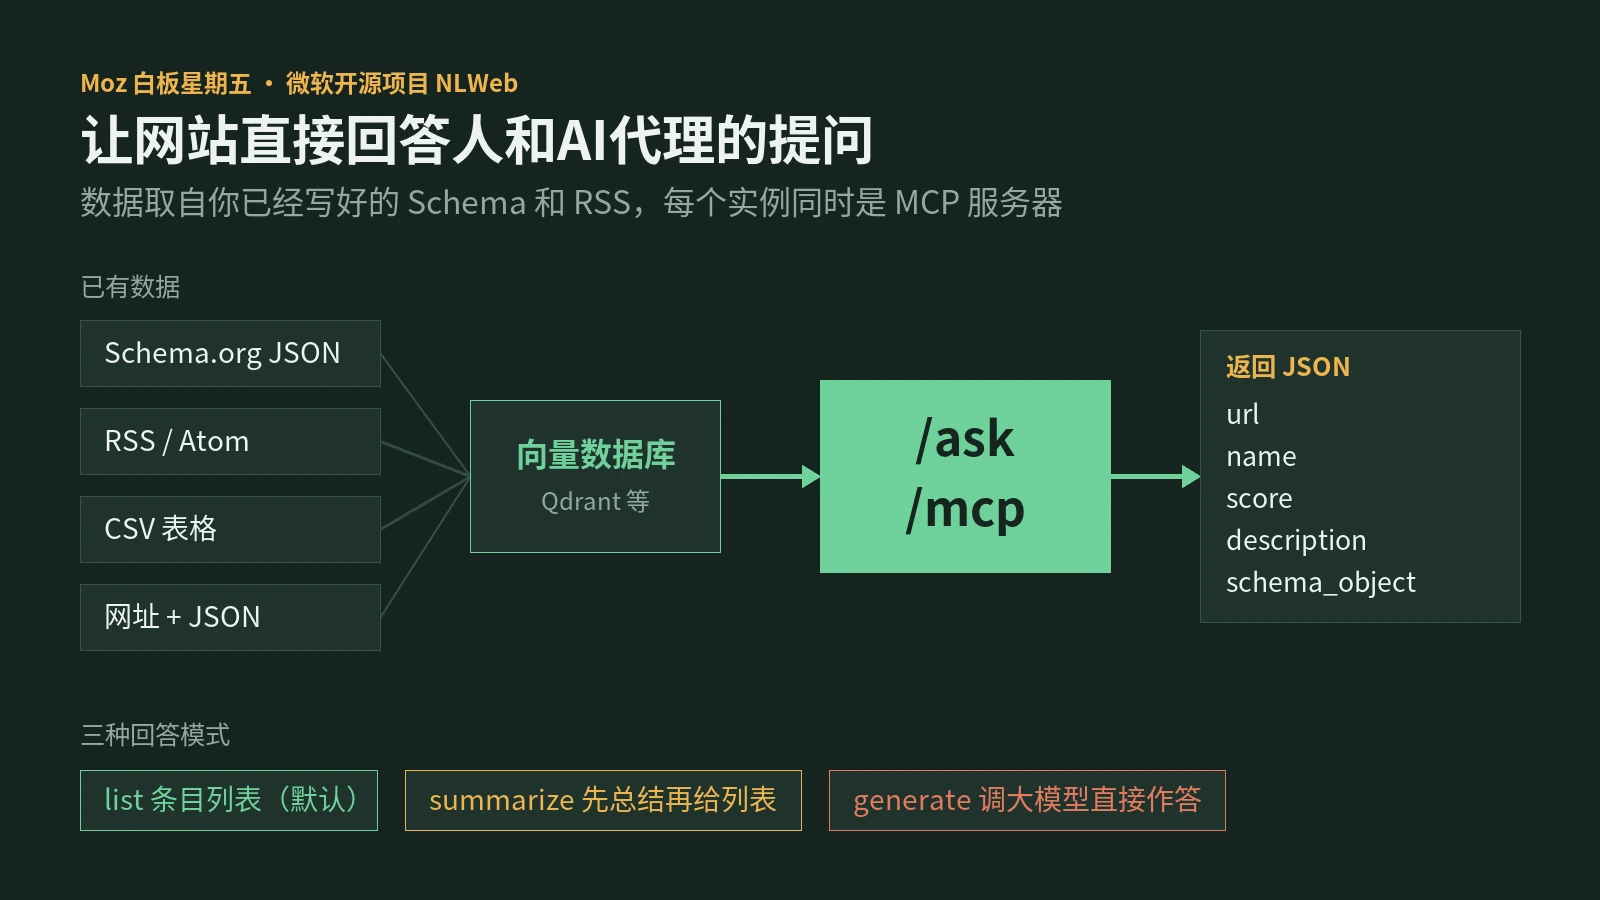
以Moz白板星期五里Crystal Carter对NLWeb的讲解为主体,对照微软发布公告和GitHub文档,讲清楚NLWeb的来历、ask与mcp接口参数、三种回答模式、官方实现支持的数据格式、自部署与Wix集成的接入方式,以及它对SEO和外贸网站的实际价值。
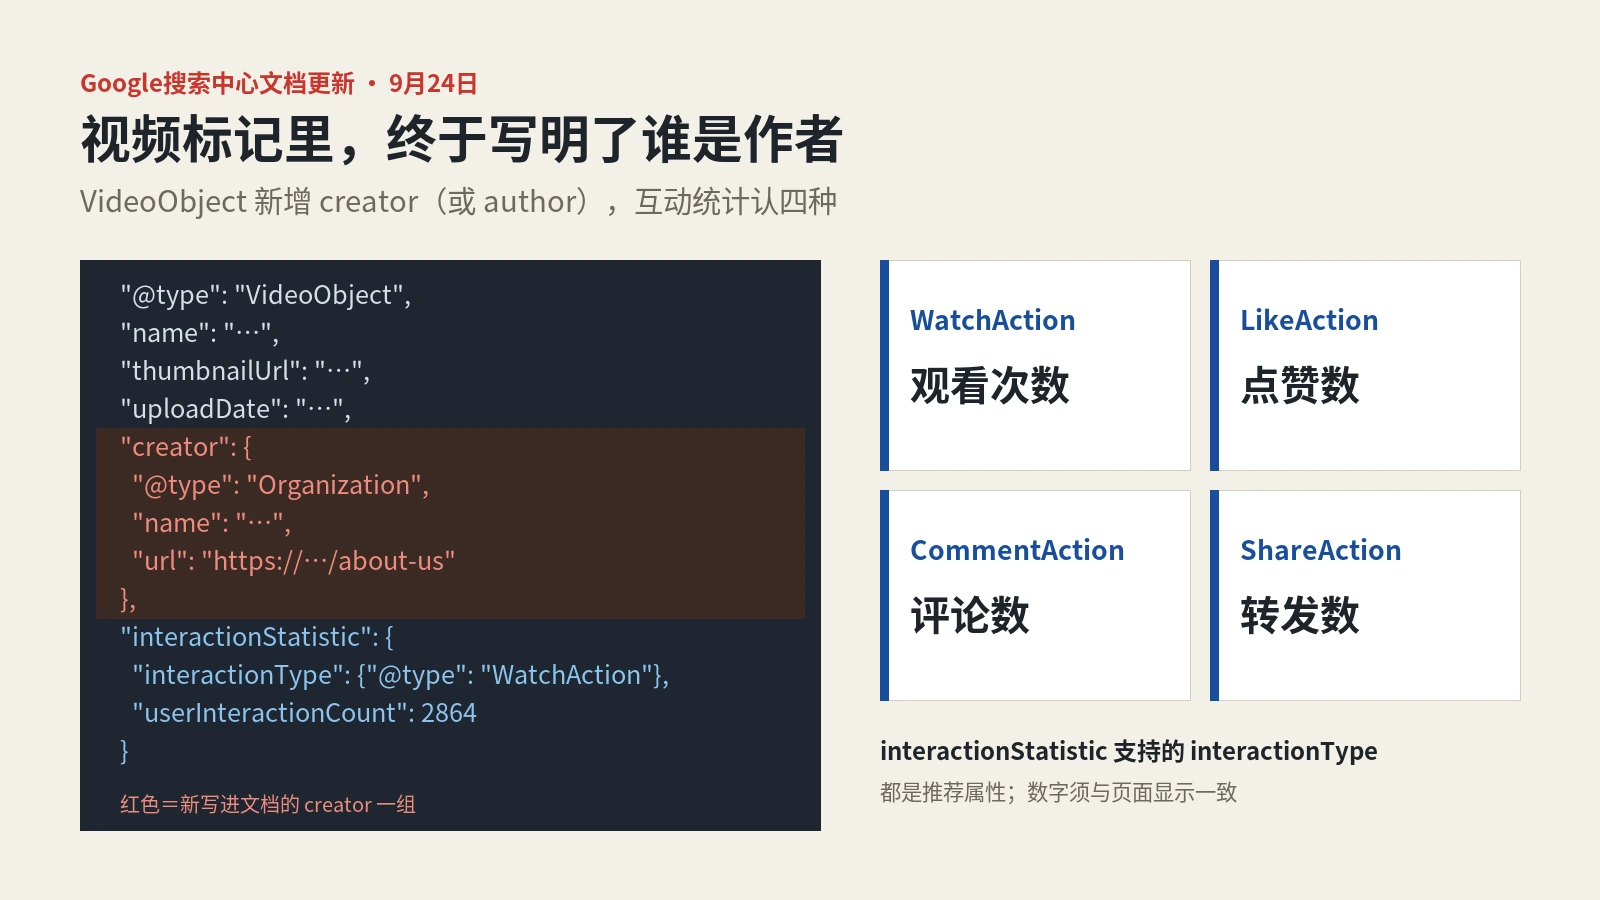
以SER 9月24日报道为主体,对照Google视频结构化数据文档与更新日志,讲清楚VideoObject新增的creator与author属性怎么写、url该指向哪里,interactionStatistic支持的观看点赞评论转发四种类型,附完整JSON-LD示例、关键时刻要求与互动数据的常见坑。
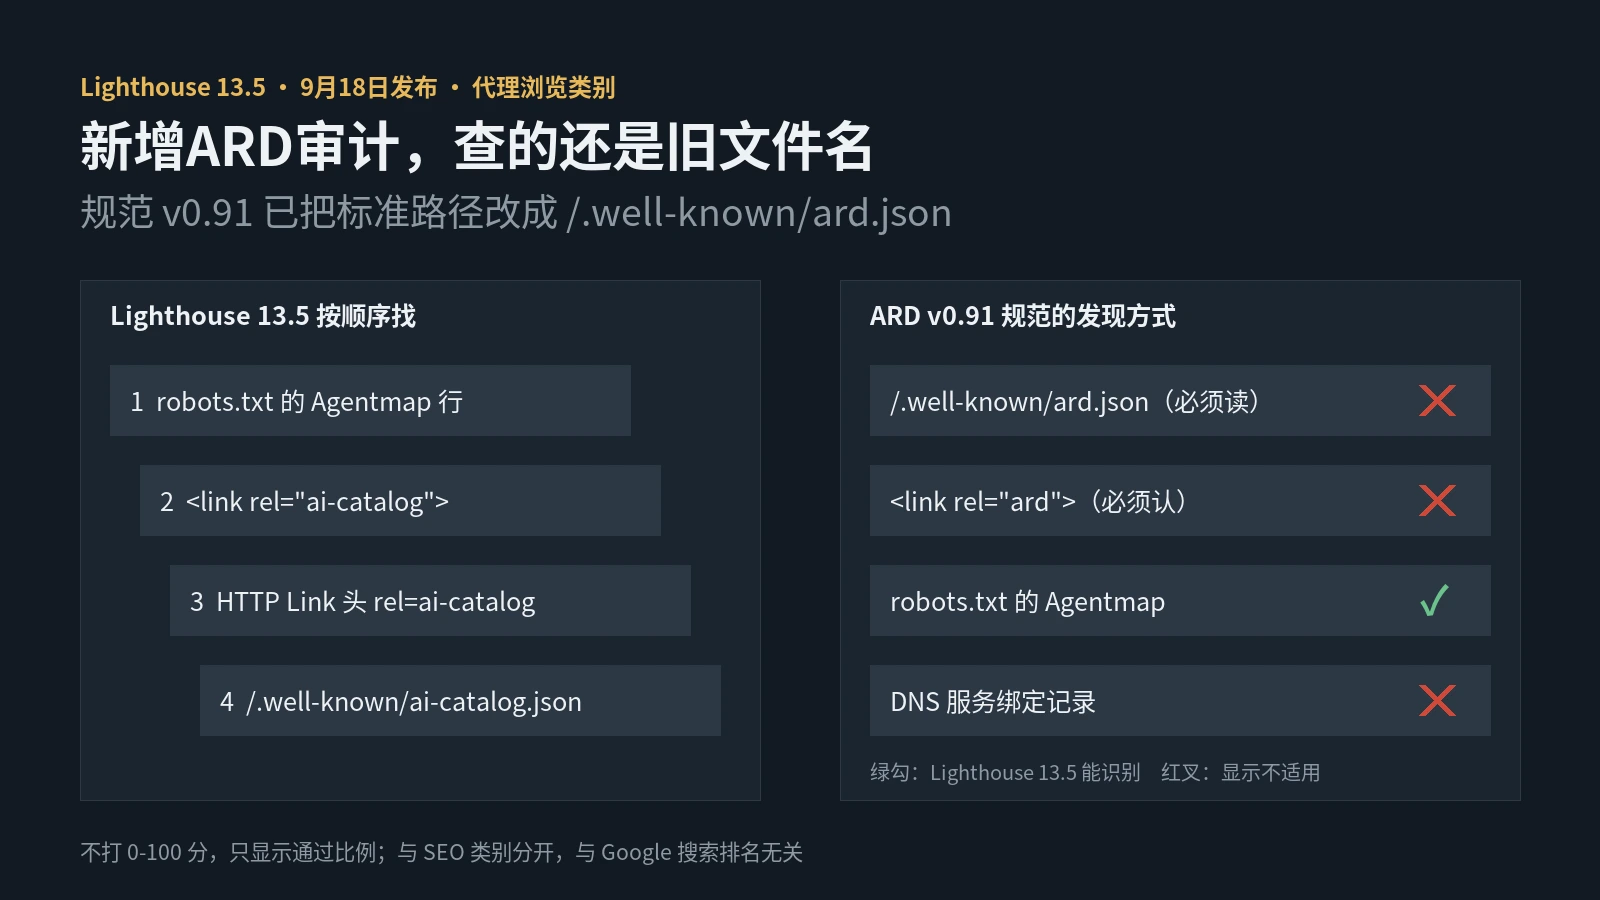
以SEJ 9月21日报道为主体,对照Lighthouse 13.5发布说明、源码和ARD v0.91规范,讲清楚代理资源发现是什么、和llms.txt与WebMCP的区别、Lighthouse按什么顺序找目录文件、怎么判分,以及规范改名为ard.json后按新规范发布的网站为何显示不适用。
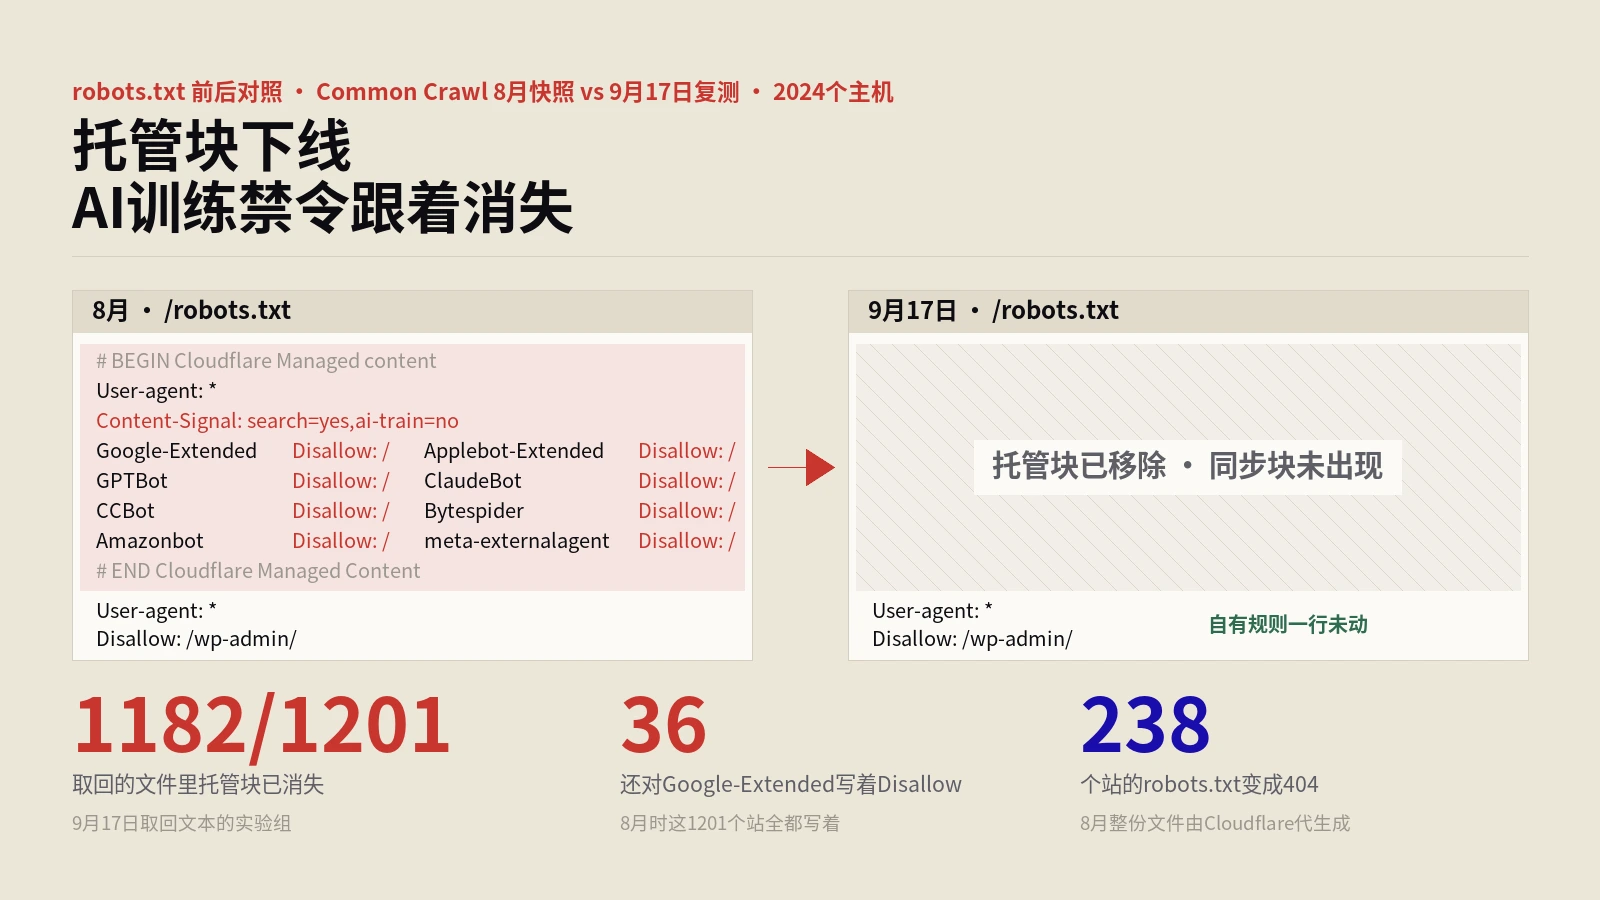
做法:从Common Crawl8月快照的10万份robots.txt里筛出带Cloudflare托管块的2024个主机,再随机抽同样数量的无标记主机作对照,9月17日逐个复测,去掉托管块后比对剩余规则,并用5种访问身份排除缓存与分流干扰。
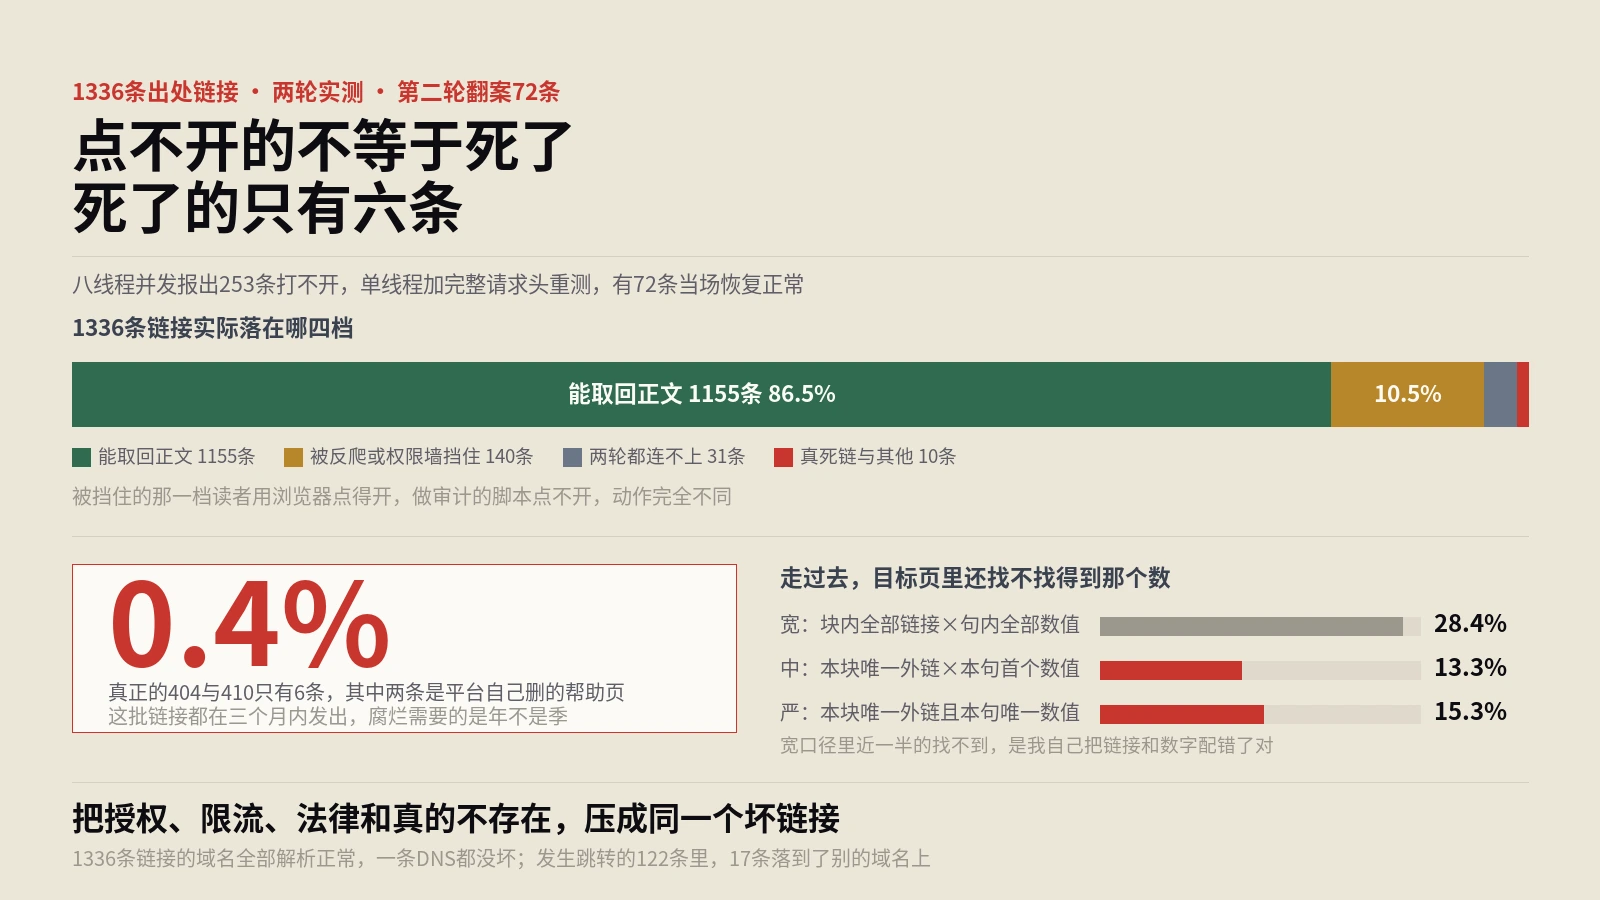
跑法分两轮:先用8线程并发把1336条去重出处链接过一遍,再对所有非200的目标换成单线程、完整浏览器请求头、45秒超时并重试一次,同时单独做一次域名解析,把真死链、被反爬拦住、本地连不上三种情况拆开;最后打开能取回的目标页,用原样、归一化、只比数字串三层匹配找一遍被引的那个数值。
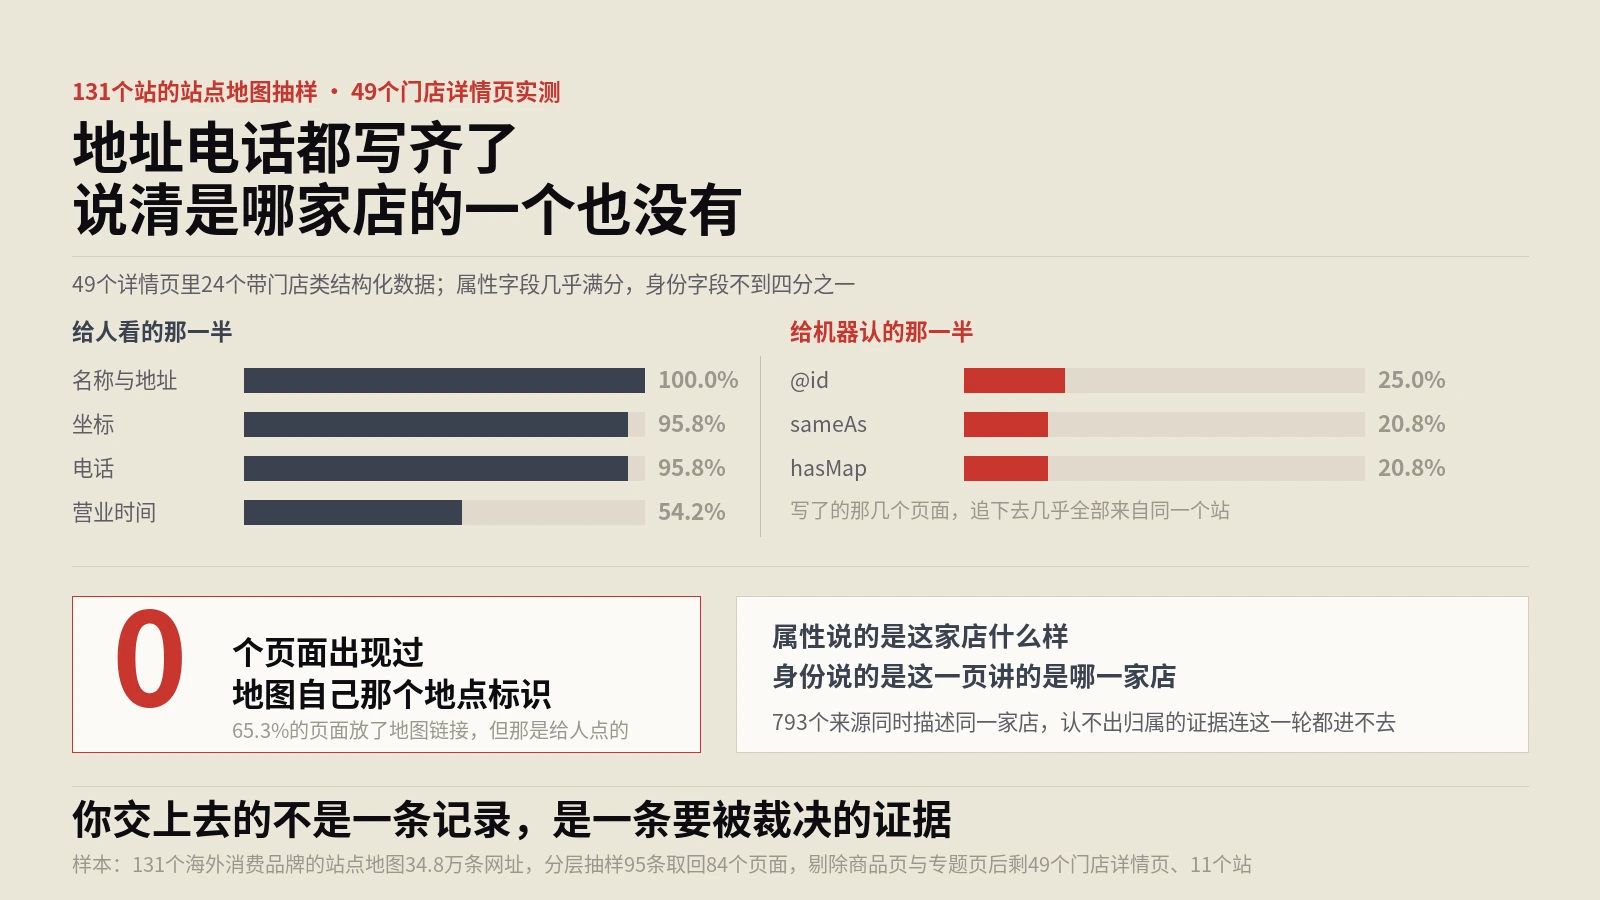
测法写清楚了好复现:从131个站的站点地图里筛门店类网址,分层抽样95条取回84个页面,人工剔掉商品页和专题页,再按门店详情与查找入口分档,最后逐页量结构化数据的属性字段与身份字段。顺带记了一次探测节奏把结论带偏15个百分点的过程。
把抓取引荐比的公式拆成六个必须自己拍板的口径:窗口长度、爬虫标识范围、样本来源、状态码取舍、垃圾来路清洗、网页判定方式。再用本站十五天、258560行nginx日志原样跑一遍,附上改日志格式、清来路、分标识计数、验真假这四步落地顺序。

做法是把131个英文独立站首页与商品页上所有以井号开头的链接取下来,连同解析成绝对地址后只多一个井号的那一类,按HTML规范里滚动到片段的四步逐条判定目标在不在。同时把页面上所有按名字指认别人的属性一起量了一遍——label的for、输入框的form、以及aria那一族。这里踩过一个坑:第一遍把单值属性也按空格拆成了多个名字,算出label有一半指不到,改对分类之后真实数字是另一个量级,两个口径都写在文里。死锚点最后按第三方组件的钩子与…