
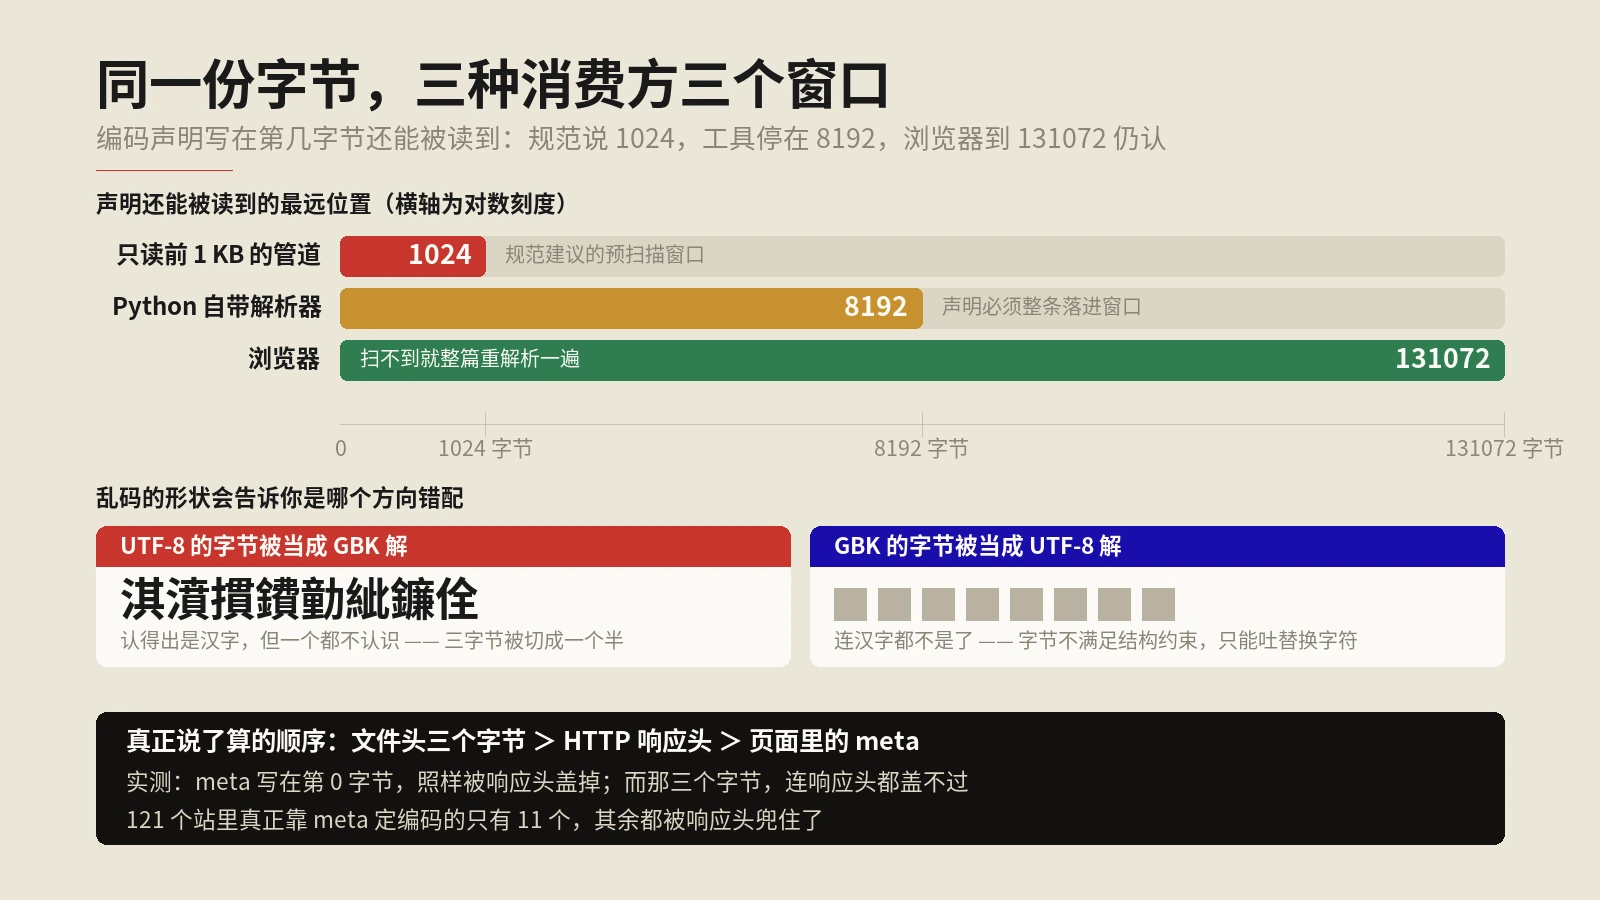
网页乱码的分界不在1024字节,做SEO的脚本比浏览器早八千字节就瞎了
自建三档响应头实验台,把同一批字节分别发成不带声明、声明成一种编码、声明成另一种编码,逐档比对浏览器最终采用了什么。结论是那条链的顺序被大多数教程讲反了:写在文件开头第零个字节的页面内声明,照样被服务器发出的那一行盖掉;而文件头部那三个不可见的字节,连服务器都盖不过。另含两种乱码形态如何反推错配方向、老写法比新写法多占四十六字节窗口预算。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
自建三档响应头实验台,把同一批字节分别发成不带声明、声明成一种编码、声明成另一种编码,逐档比对浏览器最终采用了什么。结论是那条链的顺序被大多数教程讲反了:写在文件开头第零个字节的页面内声明,照样被服务器发出的那一行盖掉;而文件头部那三个不可见的字节,连服务器都盖不过。另含两种乱码形态如何反推错配方向、老写法比新写法多占四十六字节窗口预算。
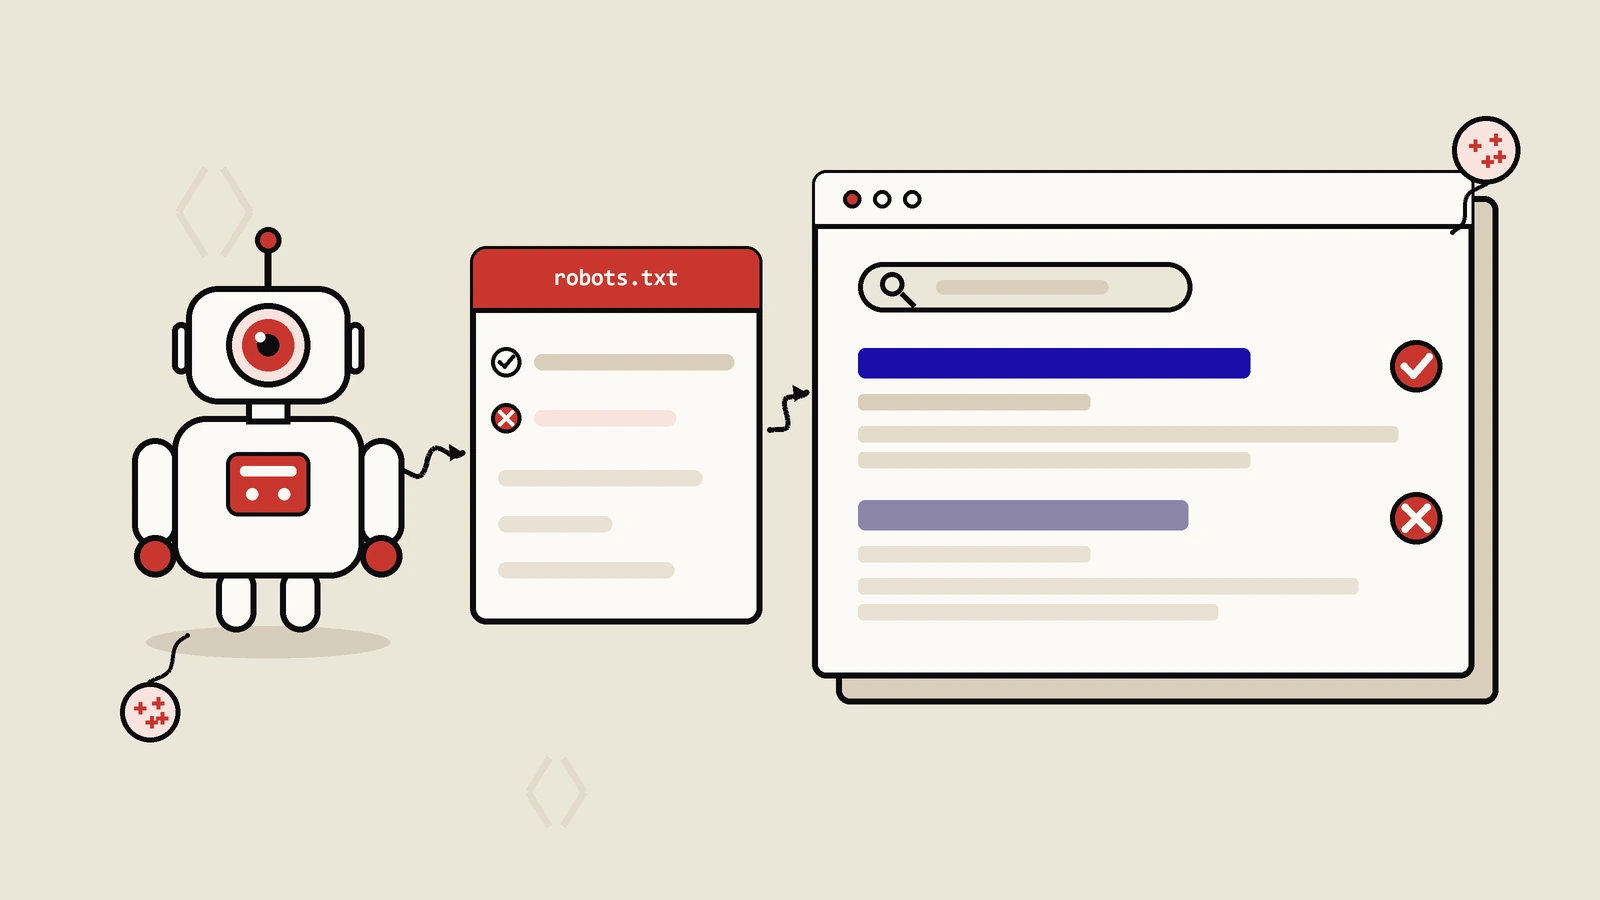
很多出海独立站突然从Google消失,根因不是内容问题而是robots配置——把抓取和索引混为一谈、Disallow拦住想noindex的页面、X-Robots-Tag误覆盖全站。本文给一张三件套边界图、所有指令清单、优先级裁决规则和出海亲子玩具独立站12周修复误封的真实SOP,看完就能直接判断自己这套robots到底改不改、改在哪一档。
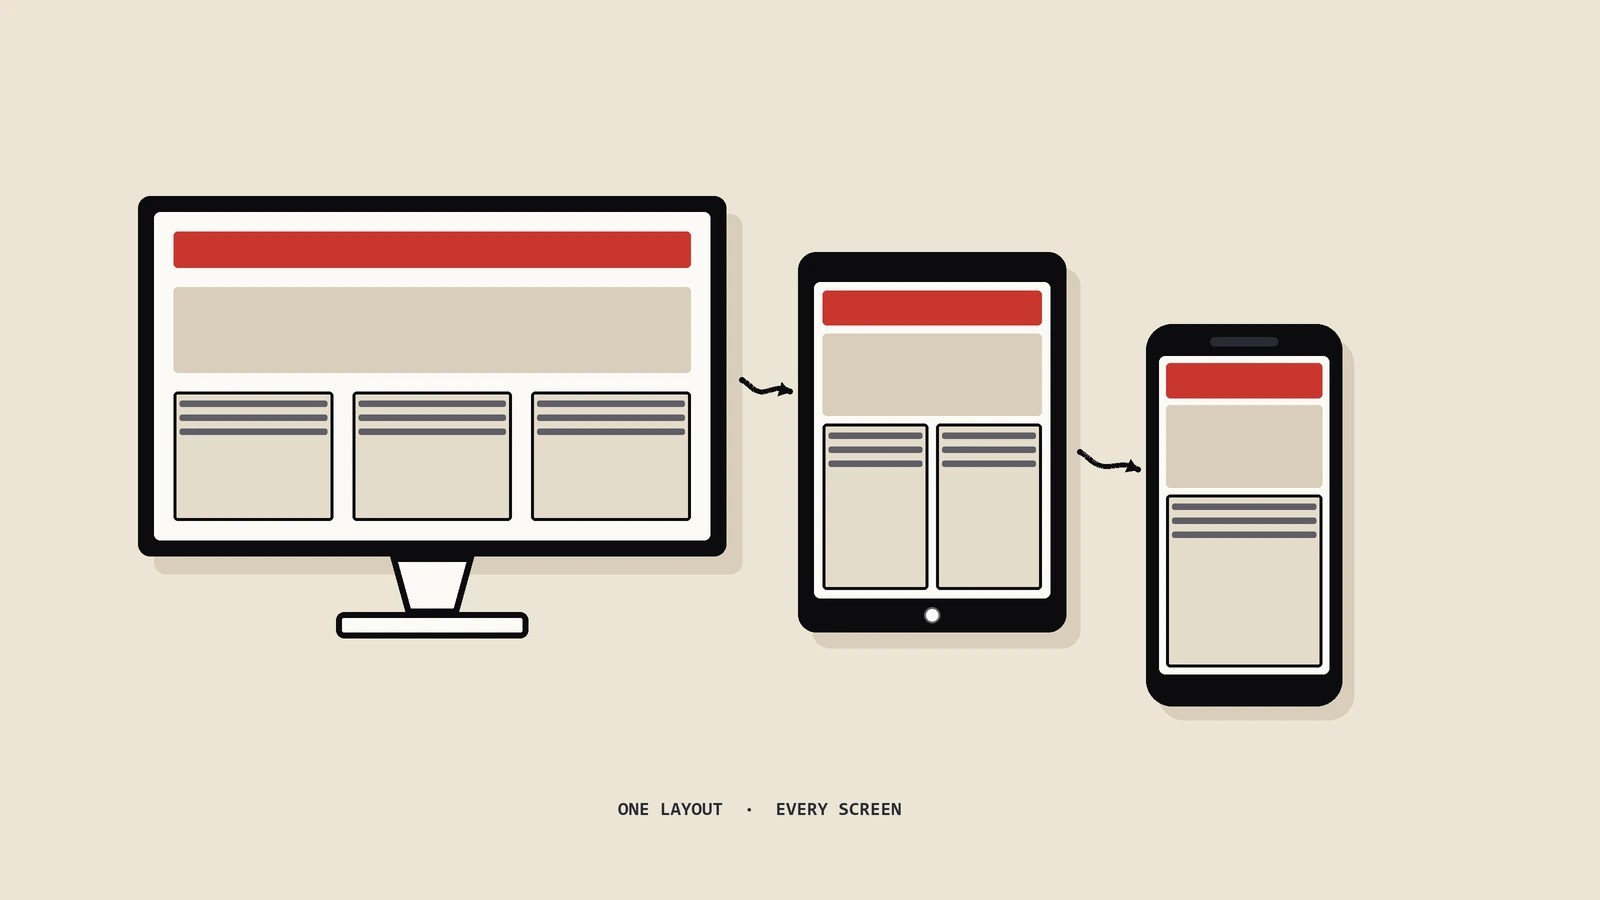
RWD响应式、AWD自适应、动态服务三种架构对Google爬取额度、权重聚合、移动优先索引、Canonical稳定性的影响完全不同,本文给出选型矩阵、五大落地坑、五步迁移SOP和真实车载用品独立站切换案例,看完就知道自己这套网站到底该不该改、改到哪一档。
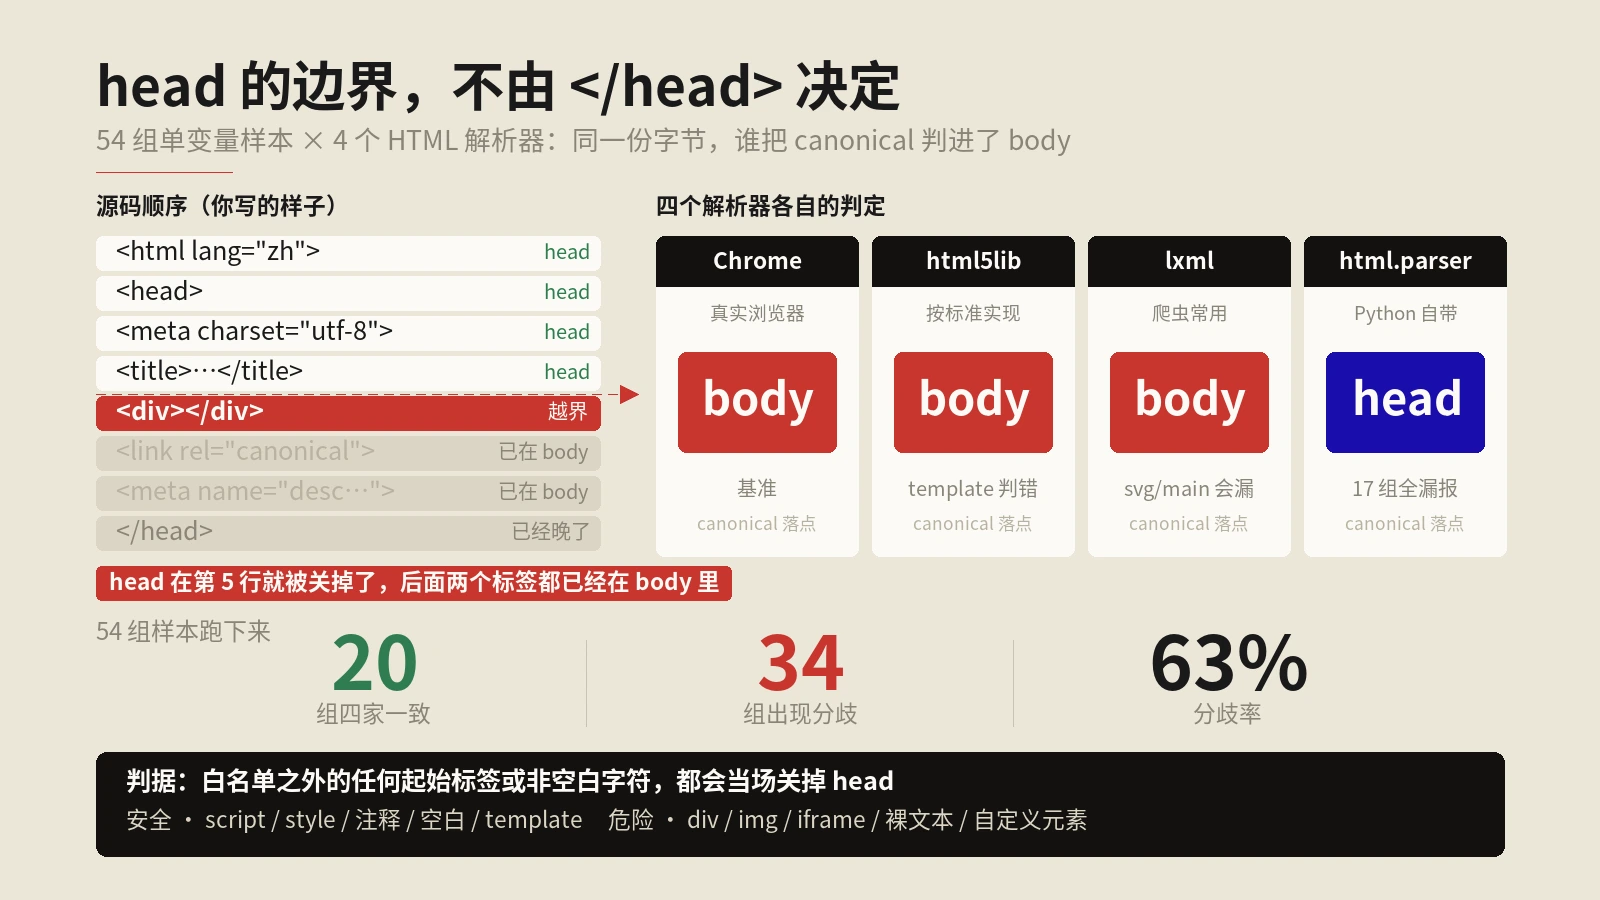
拿只改一个变量的样本把边界逐条压出来:白名单里的元素一个都不会关掉容器,名单外的元素无一例外全部关掉,中间没有灰带。真正难查的是让标签整个消失的那三组——未闭合的脚本与样式会把后面的内容一路吞到文件末尾,属性引号漏掉一个则只吞掉紧跟着的那一个。另含重复闭合标签反而无害、自闭合写法与孤立结束标签结果相反、嵌套注释在第一个结束符就收工这几条容易看走眼的判定。
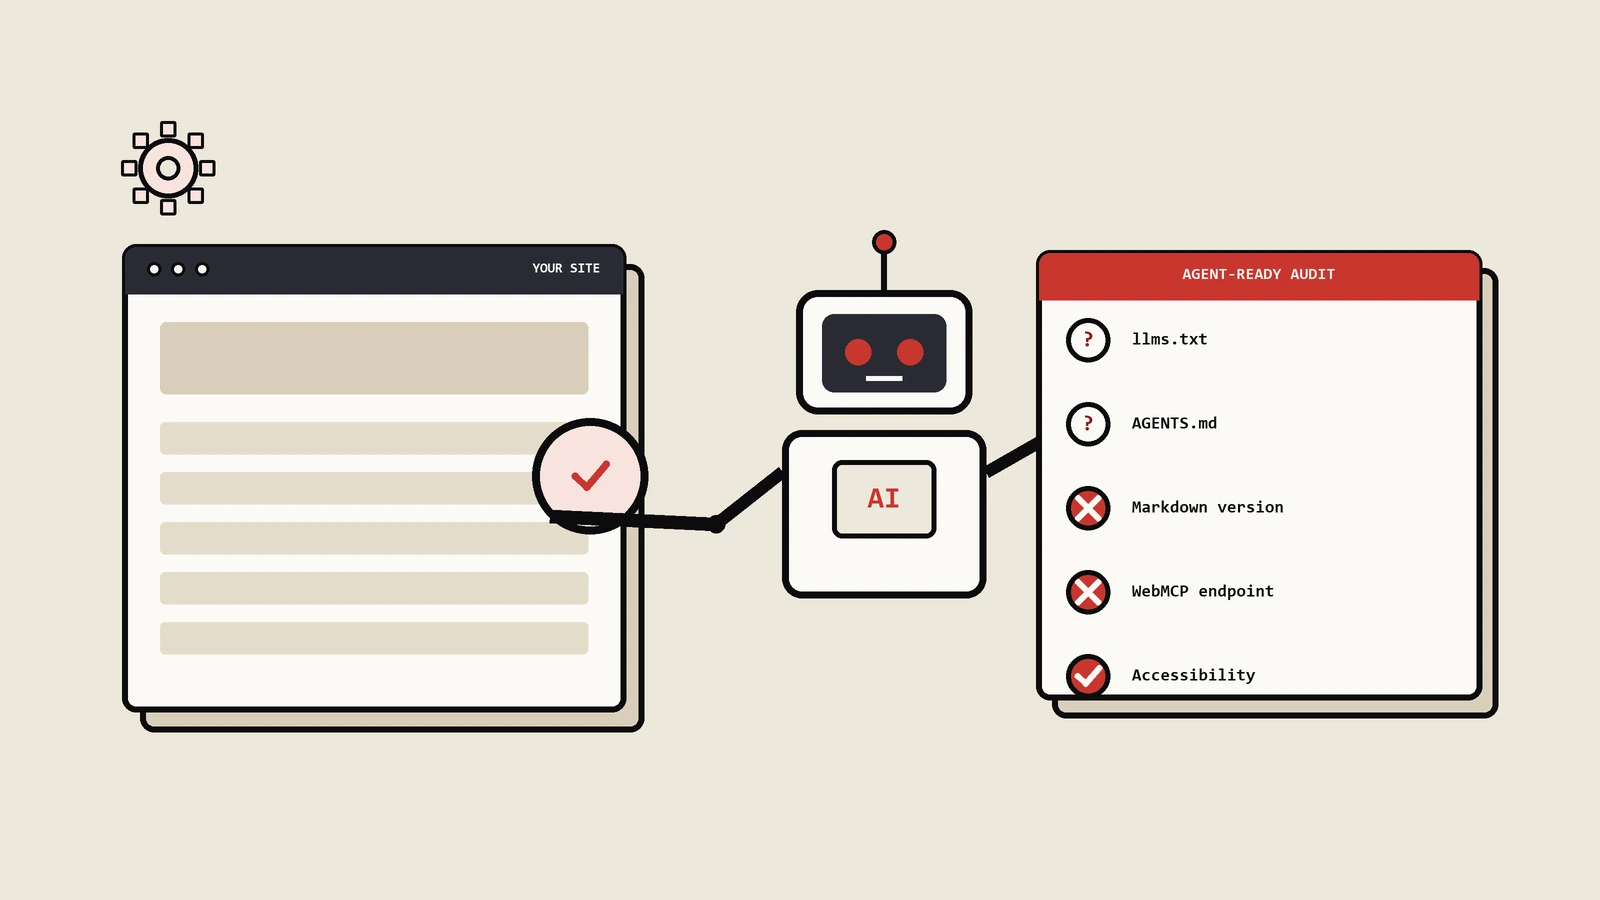
Google搜索说不用做llms.txt、不用为机器人单独写Markdown,可Chrome的Lighthouse又新增了Agentic Browsing审计来查这些。本文拆解口径分歧背后discovery与functionality的分工,讲清Markdown、llms.txt、WebMCP到底值不值得做,并给出一张按网站类型分级的agent友好度优先级落地表。
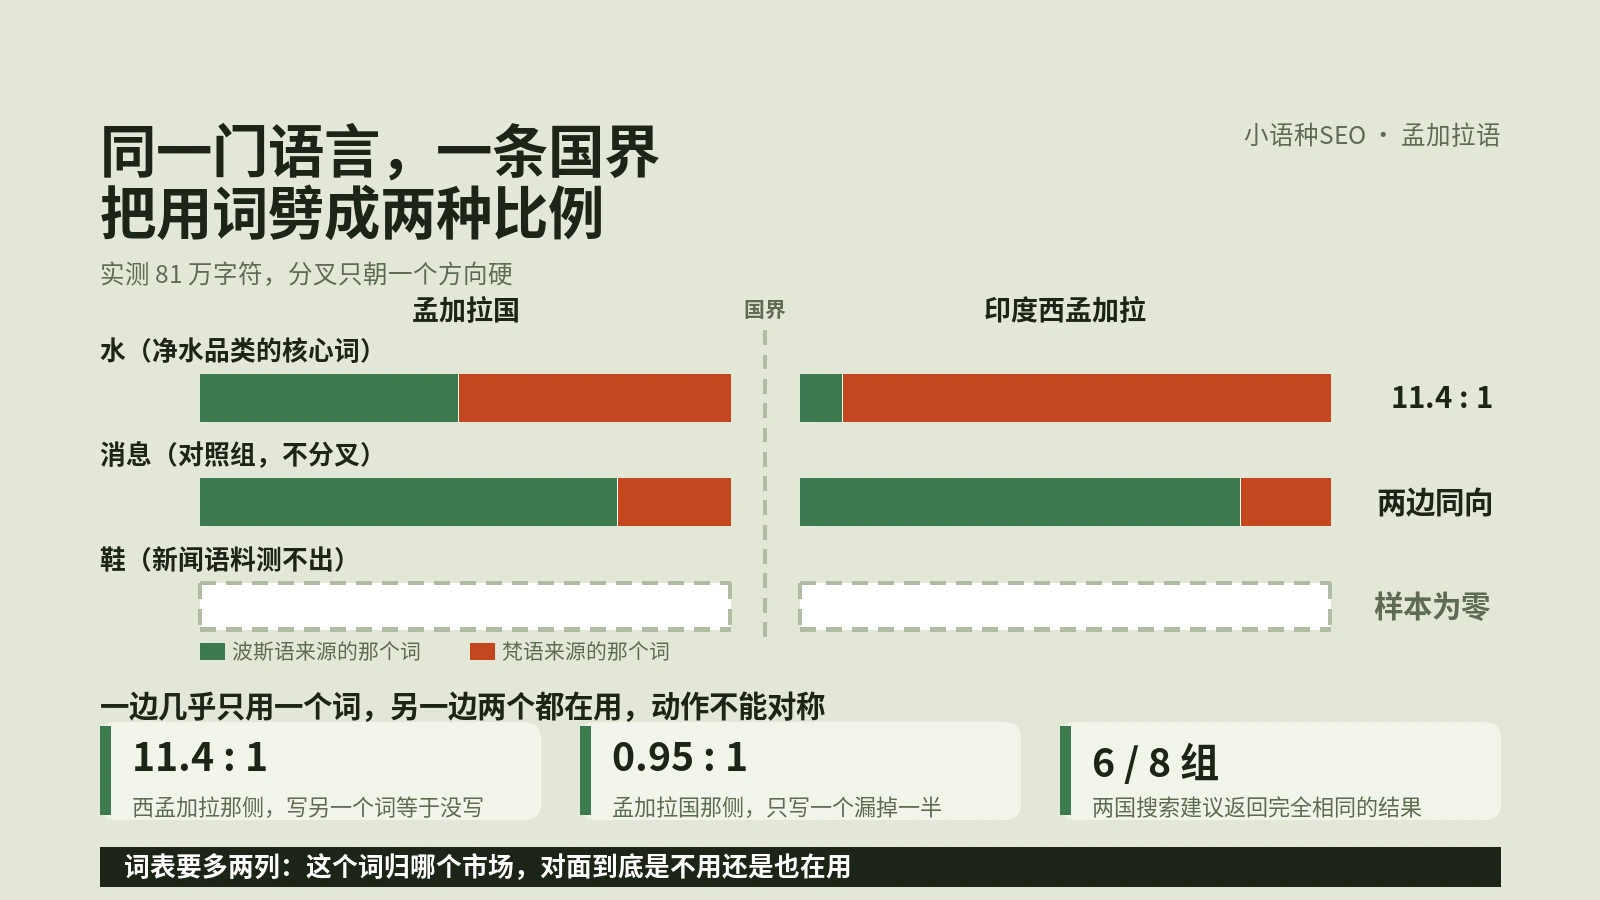
净水设备站的孟加拉国流量半年不动,译文却挑不出毛病。这里给出国界两侧81万字符的词频实测、同义词在商业查询里为什么只剩一个词形、字段额度按哪把尺子算,以及一套不懂这门语言也能跑完的自检。
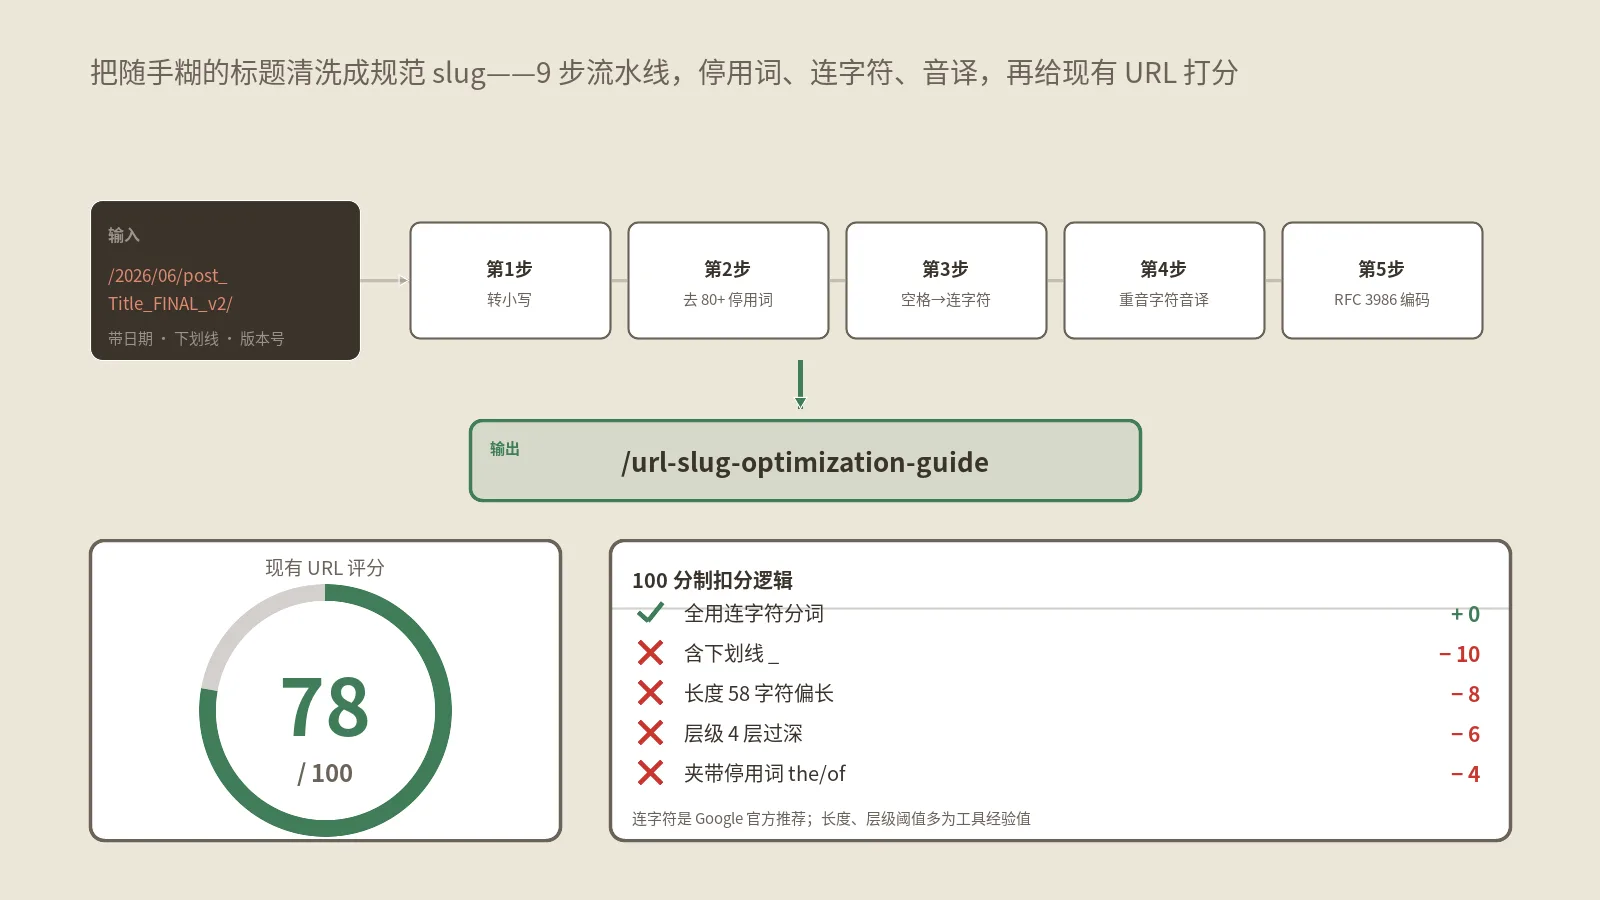
URL用连字符还是下划线、长度卡多少、中文怎么转slug?本文拆开一个URL slug优化器的9步清洗流水线、80多个停用词取舍、音译表与100分制评分,讲清哪些是Google铁律、哪些是工具经验值,最后回答上线URL到底该不该为优化去改。
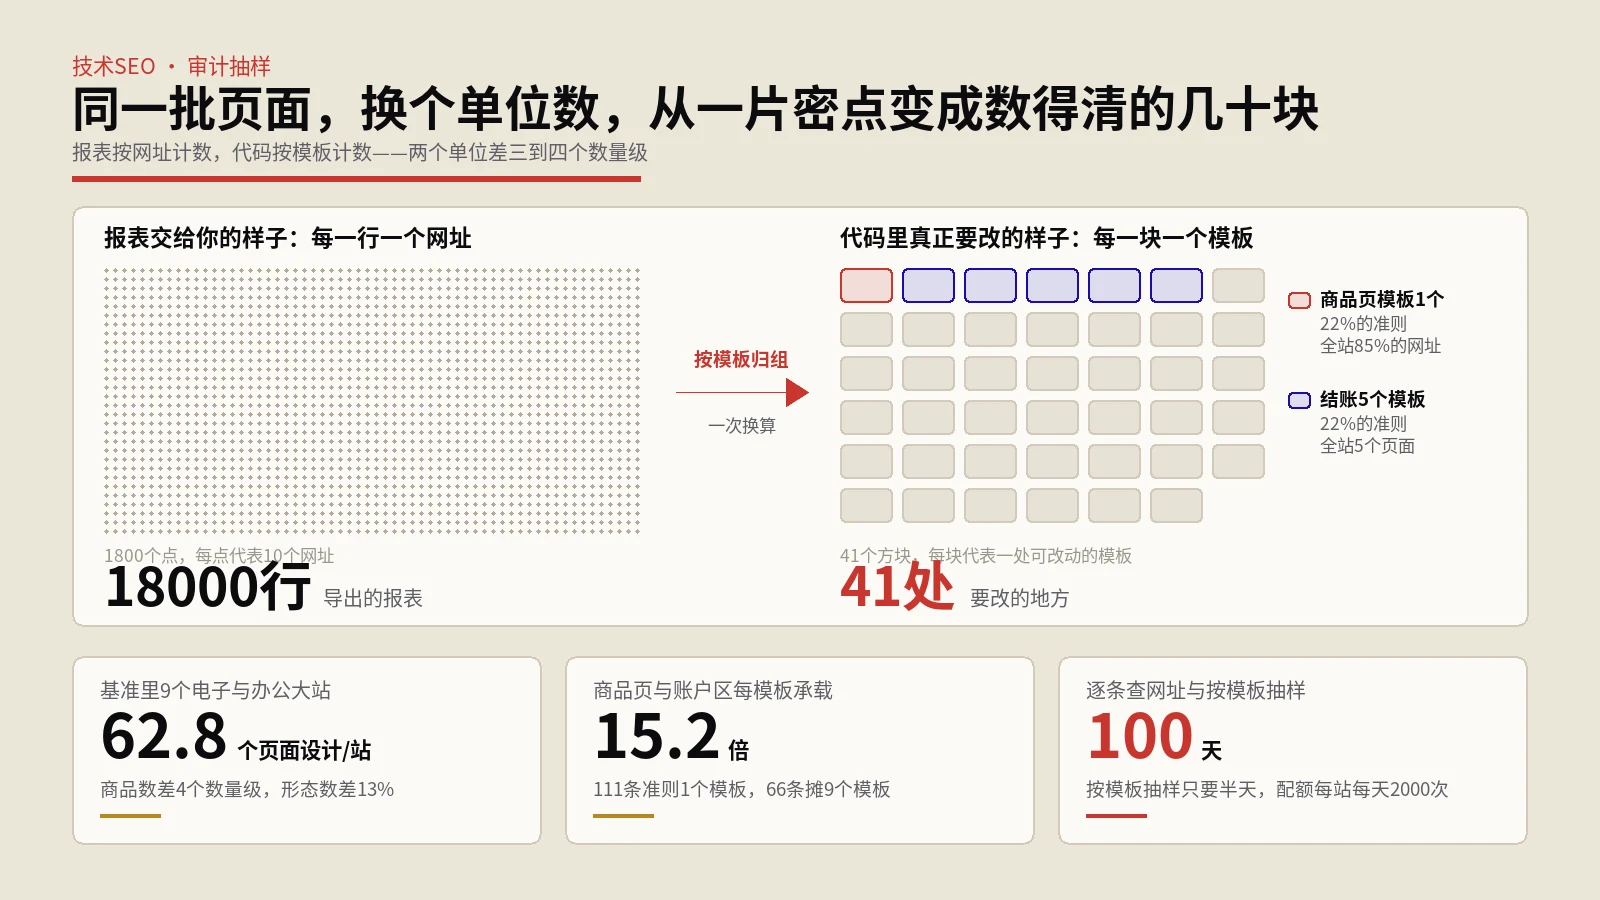
文章把一份几万行的审计报表按页面模板重新归了一次组,涵盖Baymard电子与办公基准里9个大站565个页面设计的拆解、500条准则在8个主题上的分布与每模板承载量、Search Console两份报告为什么一份数网址一份数网址组、现场数据只有整站与单页两级的门槛推算、国际评估方法学对模板抽样的规定,以及网址检查接口配额下逐条扫描要跑100天的算术。
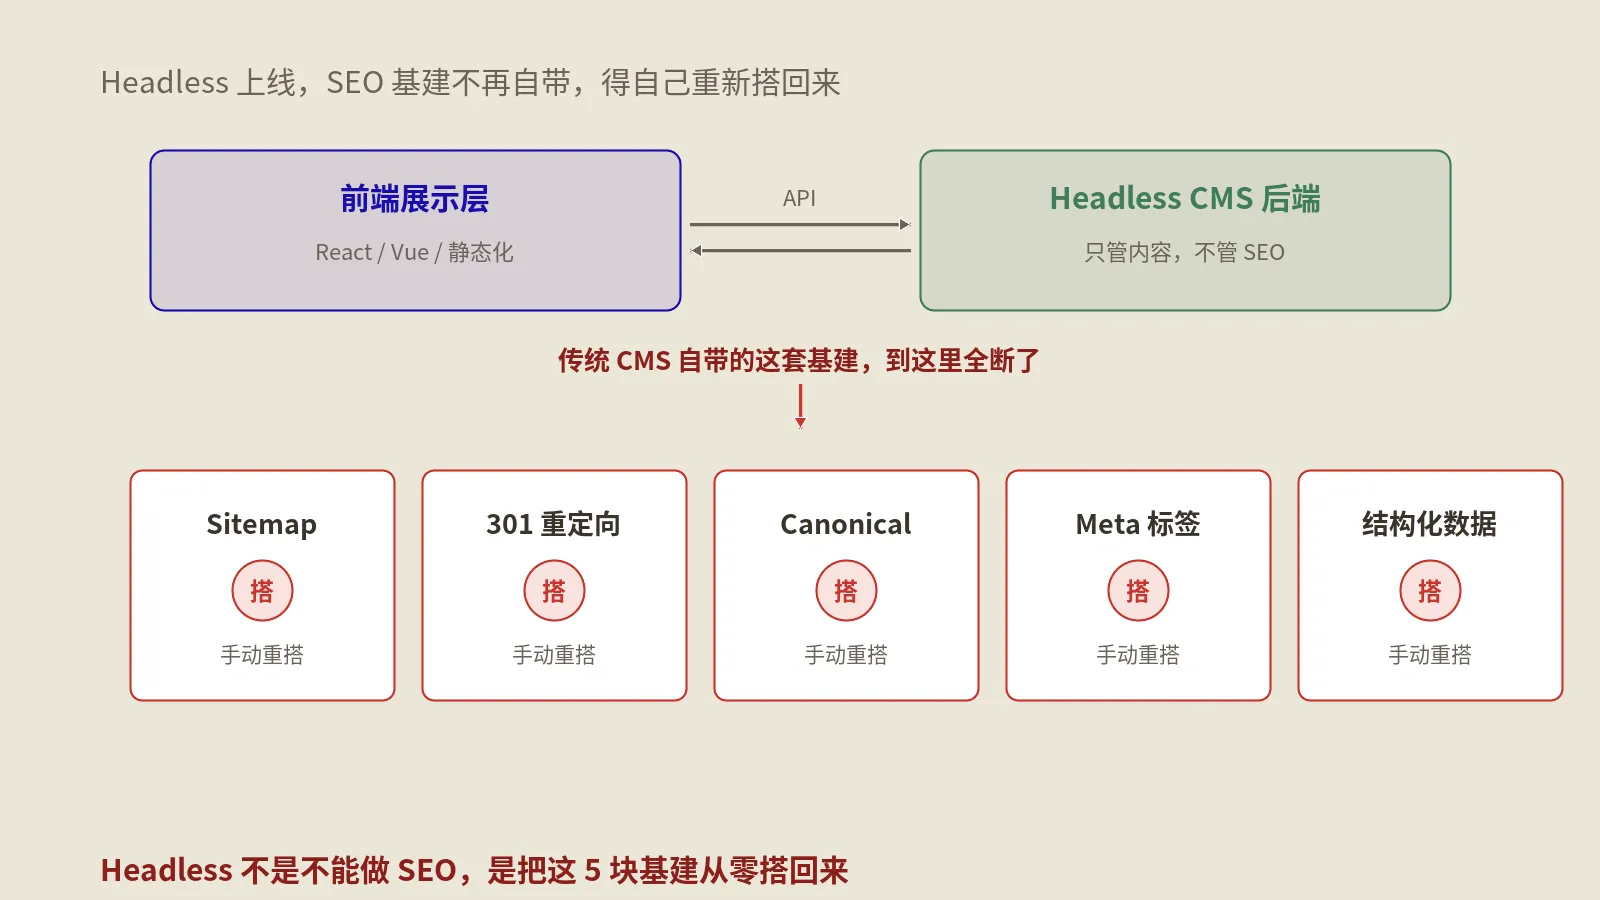
很多团队从WordPress迁到Headless CMS,前端性能、内容建模都做得漂亮,结果上线后自然流量不升反降。保哥见过太多这种案例,根子几乎都一样:传统CMS里Yoast插件默默帮你做的那套SEO基础设施——sitemap自动生成、meta标签输出、canonical标记、历史重定向管理、结构化数据注入——在Headless解耦那一刻全消失了,却没人意识到要重建。这篇把这套被遗忘的SEO基建逐项拆开:它原本由谁负责、在Headle…
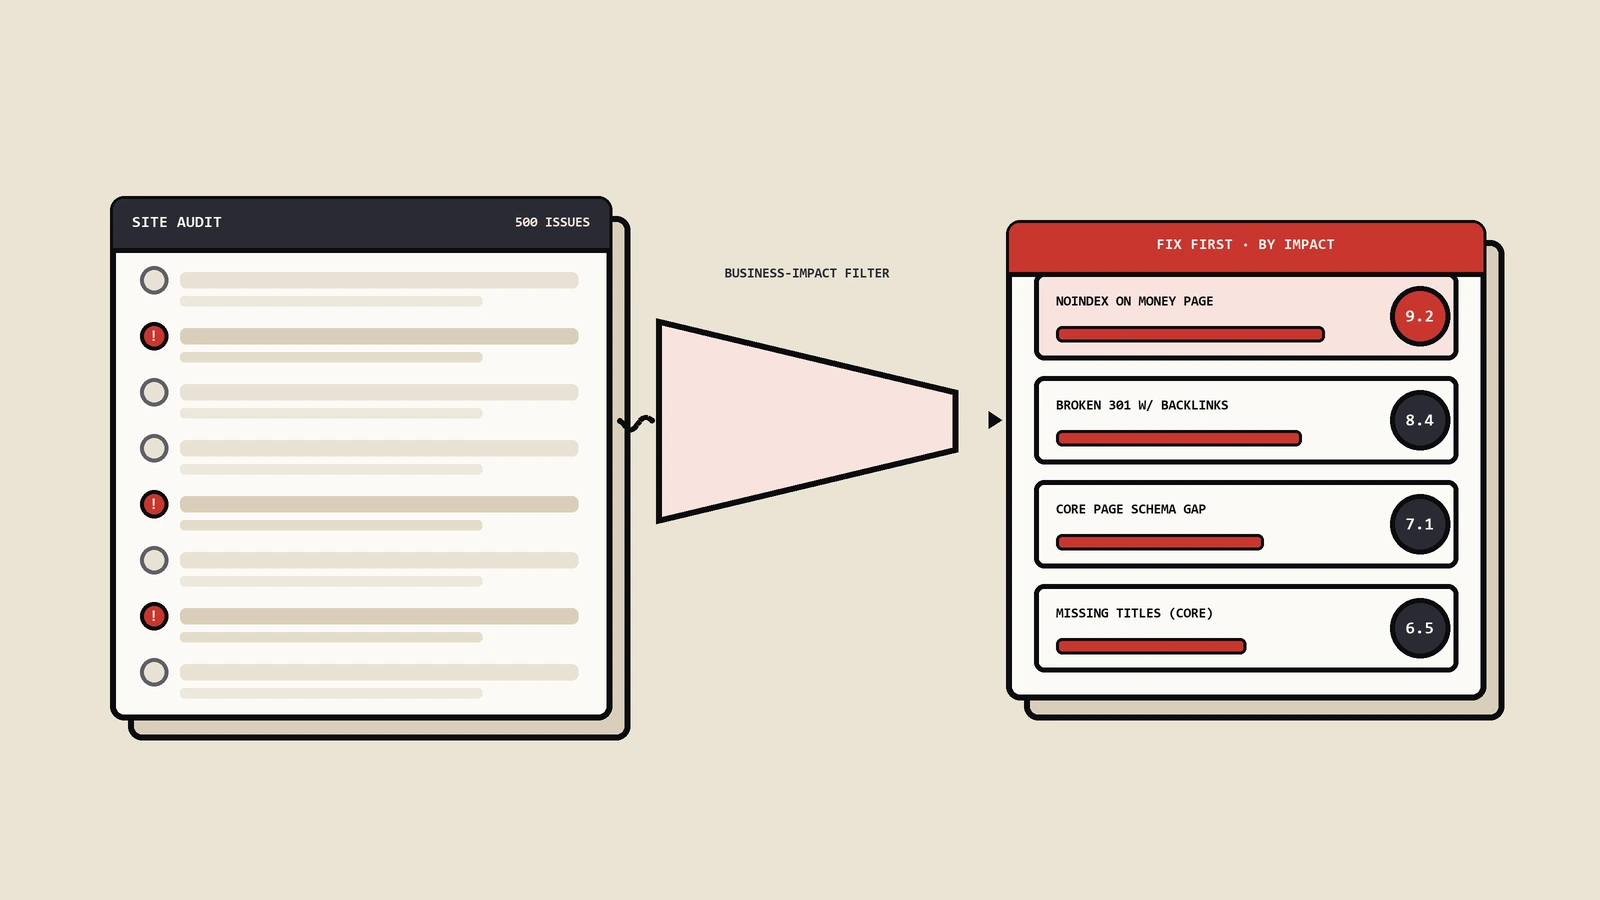
Site Audit跑出来500个问题不代表要修500个——技术SEO修复必须按业务影响排序,而不是按工具的问题计数。本文拆解ICE、RICE、PIF三套打分模型的实操差异,给出7类常见技术问题的真实ICE评分对照表,再补5个Quick Wins可复制模板和4个向老板汇报的真业务指标。
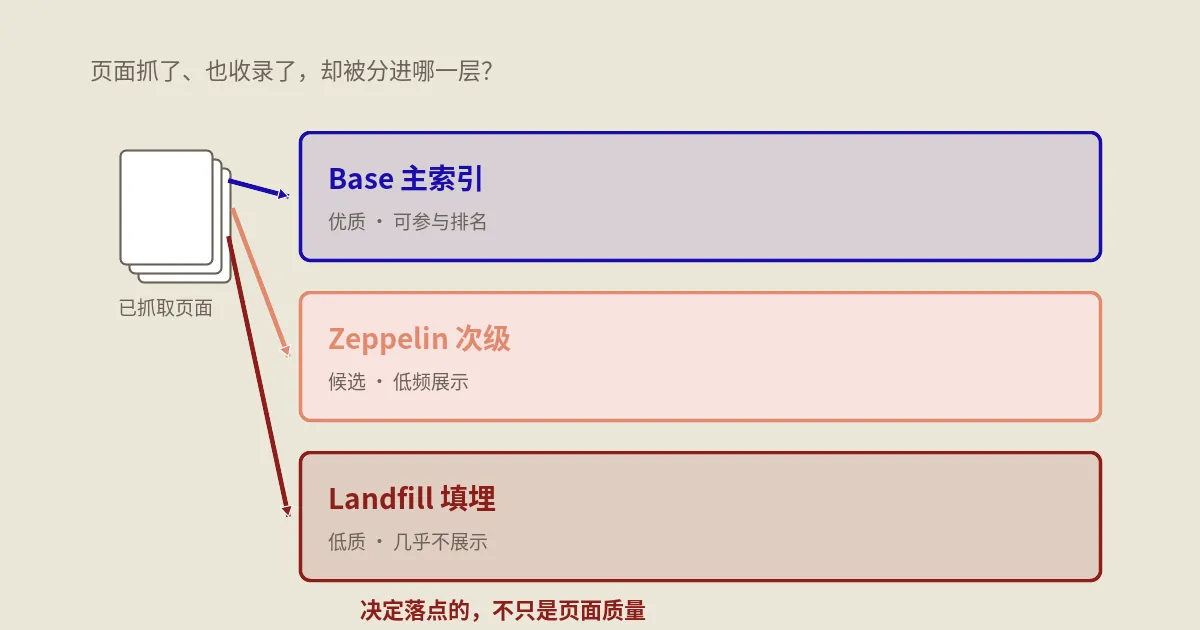
谷歌的索引分Base、Zeppelin、Landfill三层,2004年分区专利与2024年API泄露双重坐实。页面被收录不等于进了能排名的那一层;决定层级的是站点级static rank而非单页质量。这篇拆解三层机制、HCU为何是站点级降层、怎么自查所在层级,以及掉进低层后的翻盘策略。
技术体检接近满分却还是不涨?这篇讲清地基与天花板的分工、意图错配怎么触发技术救不回的恶性循环、六个信号怎么替Google判断你对没对齐、怎么用结果页反推并系统修一次错配,以及抓取预算国际站日志这三处技术为什么仍是胜负手。

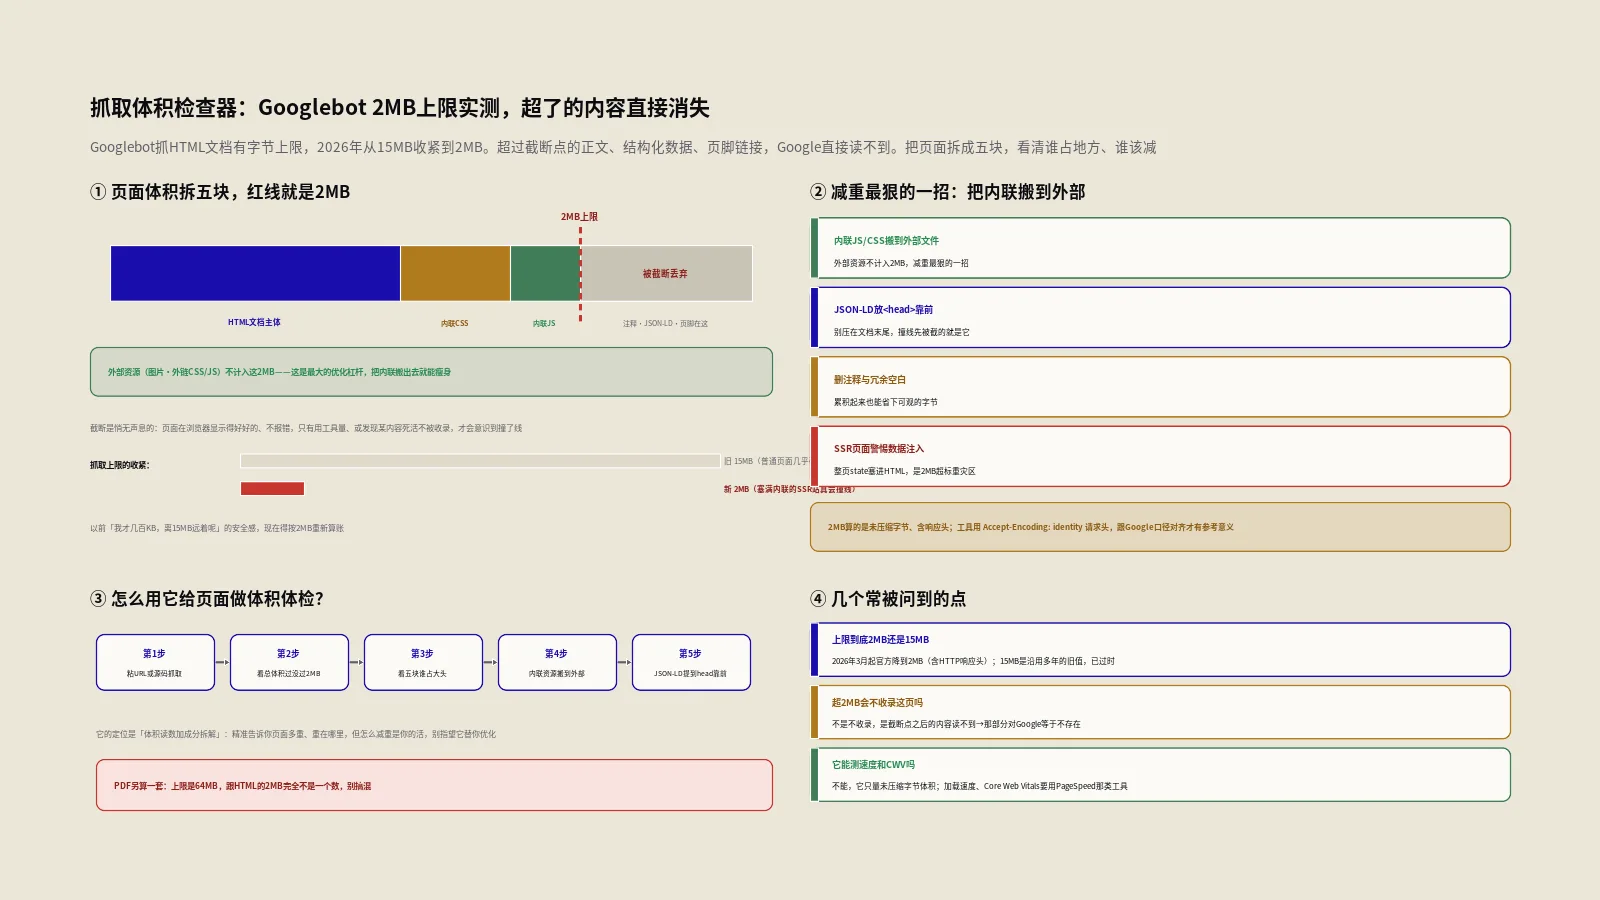
Googlebot抓页面有体积上限,超了后面的内容直接被截断,而这个上限2026年刚从15MB收紧到2MB。本文拆开一个抓取体积检查器测HTML文档体积、拆成五块成分的逻辑,讲清为什么外部资源不计入这2MB(最大减重杠杆)、超标后内容怎么被悄悄吞掉。
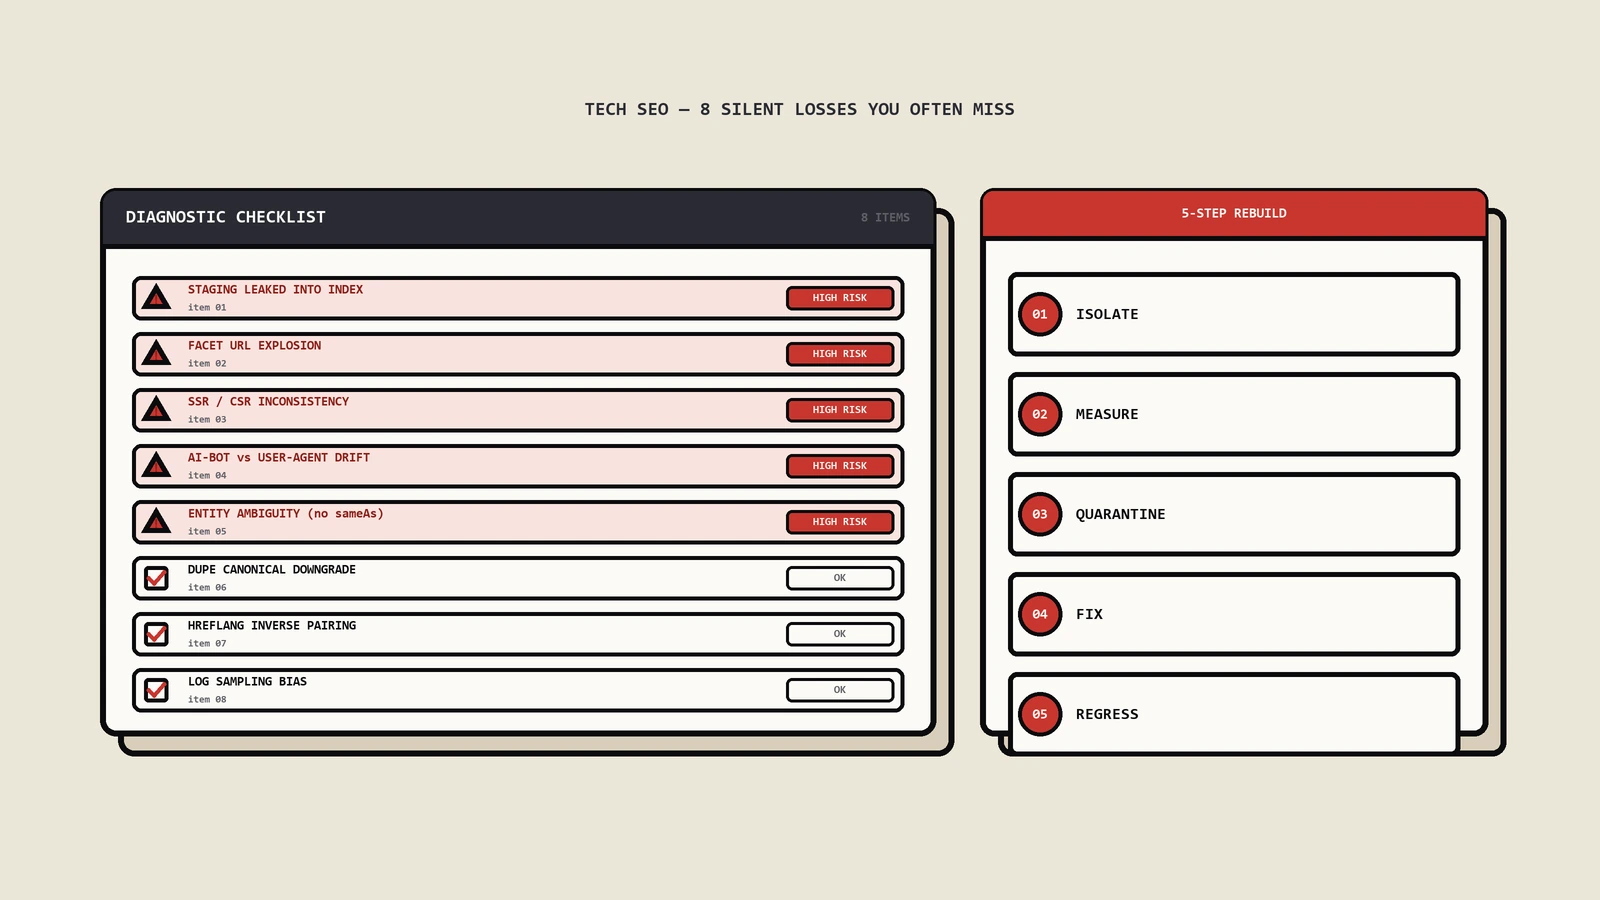
站点越大越容易栽在没人专门去查的结合部:可访问的测试域名喂脏了索引、筛选器URL笛卡尔积吃光抓取预算、批量模板页稀释质量、爬虫拿到的和用户看到的不是同一个页面。本文把这些安静的损耗逐一挖出来,每类配可复现的诊断动作,再给一套改不崩线上站的安全修复纪律。
换个主题、改个版,URL明明没变,自然流量却往下掉——问题多半出在H标签、结构化数据、内链被新主题一起换掉了。保哥这篇讲独立站同域改版怎么保住SEO:信号盘点、CWV防回退、改版前后对照监控。

把企业SEO审计拆成十一根支柱:可访问性、索引、架构、页面体验、内容、搜索意图、E-E-A-T与实体、外链、GEO与AI可见度、竞品到国际化,逐根讲清查什么、用什么判据、怎么按业务影响排优先级、报告怎么交付才落地,附一份可执行清单。

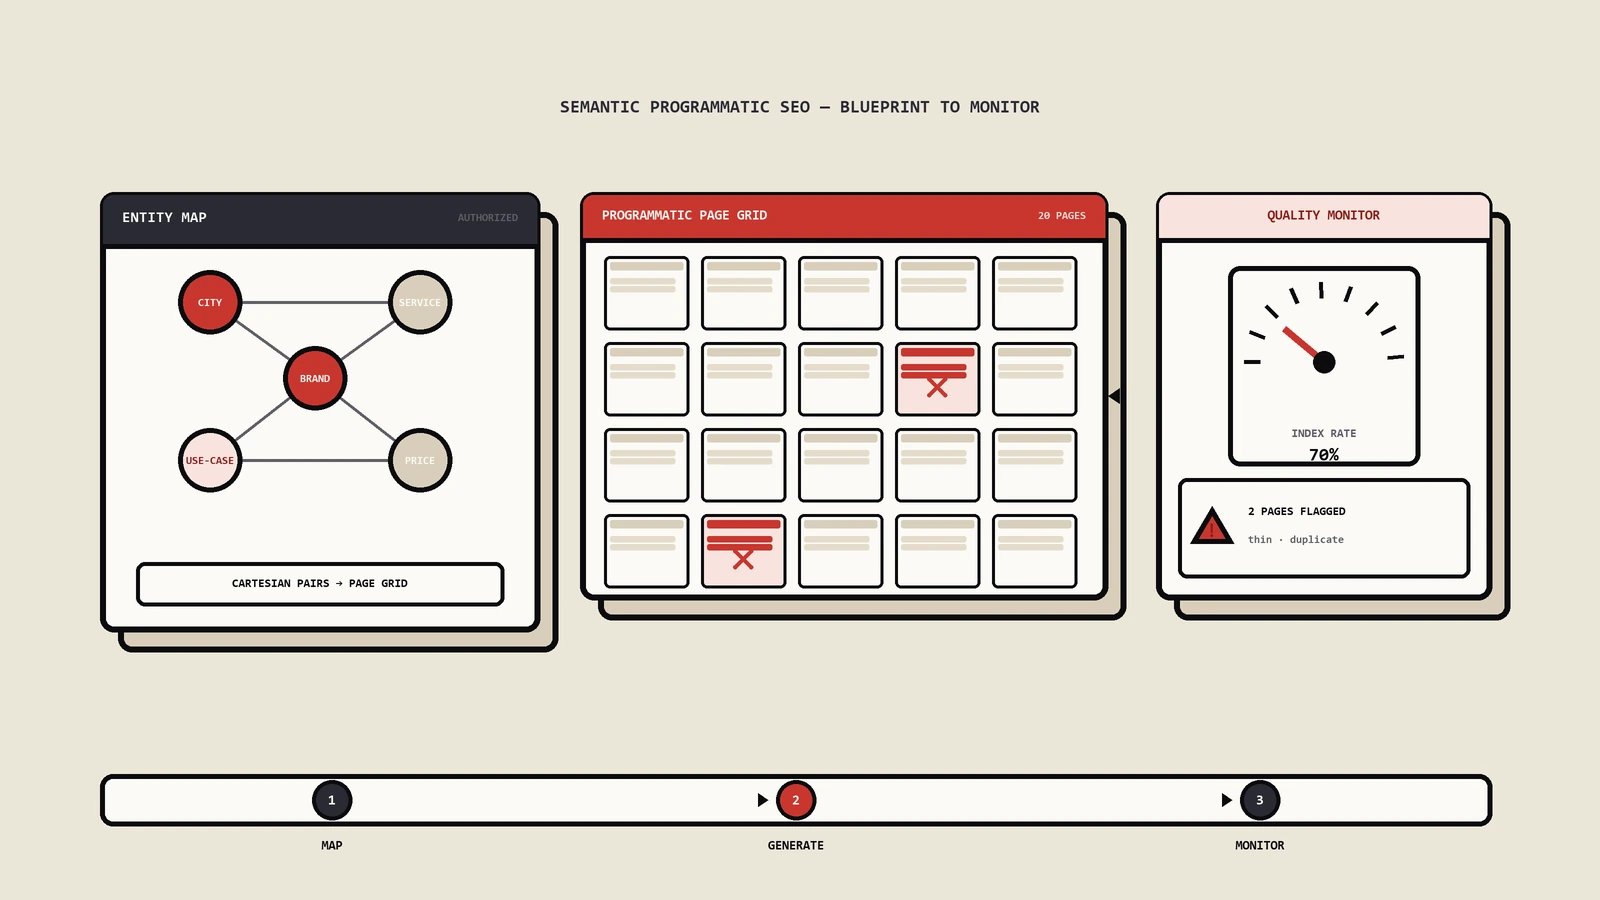
很多人一听程序化SEO就想到批量复制城市名灌出几千个垃圾页,结果被Google按规模化滥用整片打掉。这篇把老式模板填空和真正能跑的语义化做法掰开讲:从GSC授权地图怎么定能打的范围,到品牌护栏怎么防AI写跑偏,再到上千页面怎么靠语义网不变孤岛,最后给一套能照着落地的流水线和踩坑兜底。
宠物用品站的越南语旧地址挂了三个月,撞上去是一张带版本号的英文默认页。这里给出三层来源的判定、自带多语言文档怎么用、按地址前缀出语言的判据与六项上线检查。

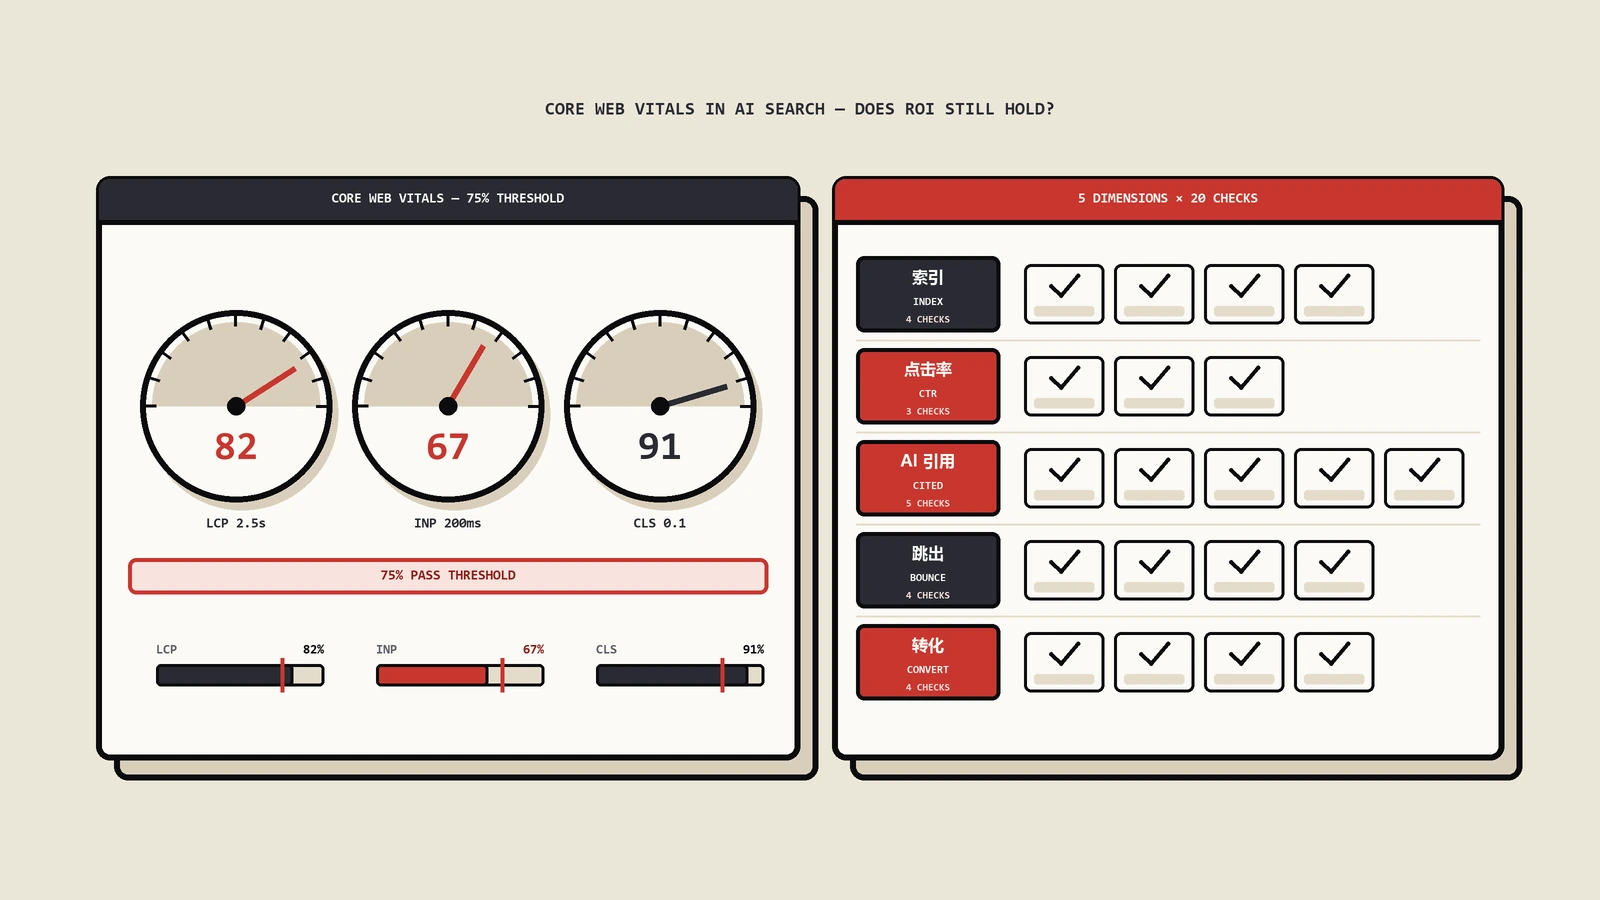
Core Web Vitals在AI搜索时代不再是排名加分项而是retrieval阶段硬门槛。本文聊LCP/INP/CLS对AI检索的真实影响、Jakob Nielsen响应时间模型、行业benchmark的非CWV维度、客户实测3个反常识、图片优化4层路径、转化率+广告成本+AI citation三重ROI。
用PHP正则手写的AMP HTML合规快筛器,把规范里最常见的检查点拆成八大类三十来条规则,一键给出100分制评分和分级错误清单,支持贴码或抓网址。它只覆盖官方两百多条规则的一两成,是开发期粗筛而非上线终审。
