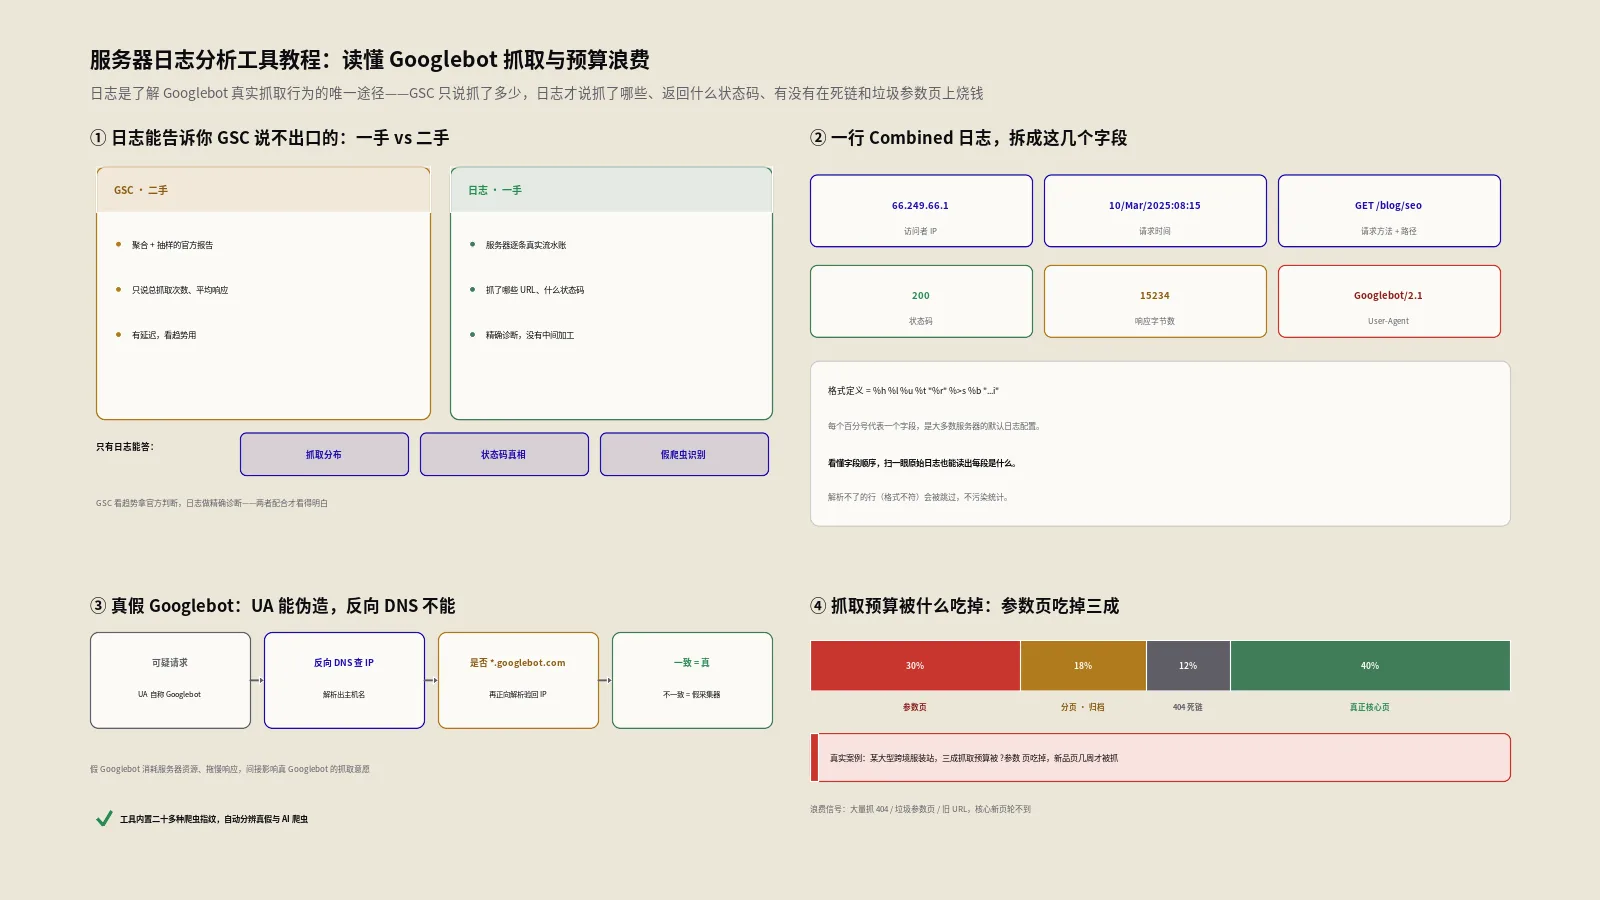
电商SEO最重要的5点:从AI爬虫到accessibility 42步实战
Cloudflare 2026-Q1数据显示30.6%全网流量来自bot。传统技术SEO审计针对Googlebot的那套对GPTBot/ClaudeBot/PerplexityBot不够用。本文拆AI爬虫准入robots.txt策略、SSR成准入门槛、JSON-LD的AI加成、accessibility tree审计、内容位置和可提取性5层框架。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
Cloudflare 2026-Q1数据显示30.6%全网流量来自bot。传统技术SEO审计针对Googlebot的那套对GPTBot/ClaudeBot/PerplexityBot不够用。本文拆AI爬虫准入robots.txt策略、SSR成准入门槛、JSON-LD的AI加成、accessibility tree审计、内容位置和可提取性5层框架。
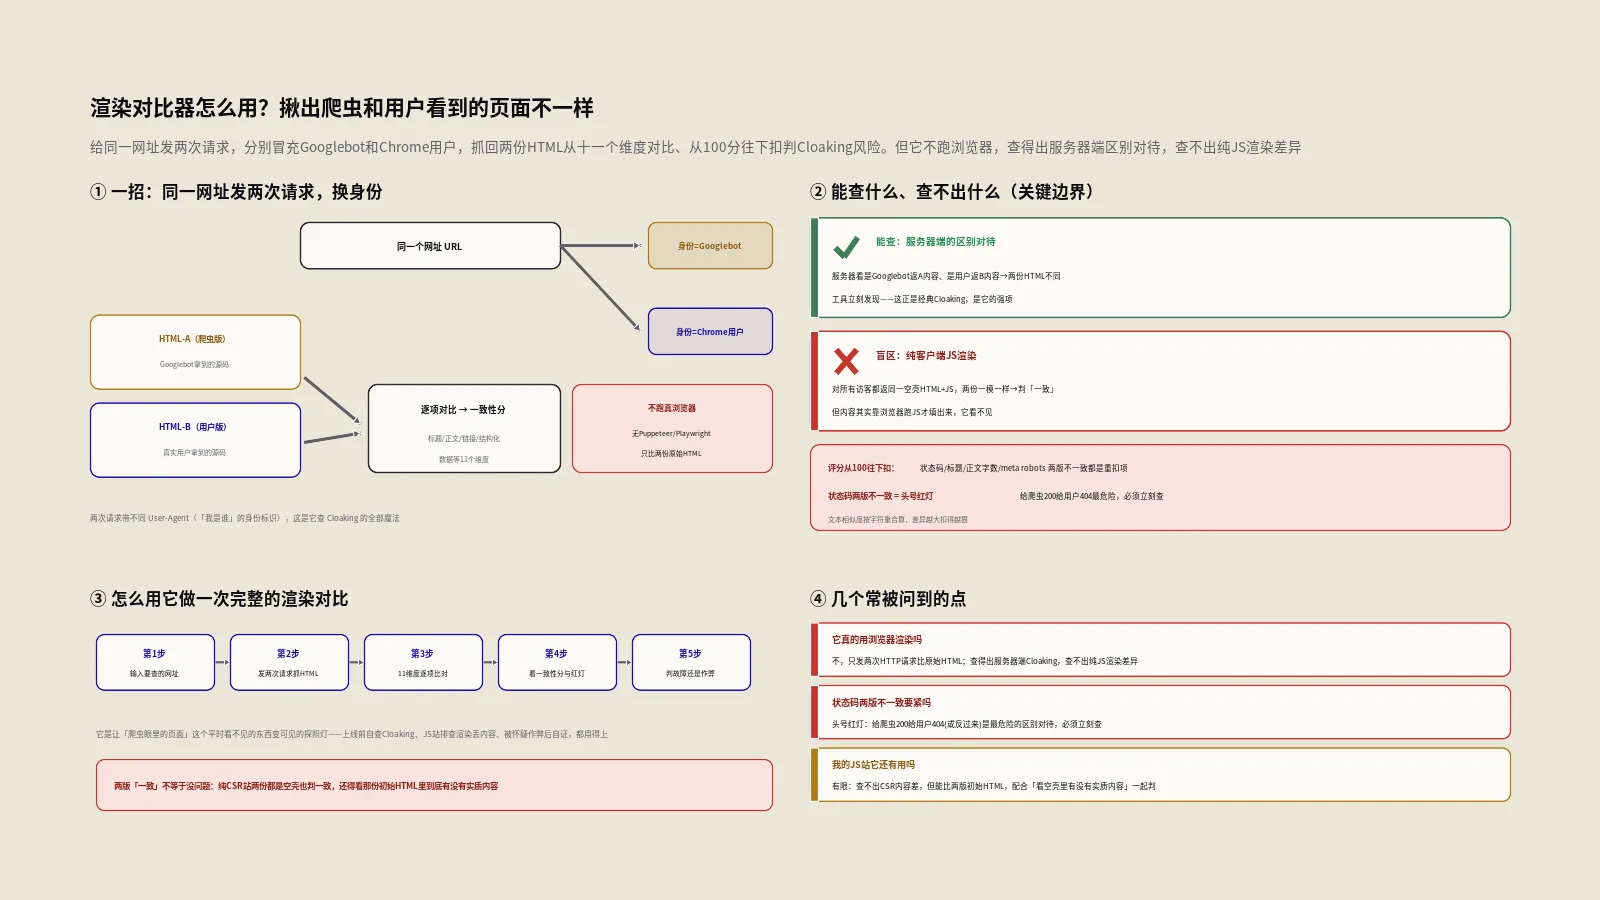
搜索引擎爬虫看到的页面,和真实用户看到的是同一份吗?本文拆解一个渲染对比器:它怎么发两次请求分别冒充Googlebot和用户、从十一个维度对比扣分判Cloaking风险,以及它不跑真浏览器、查得出服务端区别对待却查不出纯JS渲染差异这条关键边界。
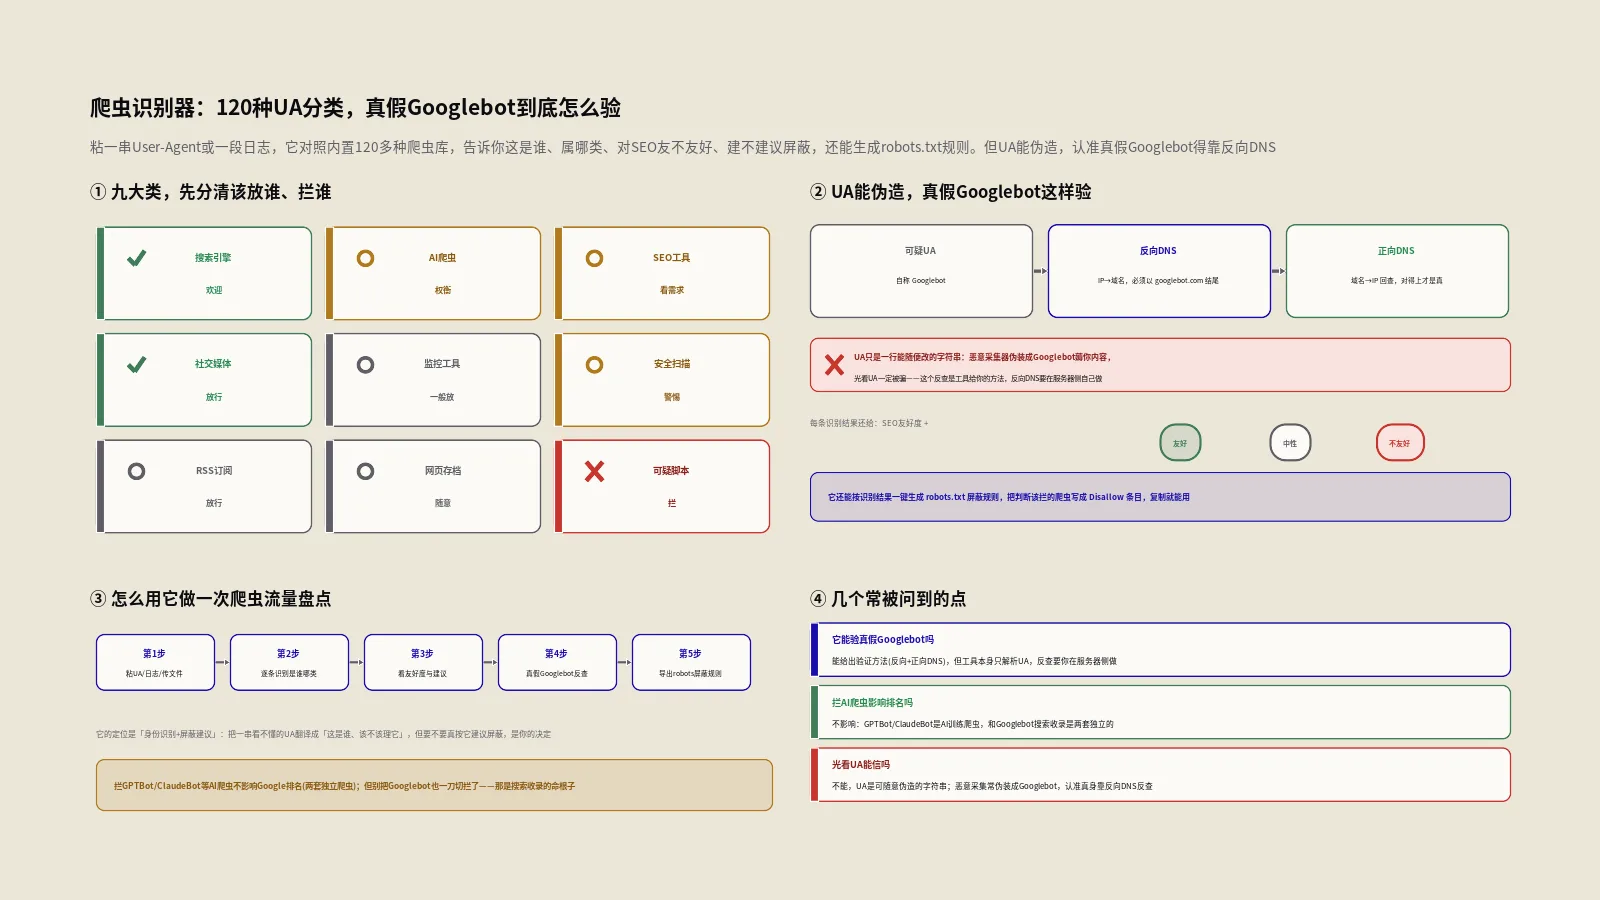
日志里趴着搜索引擎、AI训练、伪装成Googlebot的各种机器人,分不清就谈不上放谁拦谁。本文拆开一个爬虫识别器的120多种爬虫库、9大分类、UA子串匹配逻辑与一键生成robots.txt,讲清真假Googlebot该怎么验、拦AI爬虫到底影不影响排名。
做独立站最容易自我欺骗的就是结构化数据:后台显示已启用,心里就默认它生效了。这篇讲怎么用审计工具照亮这块盲区,把页面实际输出的数据原样提取、逐字段核对,连主题和插件打架输出两套数据这种隐患也能揪出。
把含中文、空格、特殊符号的内容在网址里安全编码与还原,提供component、uri、full三种模式按场景选用,还能拆解一条网址的结构、把满屏百分号的乱码网址解回真身。它不支持中文域名的Punycode,也不替你规范化路径。
sitemap动辄上万行,肉眼看不出装了多少URL、有没有垃圾页。本文拆开一个sitemap提取器识别6种格式、递归展开索引、统计域名与路径分布的逻辑,讲清50000条与50MB两条官方上限的来历,以及它能提取什么、不能验证什么。
联盟营销网站遇到流量瓶颈和收入天花板怎么办?本文从流量停滞、收入平台期、内容枯竭、选品困局四大维度出发,提供8个可直接落地的数据驱动增长策略,涵盖多平台分发、受众画像挖掘、UGC社区构建、AI辅助选题等实操方法,帮助Affiliate站长突破增长瓶颈。

做技术SEO最冤的bug,是结构化数据因为一个标点失效却查了好几天。这篇讲怎么用一台JSON校验工具,把这类语法层的坑在上线前两秒钟拦下来,让丢给Google测试的代码只剩真正的字段问题。
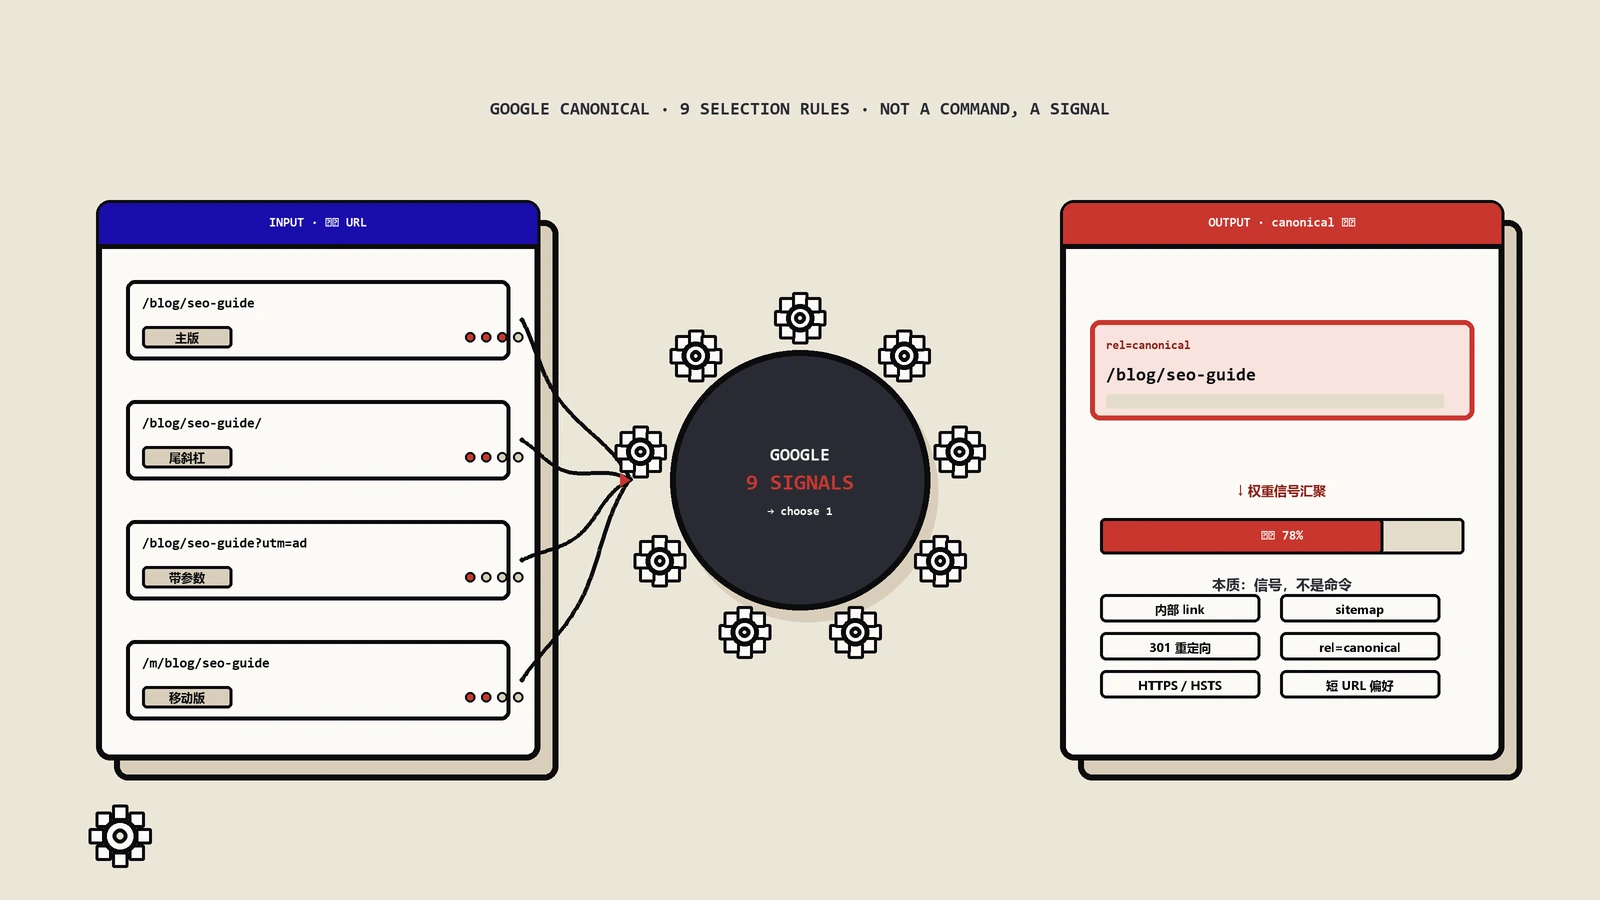
深度解析Google选择Canonical URL的9大核心逻辑,包括精确重复、部分匹配、URL参数推断、移动端版本、渲染失败等场景,附带系统化排查流程与实操修复策略,帮你彻底解决canonical被选错导致的收录和排名问题。
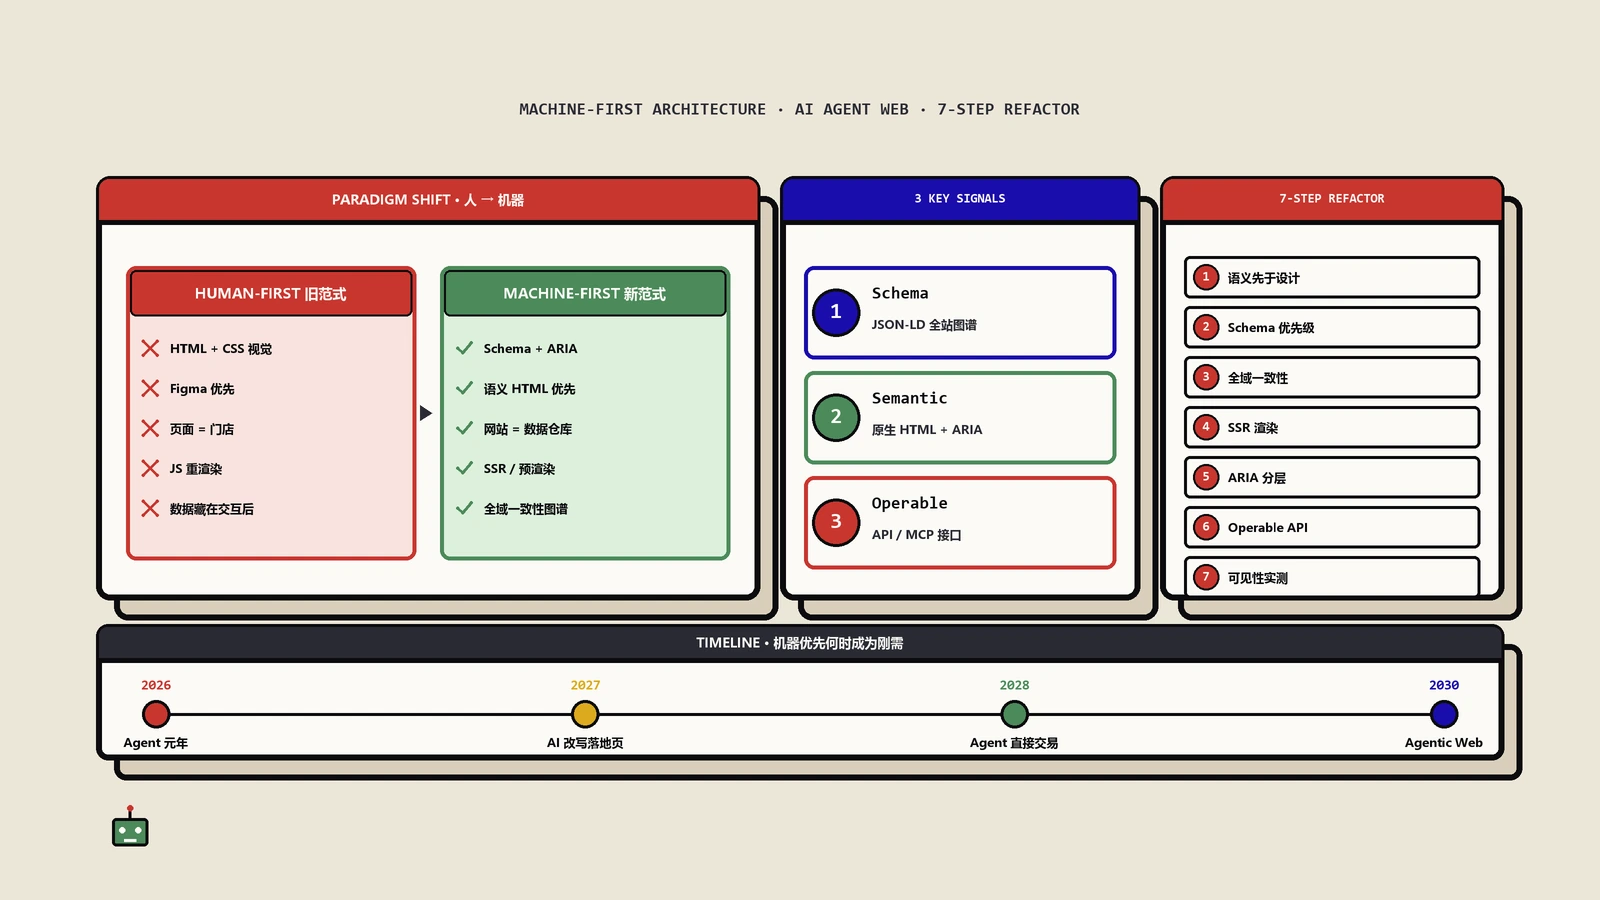
深度解析机器优先架构的技术原理与落地策略,从Schema结构化数据、AI代理适配到结账协议化,帮你的网站在AI代理时代抢占先机。
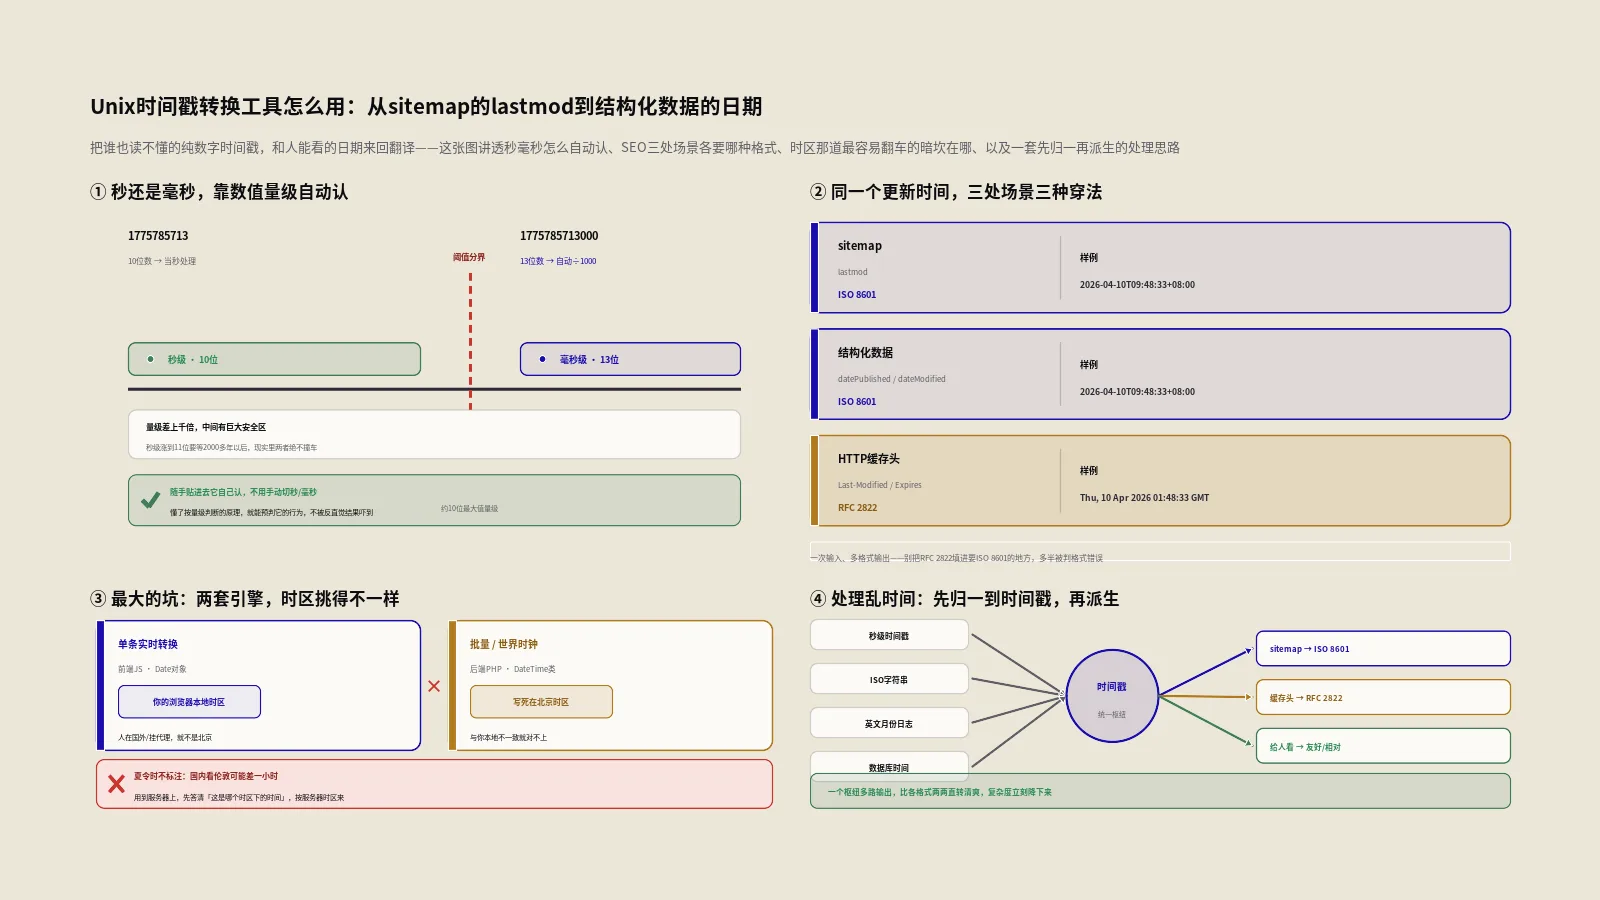
日志里那串十位数字到底是哪天?sitemap的lastmod又该填什么格式?这款Unix时间戳转换工具把时间戳和日期来回翻译,一口气给出ISO 8601、RFC 2822等多种格式。本文讲清它怎么用、时区这道最容易翻车的暗坎,以及怎么把lastmod和结构化数据日期填对。
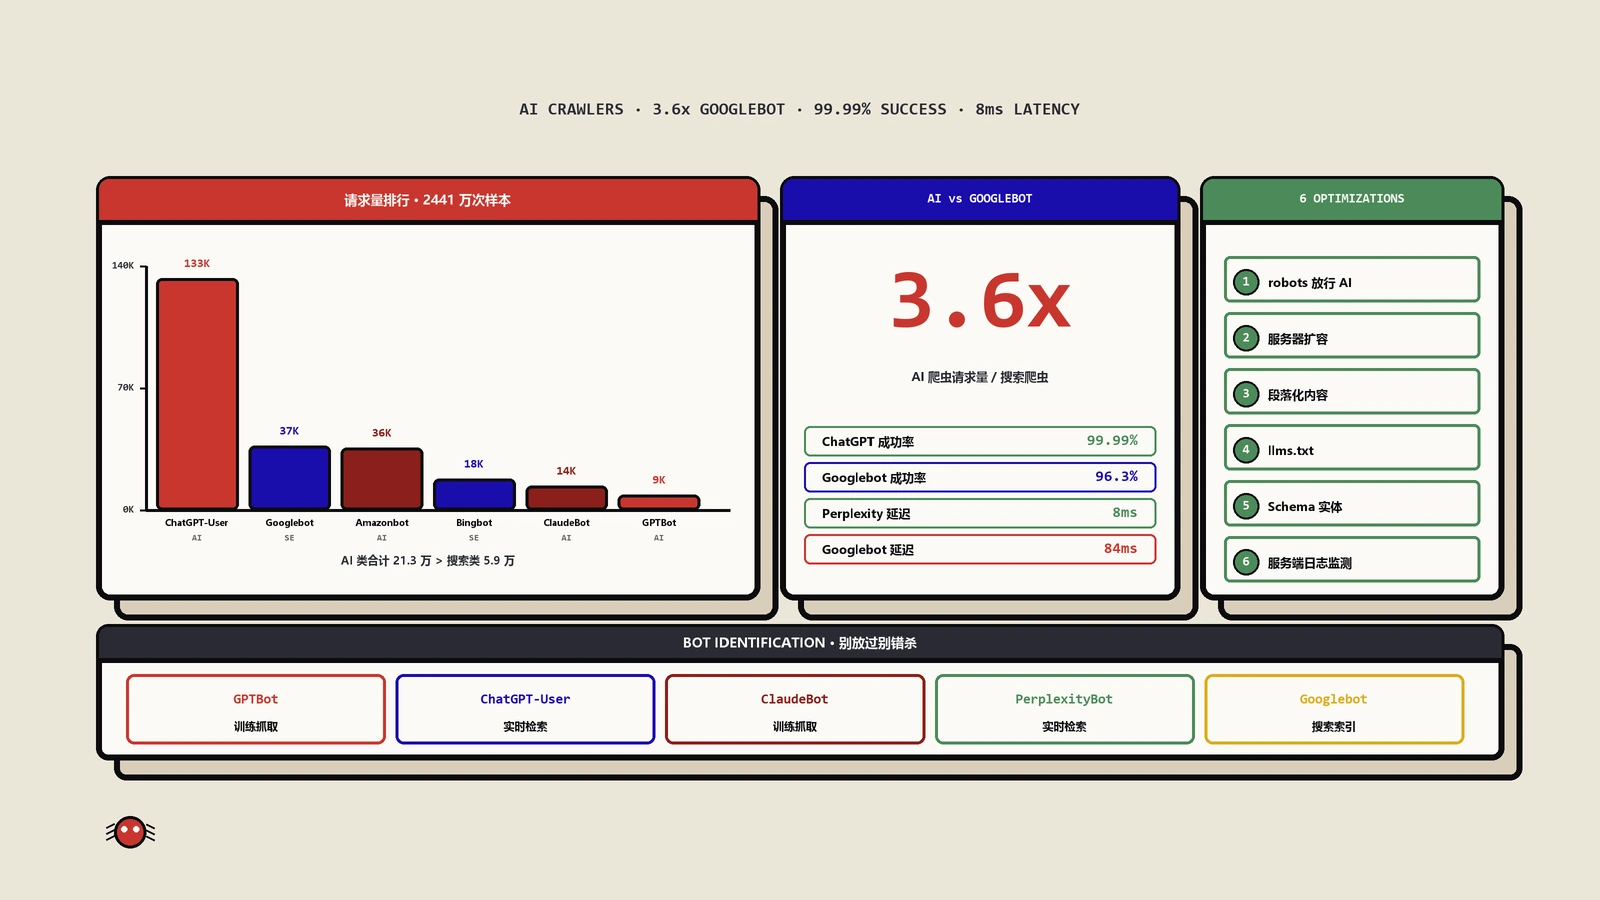
2400万次请求数据揭示,ChatGPT爬虫抓取量已达Googlebot的3.6倍。本文深度解析AI爬虫生态格局,提供robots.txt配置、抓取预算优化、AI搜索可见性提升等实操策略。
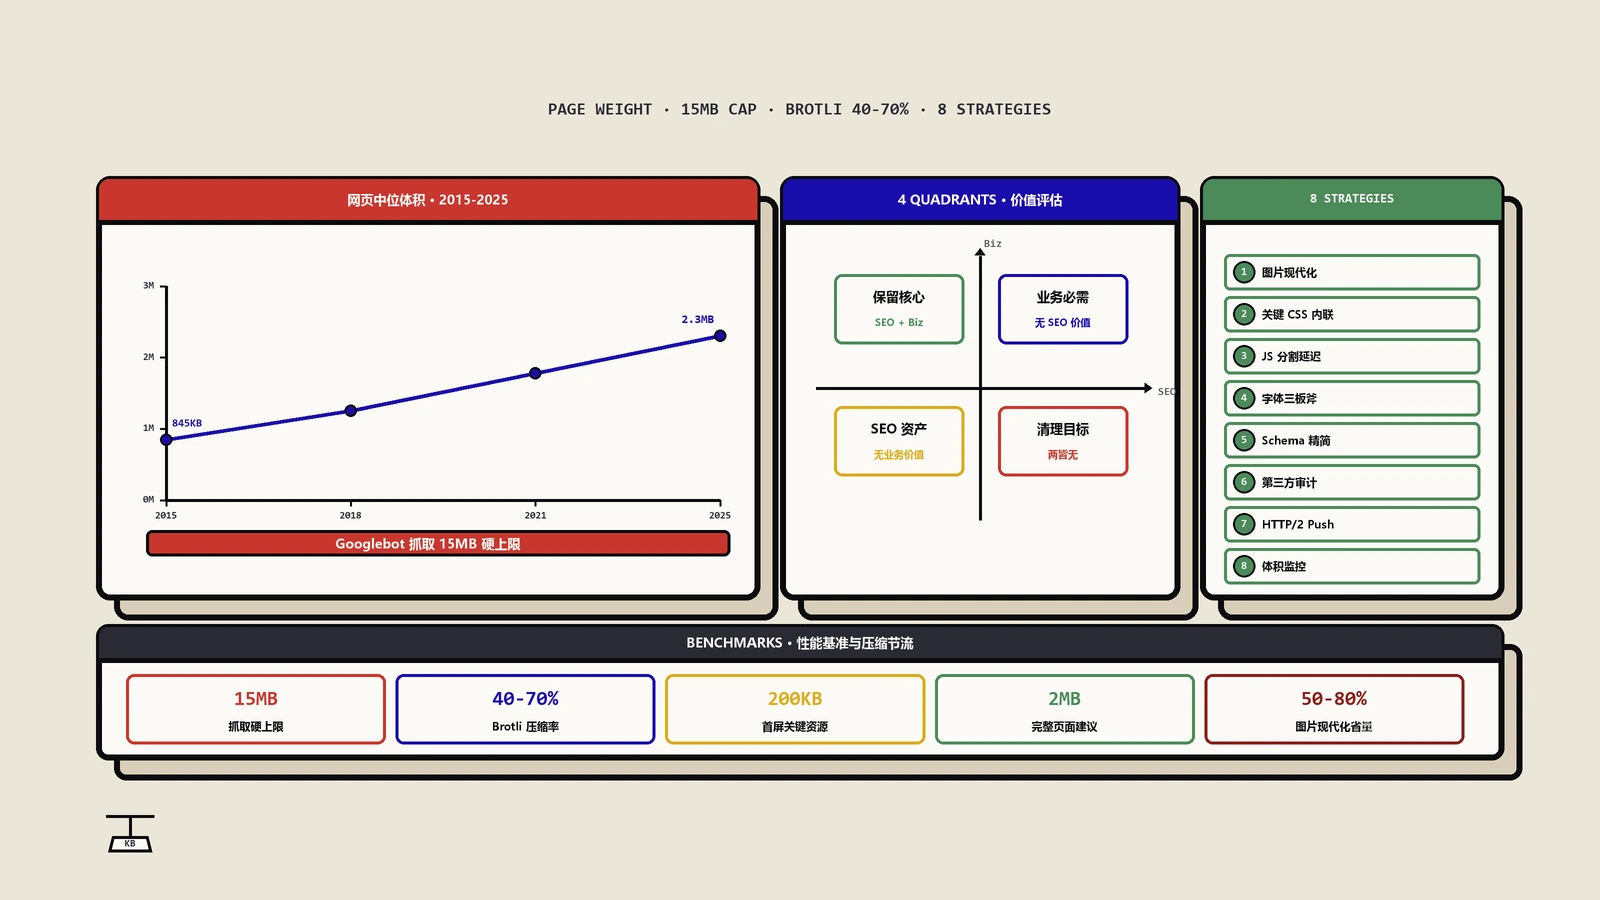
深度解析Google官方对网页体积与SEO关系的最新表态,拆解页面大小的定义陷阱、Brotli压缩机制、内容与标记比率,提供8个按投入产出比排序的页面瘦身与性能优化策略。
Google 已于 2026 年 4 月 27 日修复 GSC 展示量虚高 Bug,但只向前修,近一年的旧数据永远不补。这篇讲清精确的污染窗口、为什么同比环比会被这条数据断层带偏、修复后要抢着做的几件事,以及把主指标永久换成点击量的完整复盘方法。

用Schema.org的significantLink和relatedLink标记内链是被严重低估的技术SEO技巧。保哥讲透两者语义差异、PageRank传递机制、博客文章电商分类与产品页JSON-LD完整代码示例,以及WordPress和Shopify的快速部署方案与最佳实践。

总有人问:我做B端,是不是得用一套完全不同的SEO,谷歌会不会拿特殊标准来排我?这篇把两层问题拆开——算法层面,所有站点共用同一套排名系统;策略层面,因为买家从一个人变成一群人,选词、内容、转化、衡量都得整体挪位。最后给你一把光谱尺子帮自己定位。

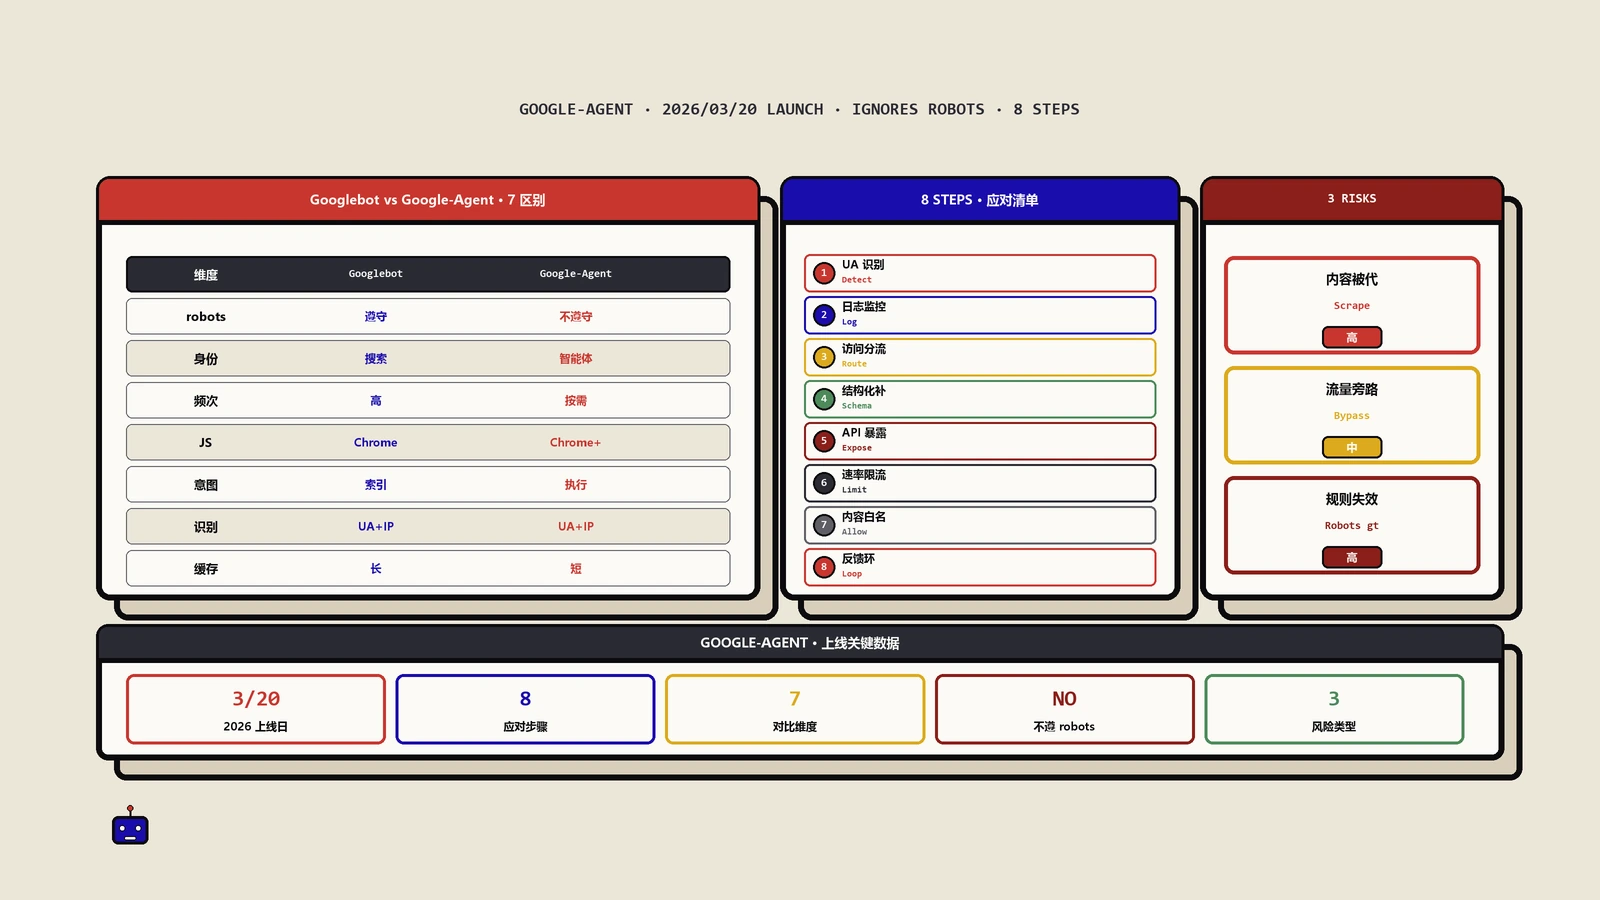
Google在2026年3月正式新增Google-Agent用户代理,标志AI智能体爬虫从实验室走向生产环境。本文深度解析Google-Agent的工作原理、与Googlebot的本质区别、IP范围与robots.txt策略、CDN与WAF配置要点,以及Agentic SEO时代网站主必须做的前瞻布局与监控方案。
2026年3月Google更新论坛和问答结构化数据,新增digitalSourceType属性标记AI生成内容。本文从IPTC标准、JSON-LD代码示例到commentCount和sharedContent扩展,全面拆解技术细节及对SEO与GEO的实际影响,并附C2PA认证关系与不同类型网站落地实施清单。

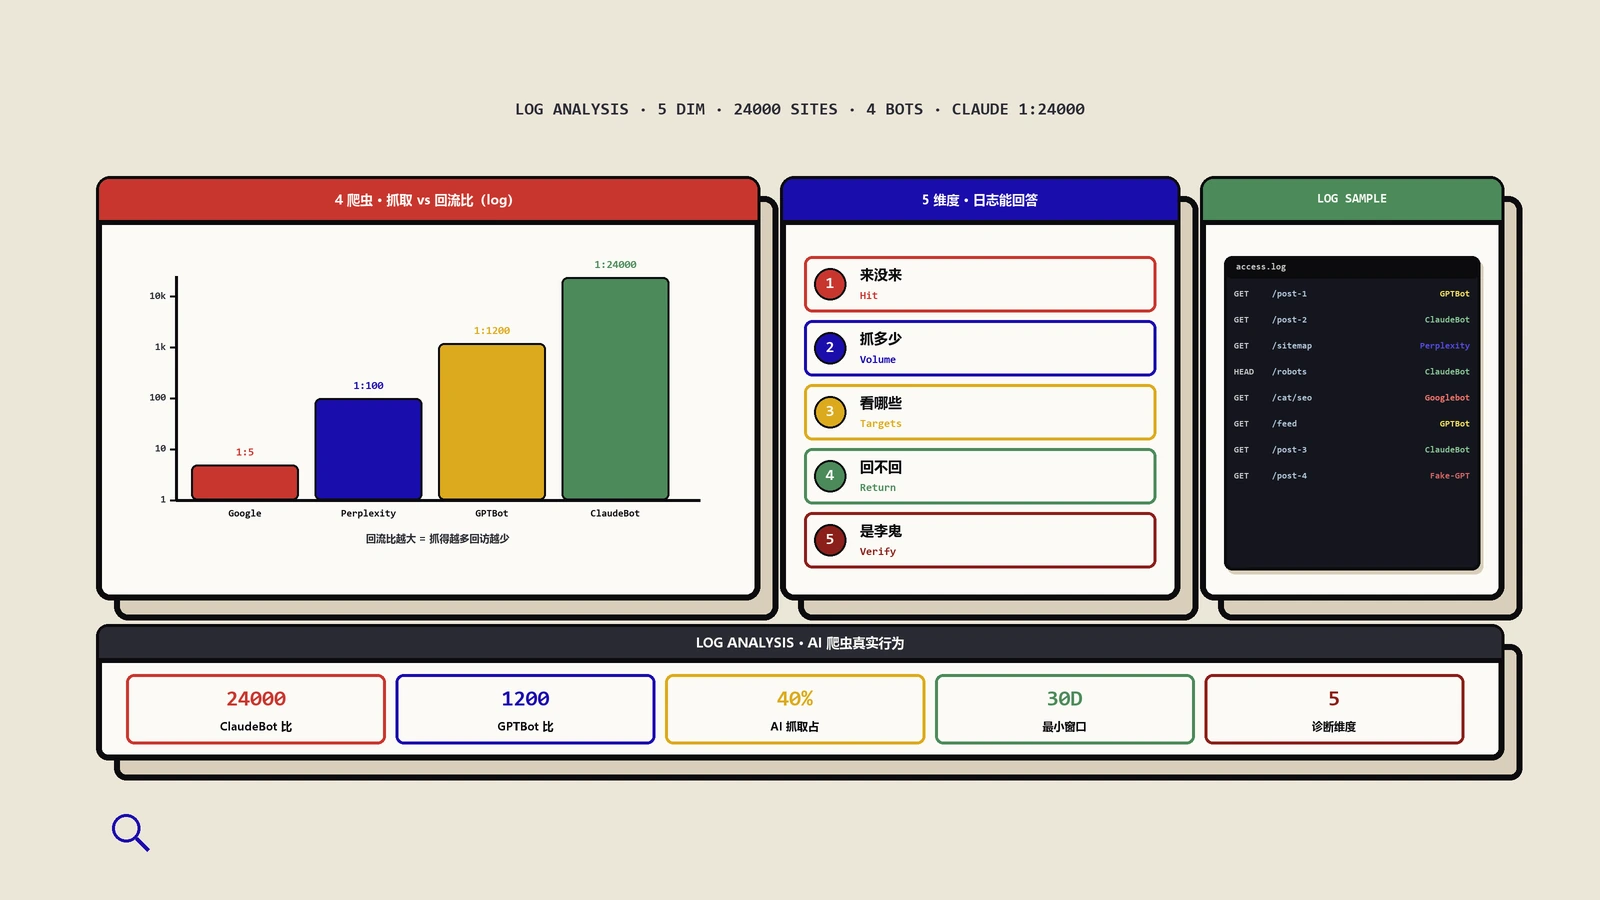
你的内容每天被AI爬虫抓走喂进ChatGPT和Claude的回答,但没有任何官方报表能让你看见这件事。这篇带你用服务器日志补上这块盲区:分清训练型与检索型爬虫为什么要区别对待、五层诊断怎么一步步深入、命令行和Python脚本怎么落地、日志为什么必须搬出主机长期存,以及robots.txt分层和迁移验真该怎么做。
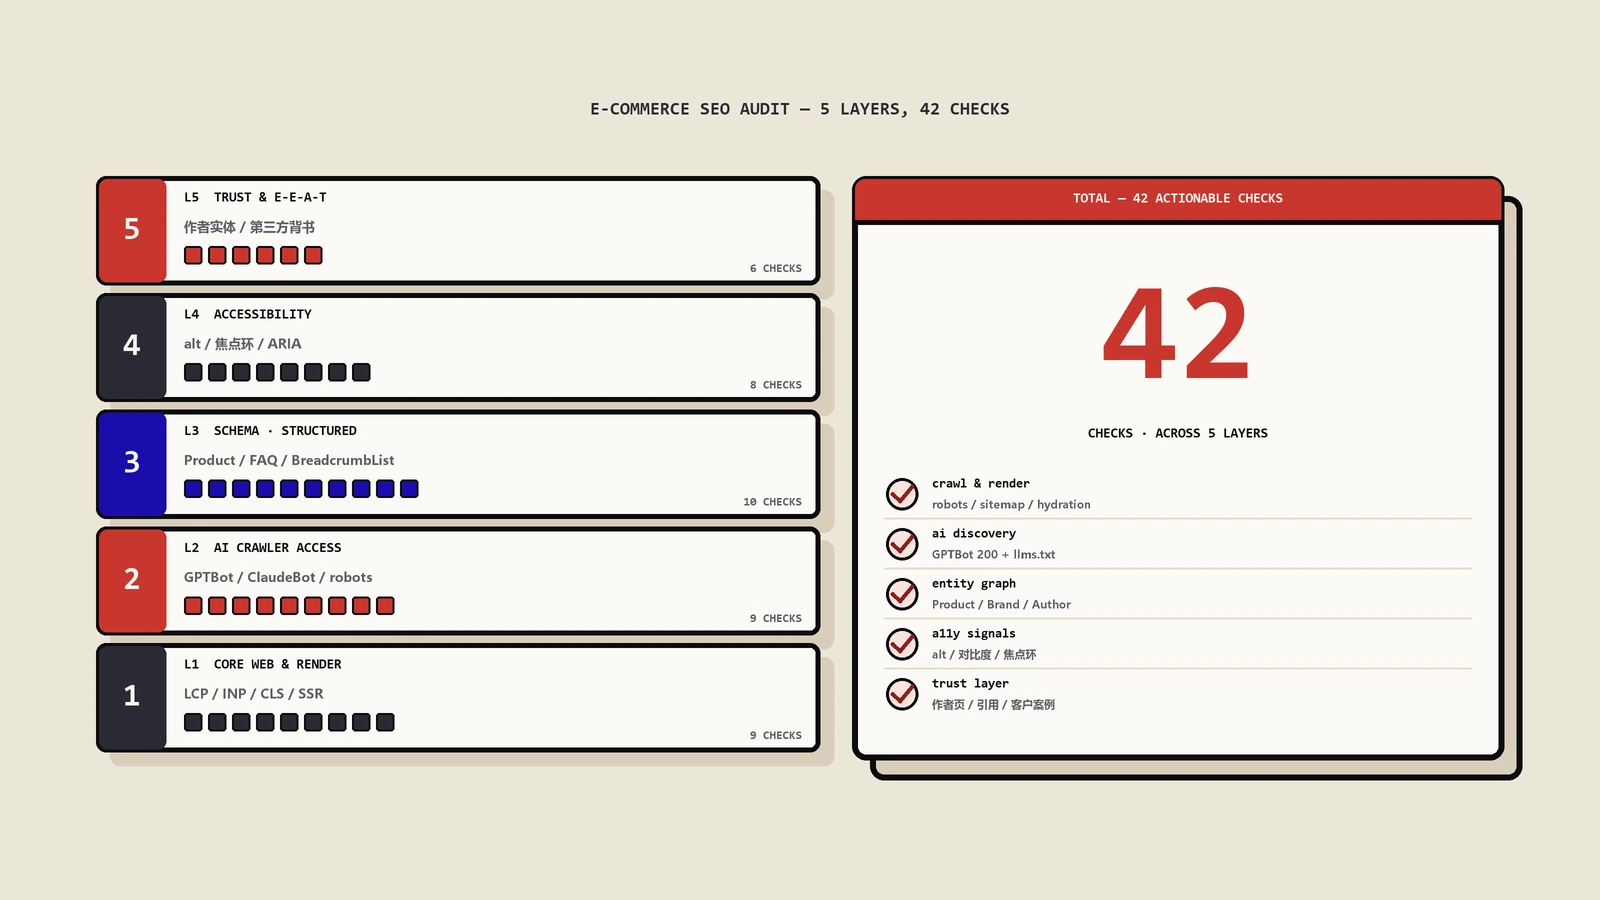
Search Console只告诉你抓了多少,日志才告诉你抓了哪些、有没有在死链和参数页上烧钱。这款工具解析爬虫日志,几分钟揪出抓取预算浪费点。