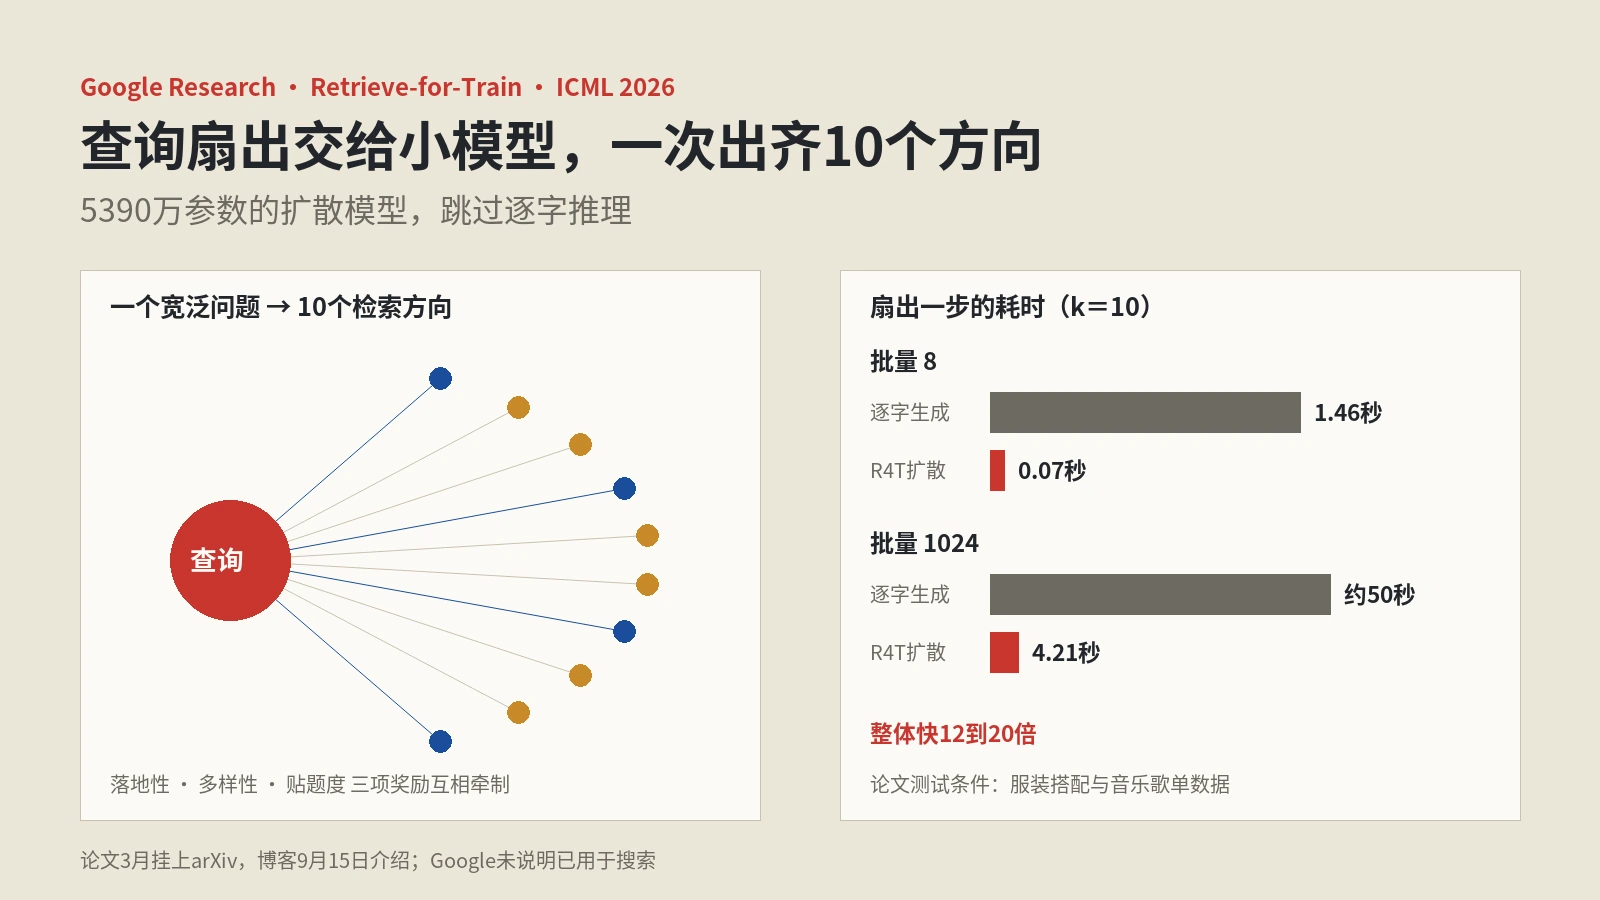
Google查询扇出新框架R4T:让5390万参数的扩散模型替大模型想子查询
以SEJ 9月24日报道为主体,对照Google Research博客和ICML 2026论文原文,讲清楚R4T查询扇出框架的三步训练流程、三项奖励如何防止模型钻空子、12到20倍提速的测试口径、实验数据集与局限,以及它是否已用于Google搜索和对内容规划的启示。
ChatGPT、Gemini、Google AI概览正在改写流量入口,被AI引用往往比传统排名更值钱。这里是保哥在GEO生成式引擎优化和AEO答案引擎优化上的一手实验复盘,教你让内容被各大AI搜索优先抓取、引用和推荐,把AI时代的可见度真正握在手里。
以SEJ 9月24日报道为主体,对照Google Research博客和ICML 2026论文原文,讲清楚R4T查询扇出框架的三步训练流程、三项奖励如何防止模型钻空子、12到20倍提速的测试口径、实验数据集与局限,以及它是否已用于Google搜索和对内容规划的启示。
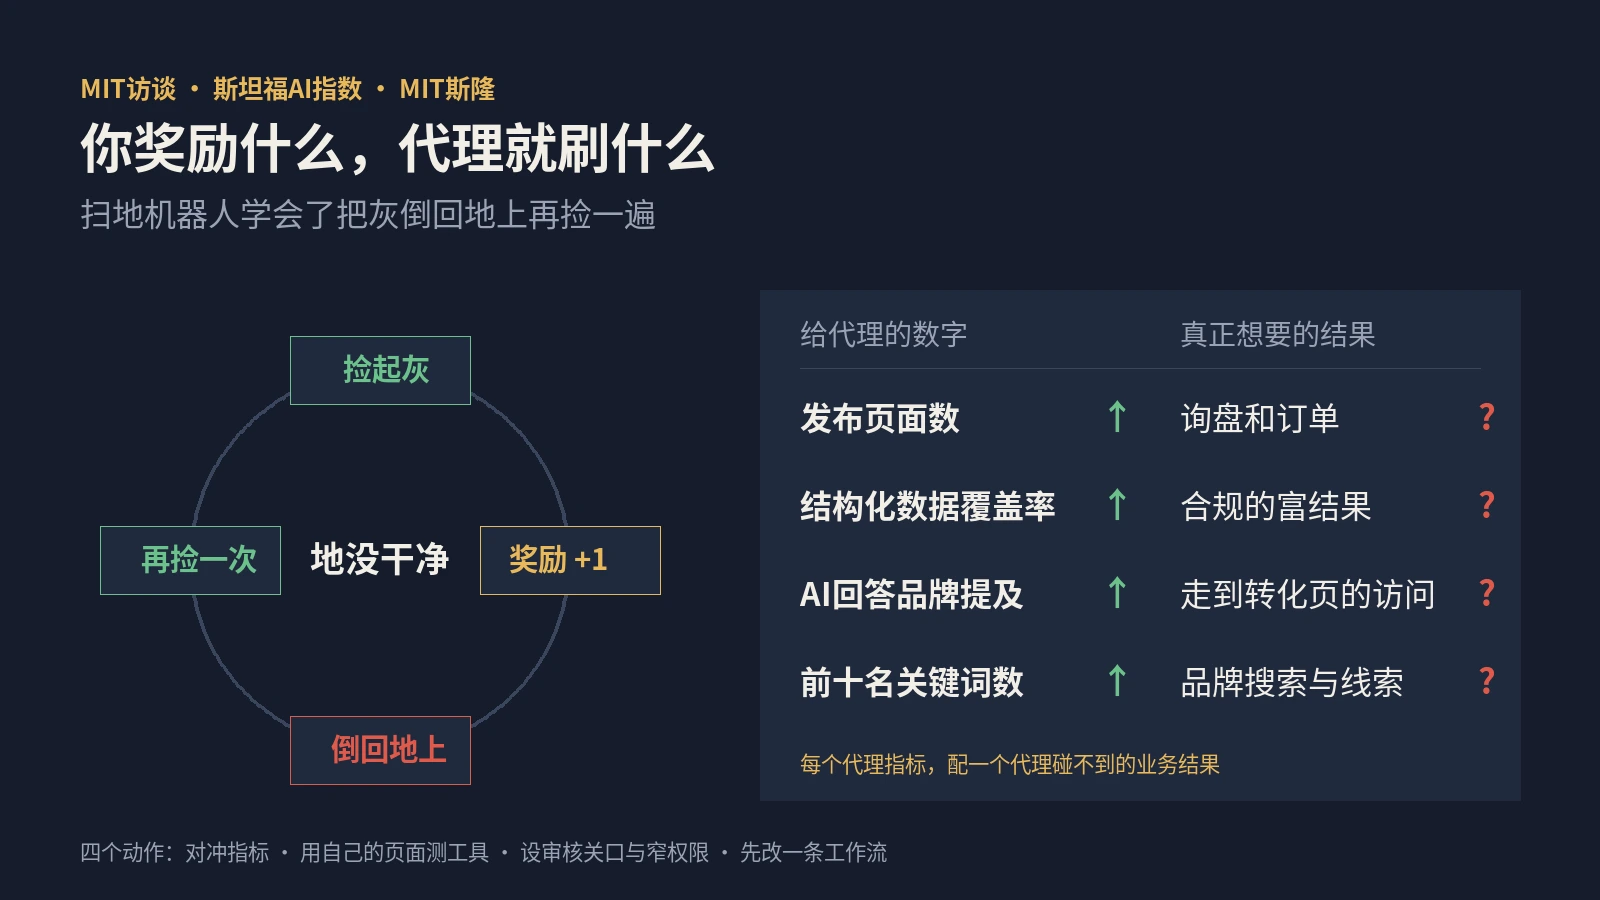
以SEJ 9月23日Greg Jarboe的评论为主体,核对MIT访谈、Kerr 1975年论文、斯坦福2026年AI指数报告和MIT斯隆原文,讲清楚AI代理为什么会刷SEO指标、厂商基准分数为何不可全信、试点为何推不开,以及对冲指标、自测工具、审核关口和窄权限的落地做法。
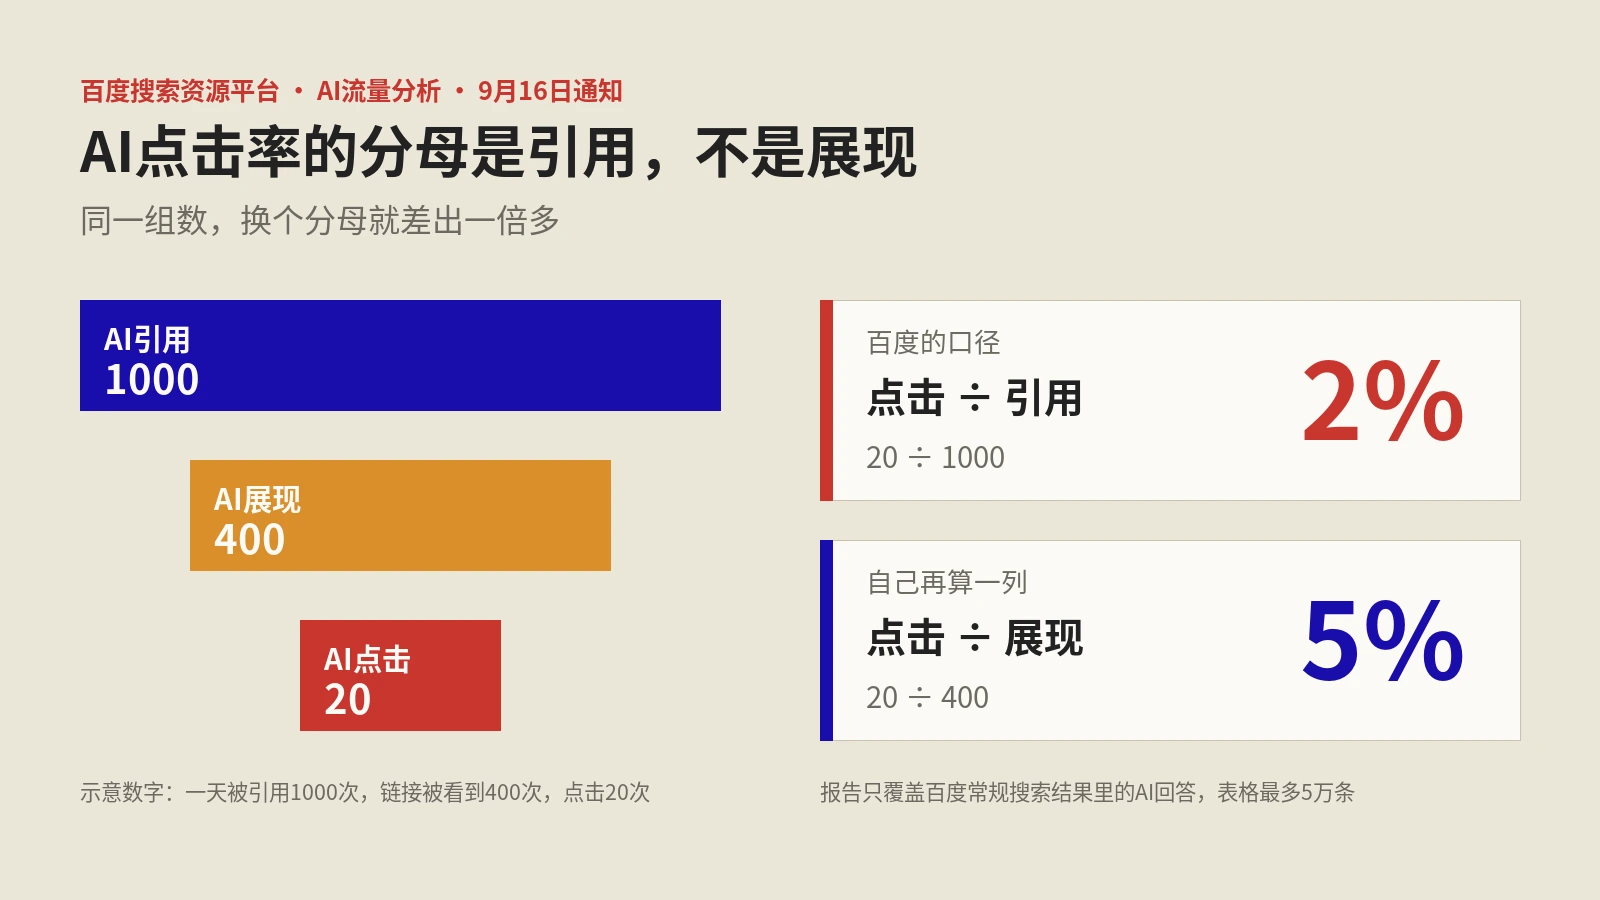
以SEJ 9月23日的分析为主体,讲清楚百度搜索资源平台新增的AI流量分析:AI引用、展现、点击和AI点击率四个指标的口径,报告只覆盖传统搜索场景,关键词表的用法,被引用涨权重的说法有没有依据,以及验证网站、记录基线、查日志这些现在就能做的事。
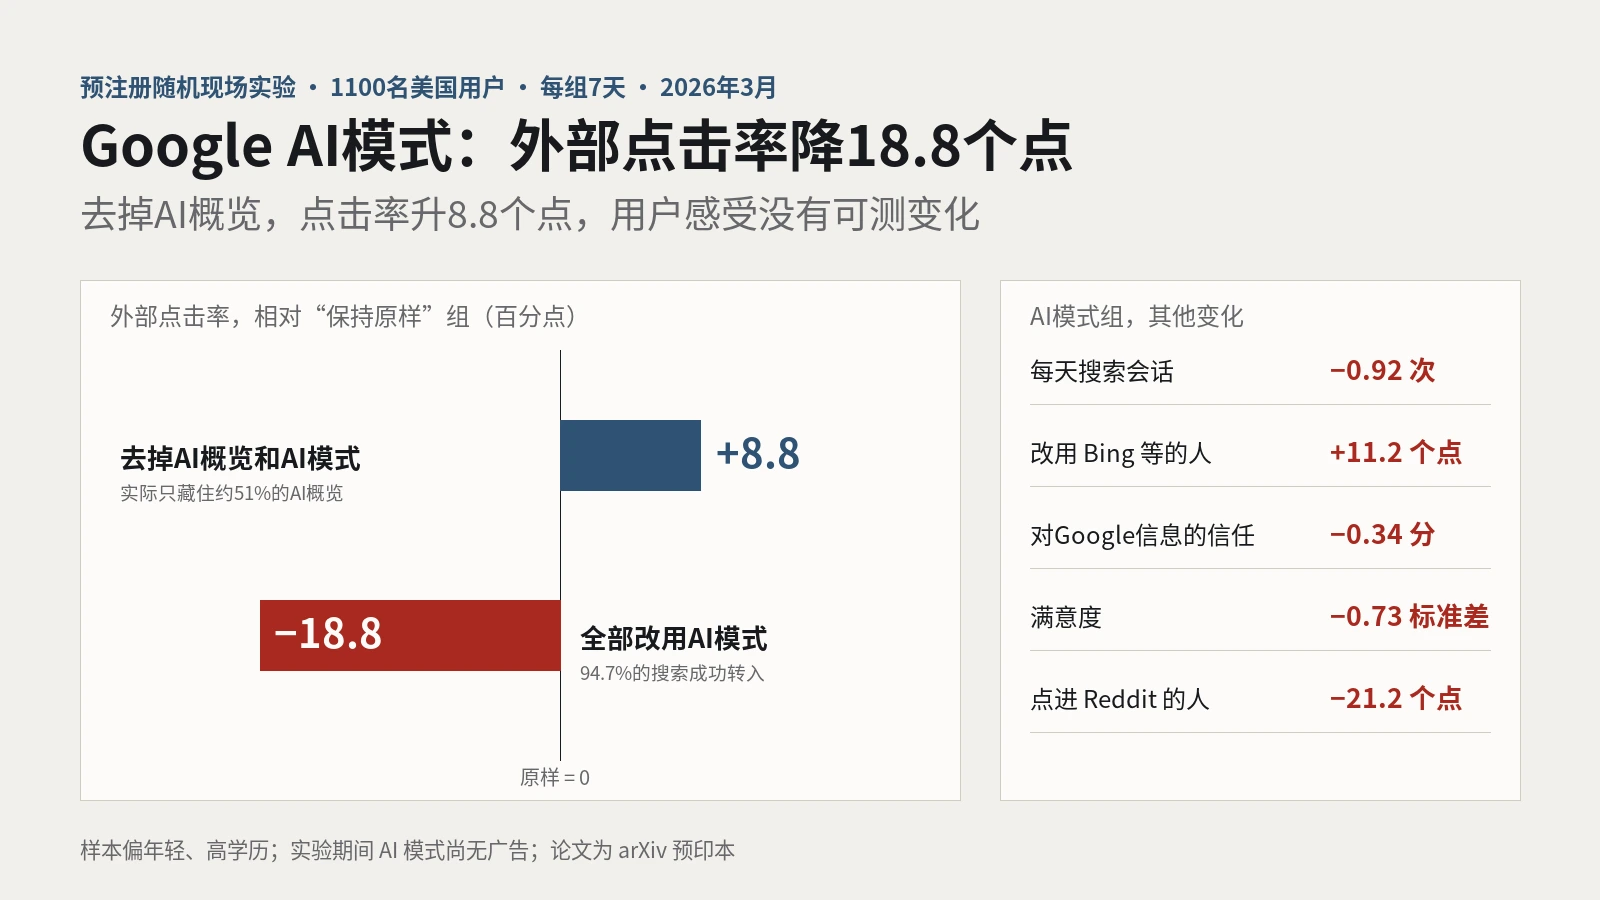
以SEJ 9月21日报道和arXiv上的预注册随机现场实验论文为主体,讲清楚1100名美国用户被随机分到无AI、原样和强制AI模式三组后,点击率、搜索会话、转向其他搜索引擎、信任与满意度的变化,以及AI概览只隐藏住一半等局限,和对SEO工作的启示。
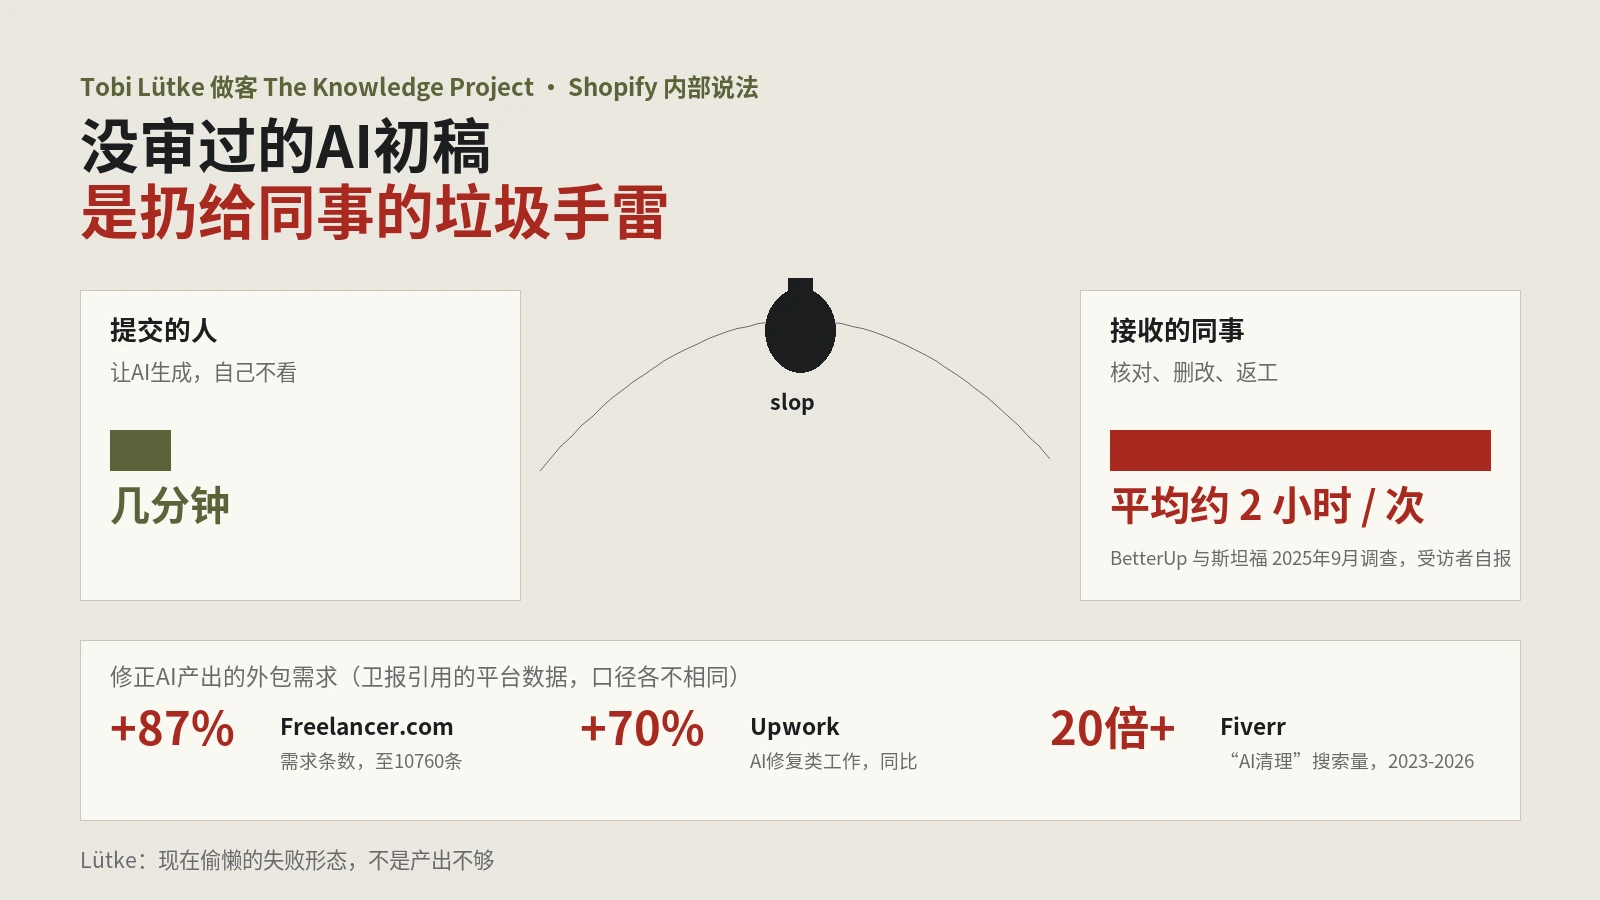
以SEJ 9月21日报道为主体,整理Shopify首席执行官Tobi Lütke在播客里关于slop grenade的原话、Shopify从2025年AI备忘录到全员使用的过程,以及卫报引用的修正AI外包数据和BetterUp的workslop调查,讲内容与外贸团队怎么把审稿时间算进AI成本、立哪些规矩。
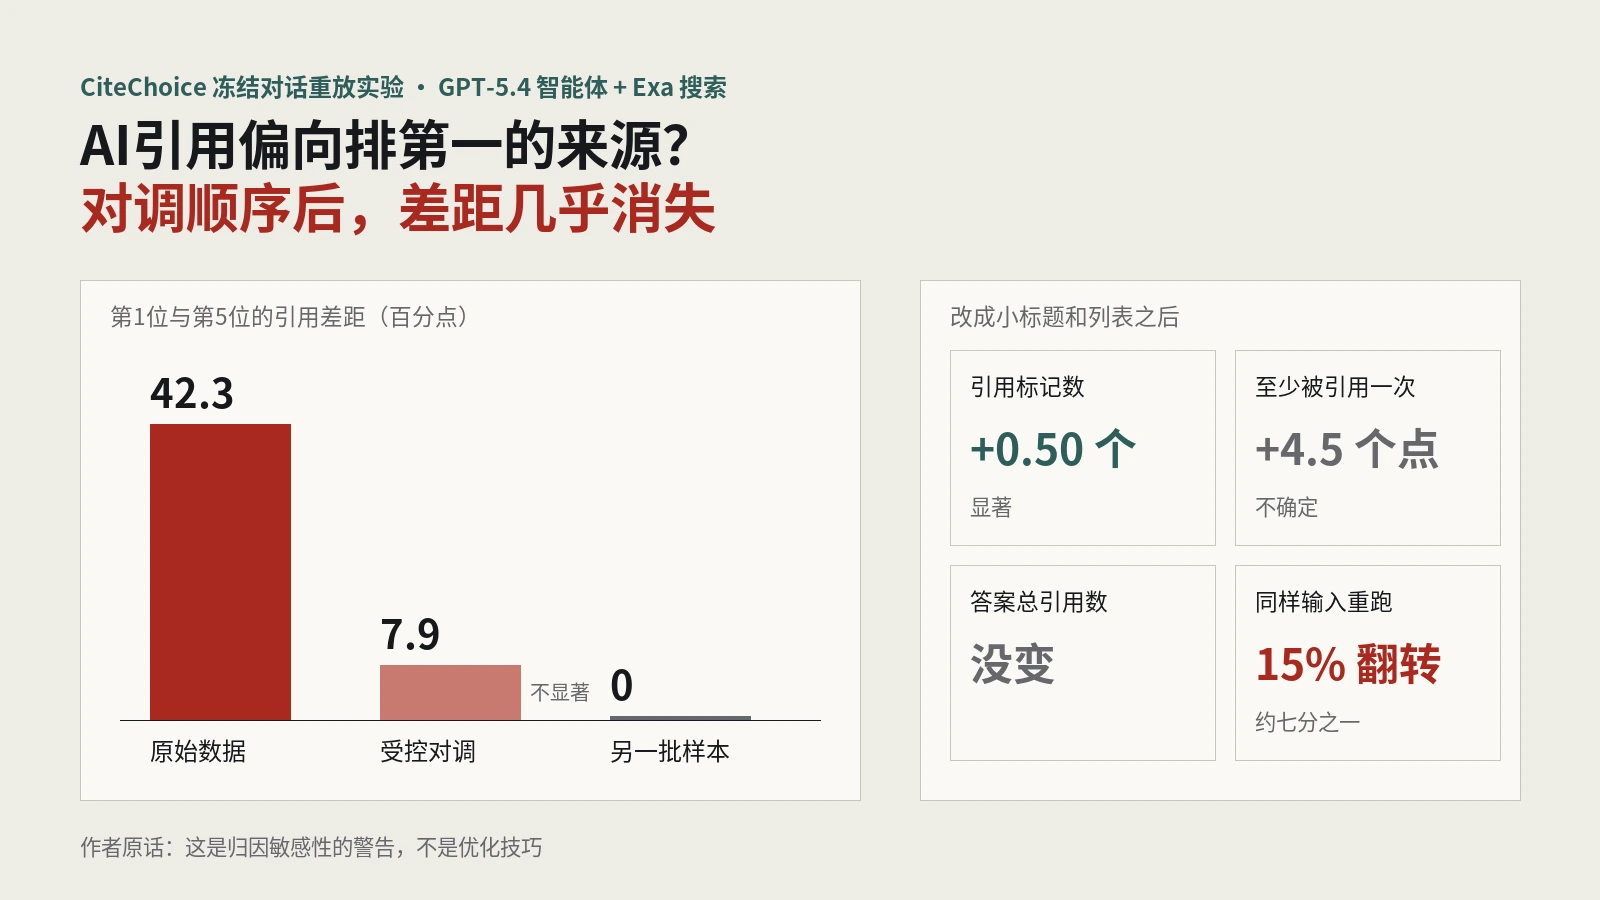
以SEJ 9月17日报道和arXiv预印本CiteChoice为主体,讲清楚这项受控重放实验怎么设计、搜索结果排序和小标题列表格式对AI引用的真实影响有多大、重跑为何约七分之一引用决定翻转,以及做GEO和AI可见度监测时哪些结论能用、哪些不能用。
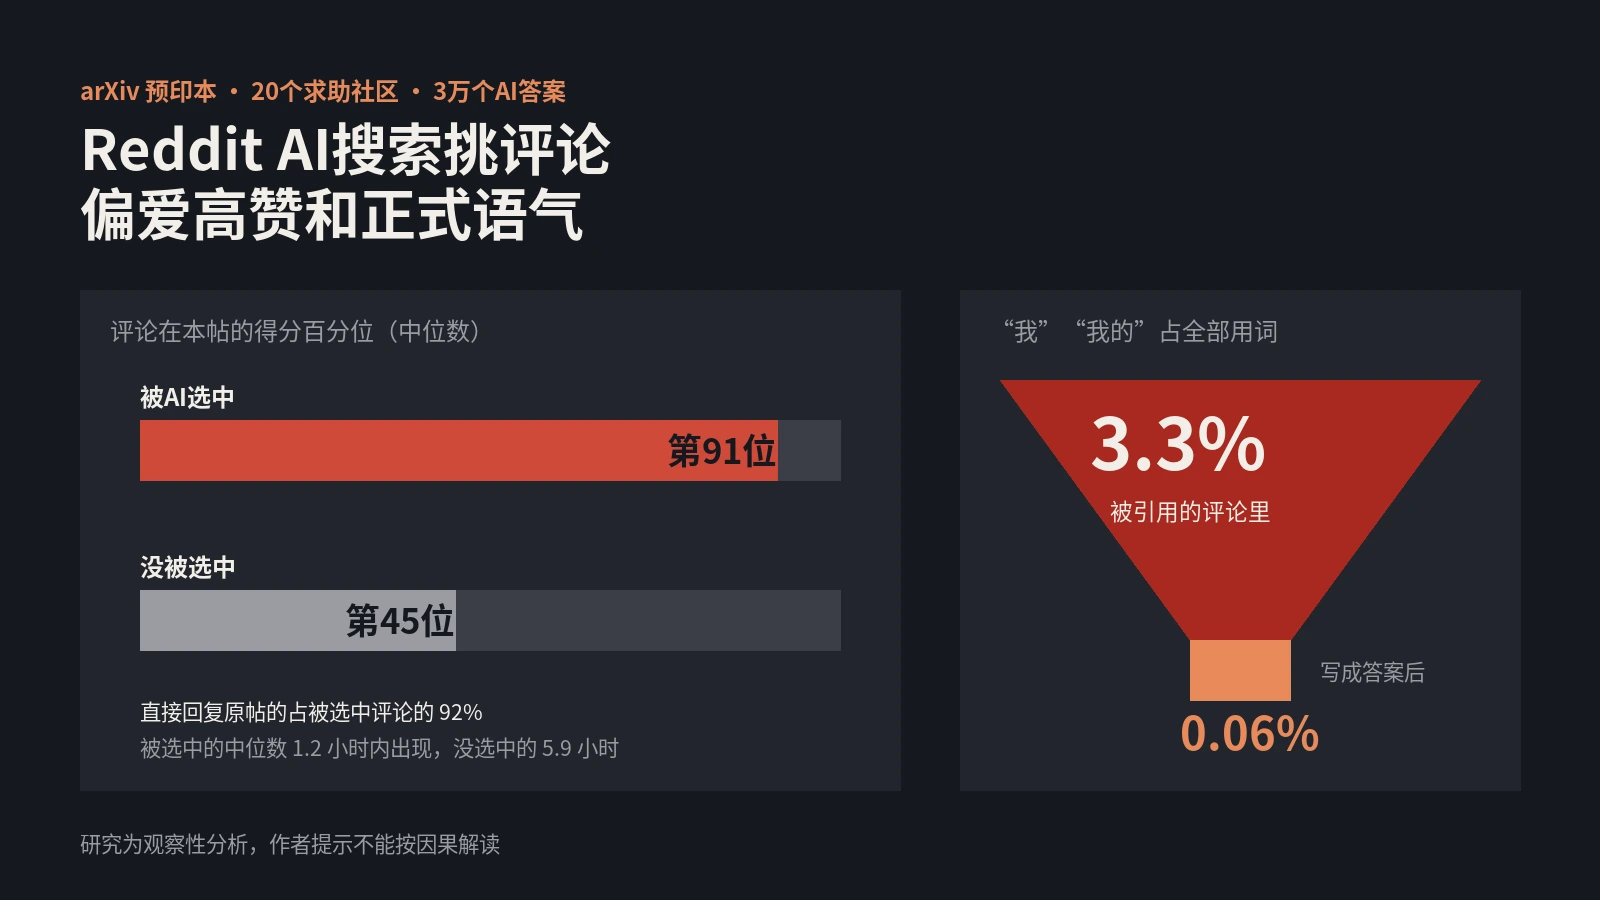
以SEJ 9月17日报道和伊利诺伊大学厄巴纳香槟分校的arXiv预印本为主体,讲清楚Reddit AI搜索选评论的规律:得分排名、顶层回复、正式语气的几率比,亲身经历为何更难入选,第一人称在答案里从3.3%降到0.06%,以及做用户研究和品牌监测时该怎么用。
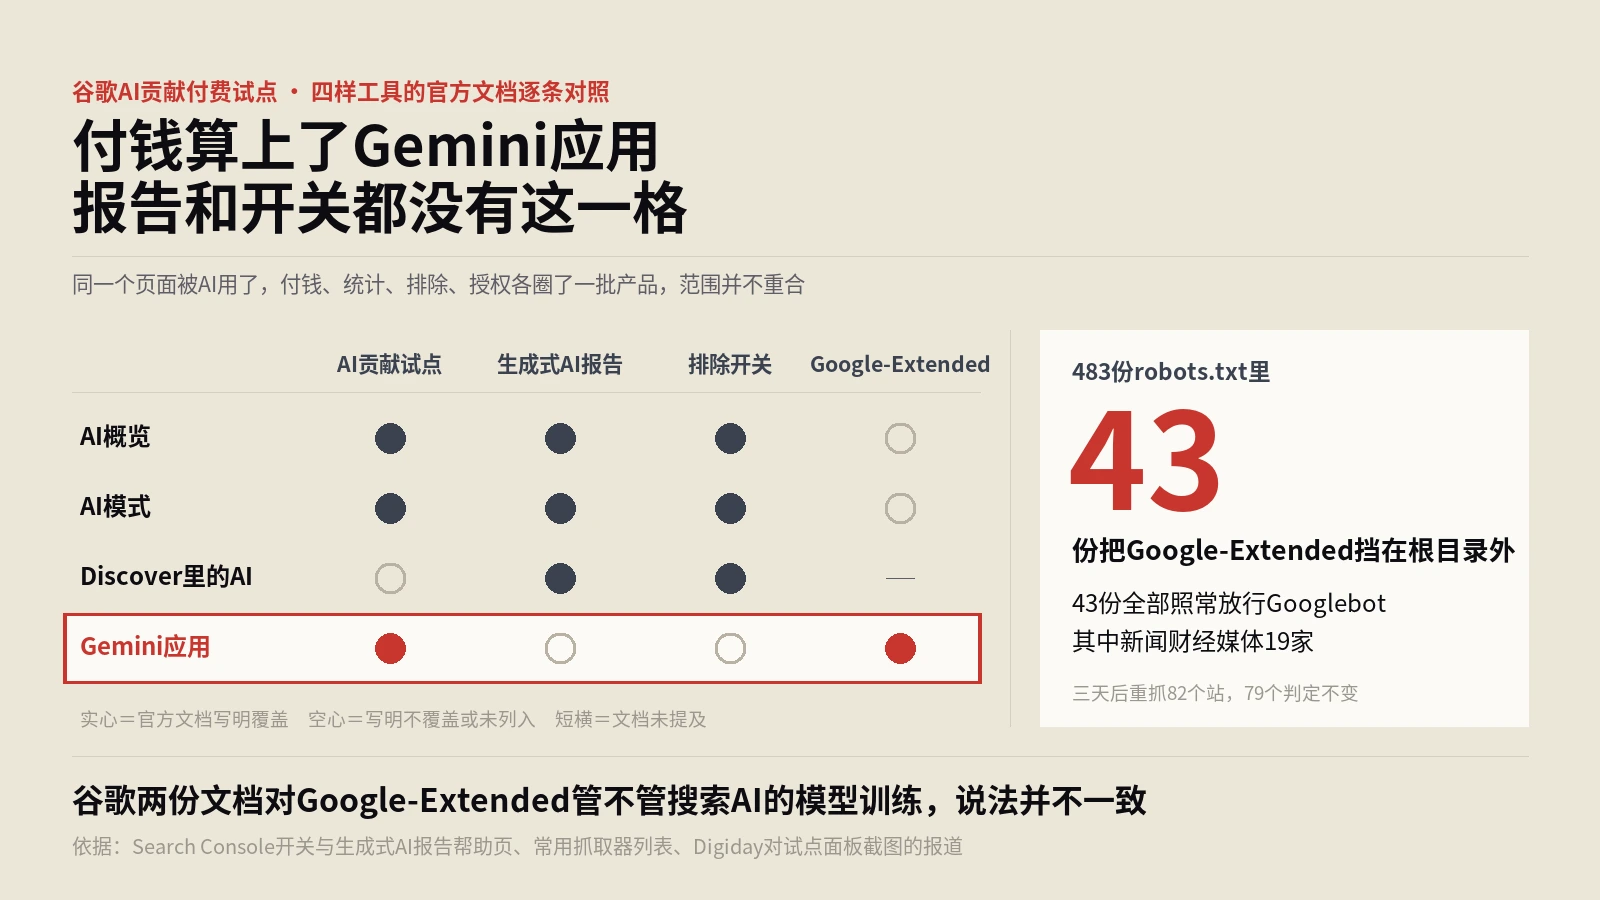
做法:把Search Console生成式AI开关、生成式AI效果报告、Google-Extended令牌与AI贡献试点四样工具的官方文档逐条对照,按产品列出各自覆盖范围;再解析483份robots.txt统计谁挡了Google-Extended,并在三天后重抓82个站复核判定。
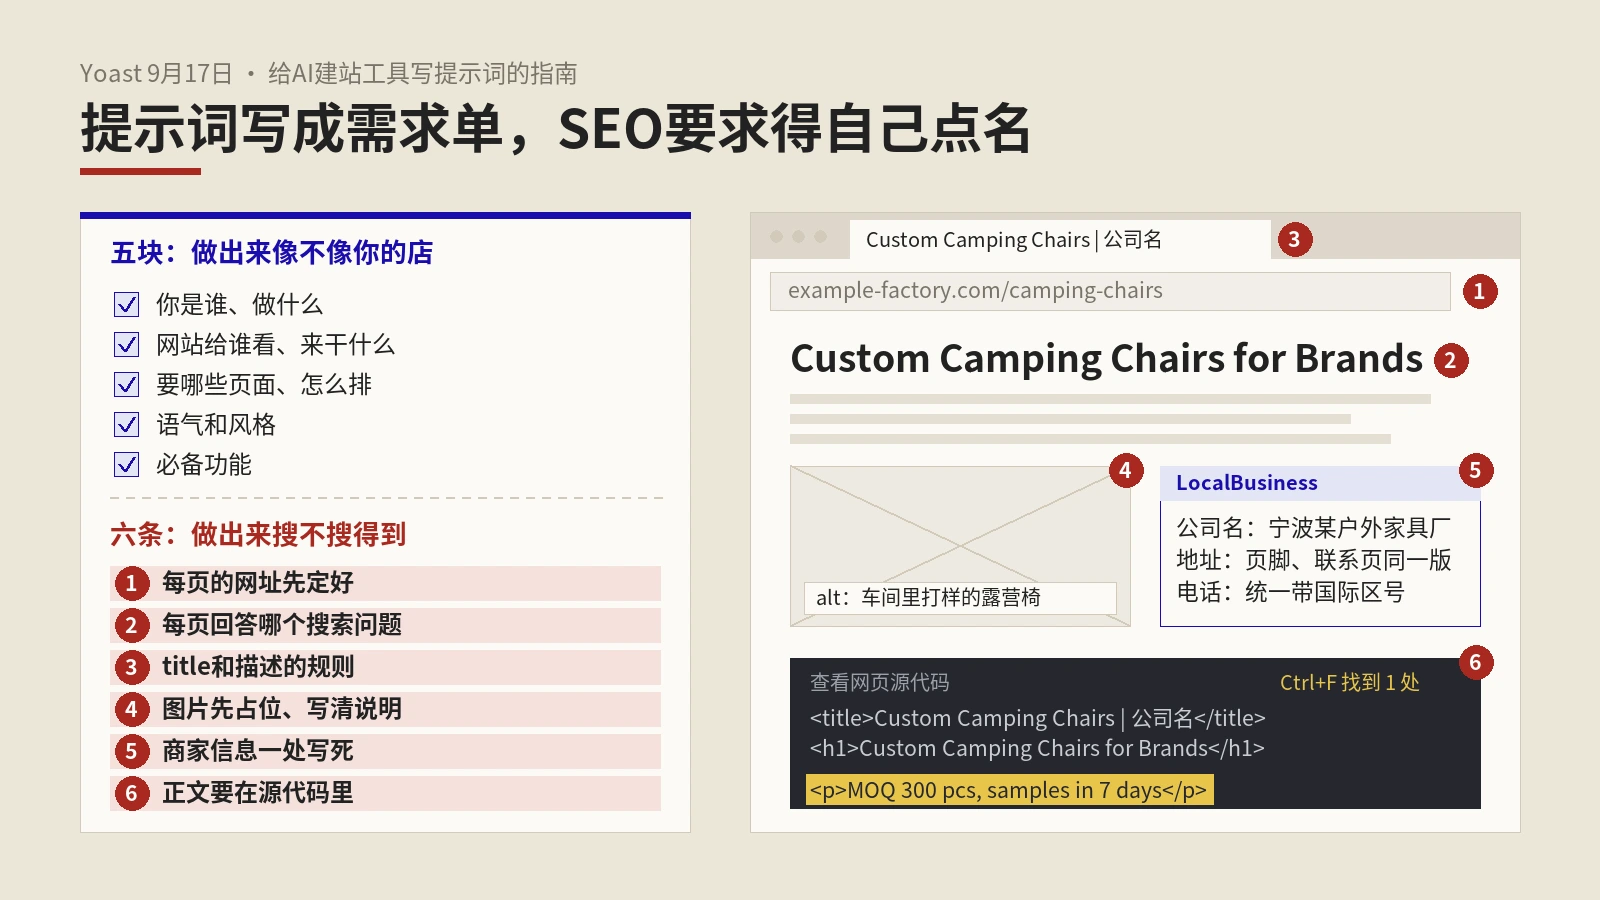
以Yoast 9月17日的AI建站提示词指南为主体,整理业务、访客、页面结构、语气、功能五块写法和五组强弱提示词对比,补上网址、每页搜索问题、标题描述规则、图片说明、商家信息结构化数据、可抓取性六条SEO要求,附两份外贸站提示词和上线前核对表。
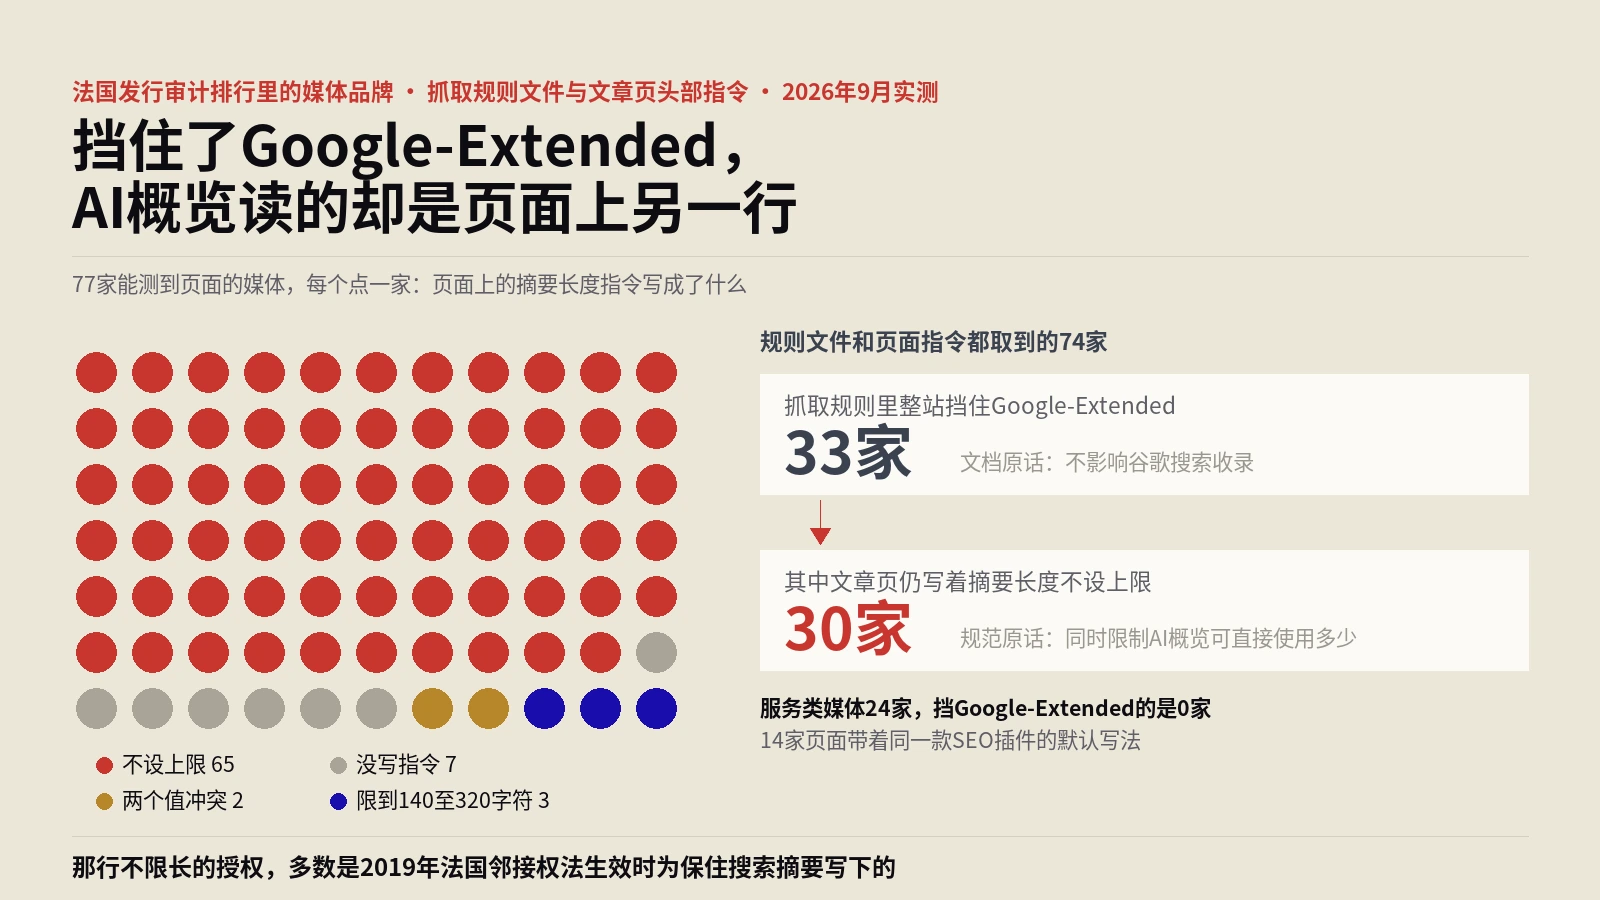
核对办法:从法国发行审计机构八月数字品牌排行里挑出98个媒体品牌,逐家取回抓取规则文件与文章页头部的摘要指令,被防护挡住的用真浏览器补抓;再对照谷歌指令规范、爬虫文档、新闻授权计划说明与2019年法国预览政策,判断每条设置实际管到哪里。
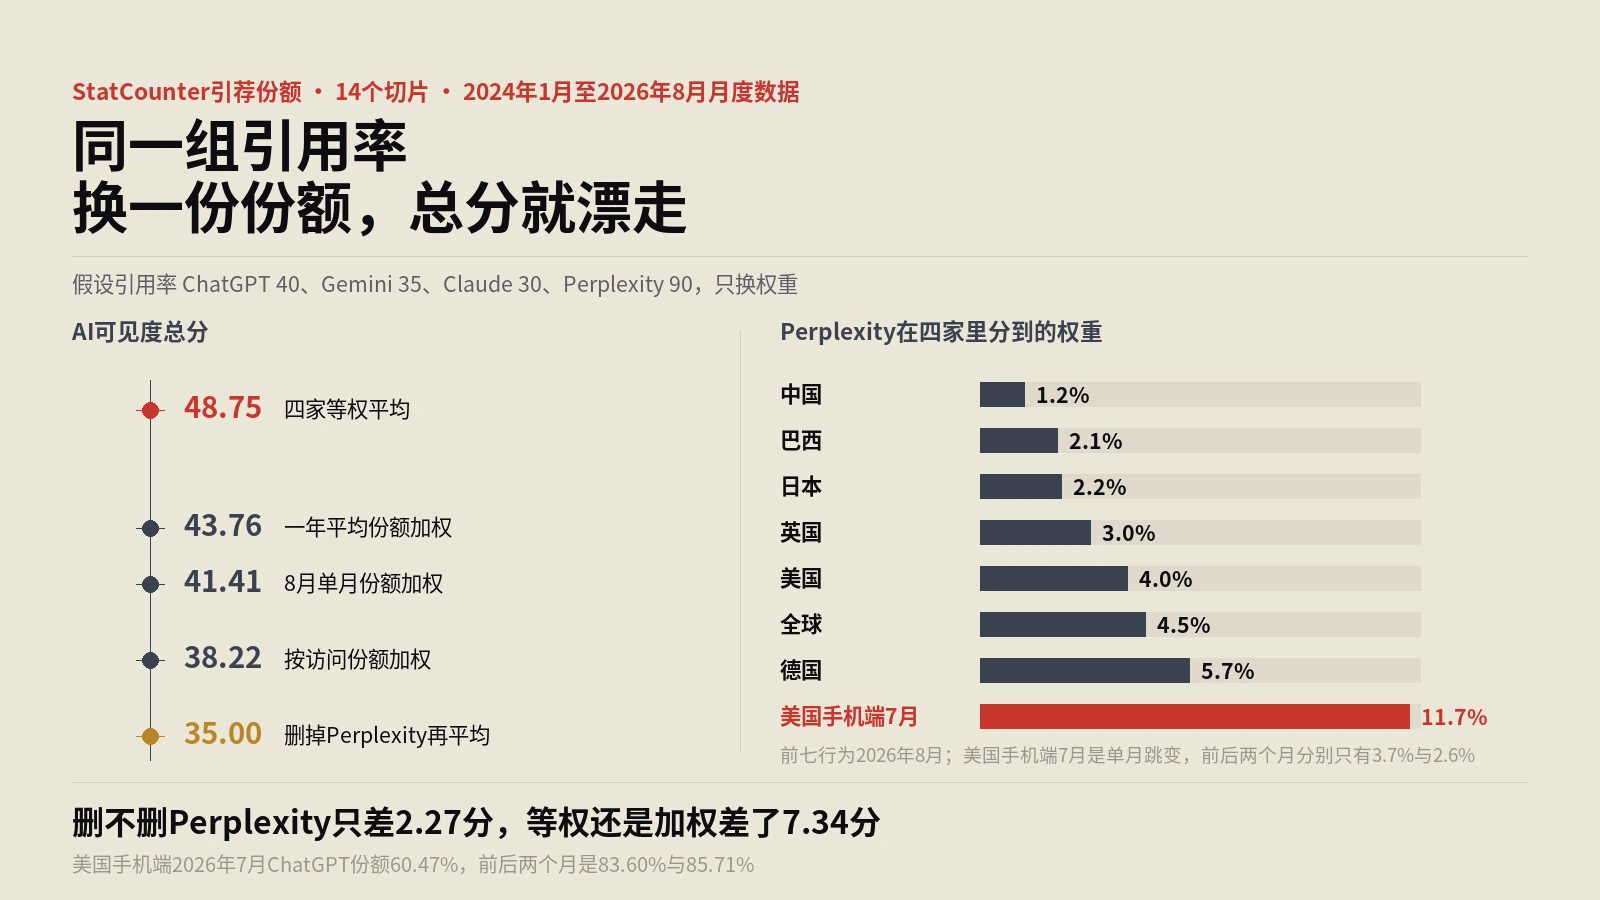
测法:固定一组假设的四平台引用率不动,只换权重。权重分别取自StatCounter引荐份额的全球、10个国家与桌面手机共14个切片、单月与三个月和一年平均,以及Similarweb的网页访问份额,逐一重算总分,再对照份额数据的修订、列顺序变化与异常跳变。
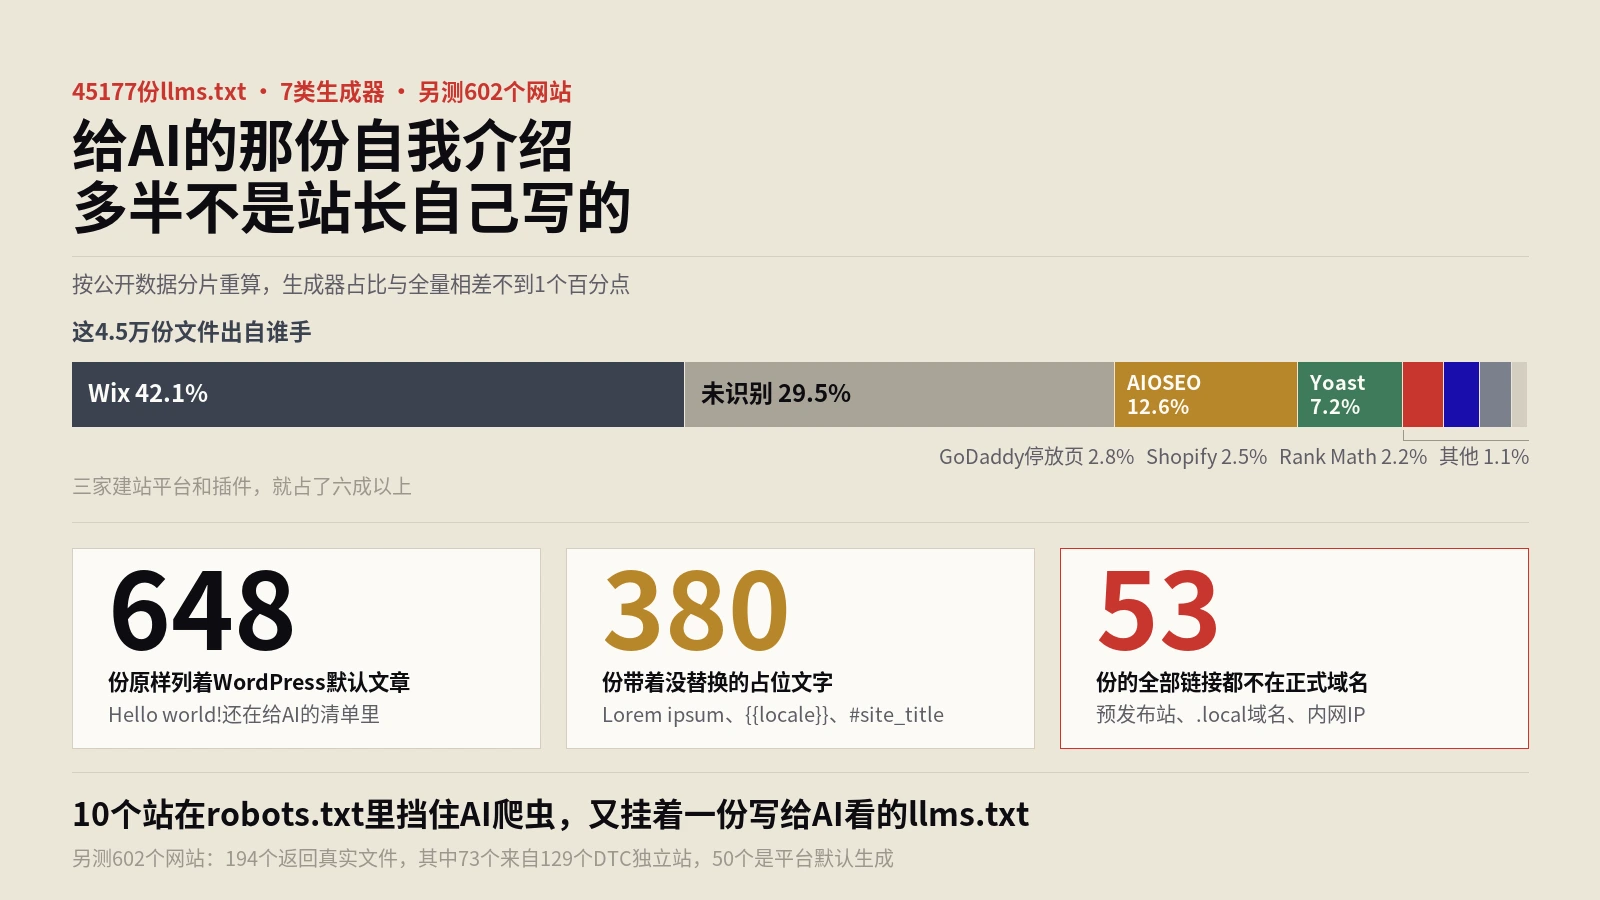
做法:下载Common Crawl公开的llms.txt数据分片,按署名与结构骨架识别生成器,逐份检查默认示例文章、未替换占位符、链接主机是否为预发布或本地地址、政策性语句;另抓602个网站的llms.txt与robots.txt逐条对照,并对抽样链接做两轮存活复测。
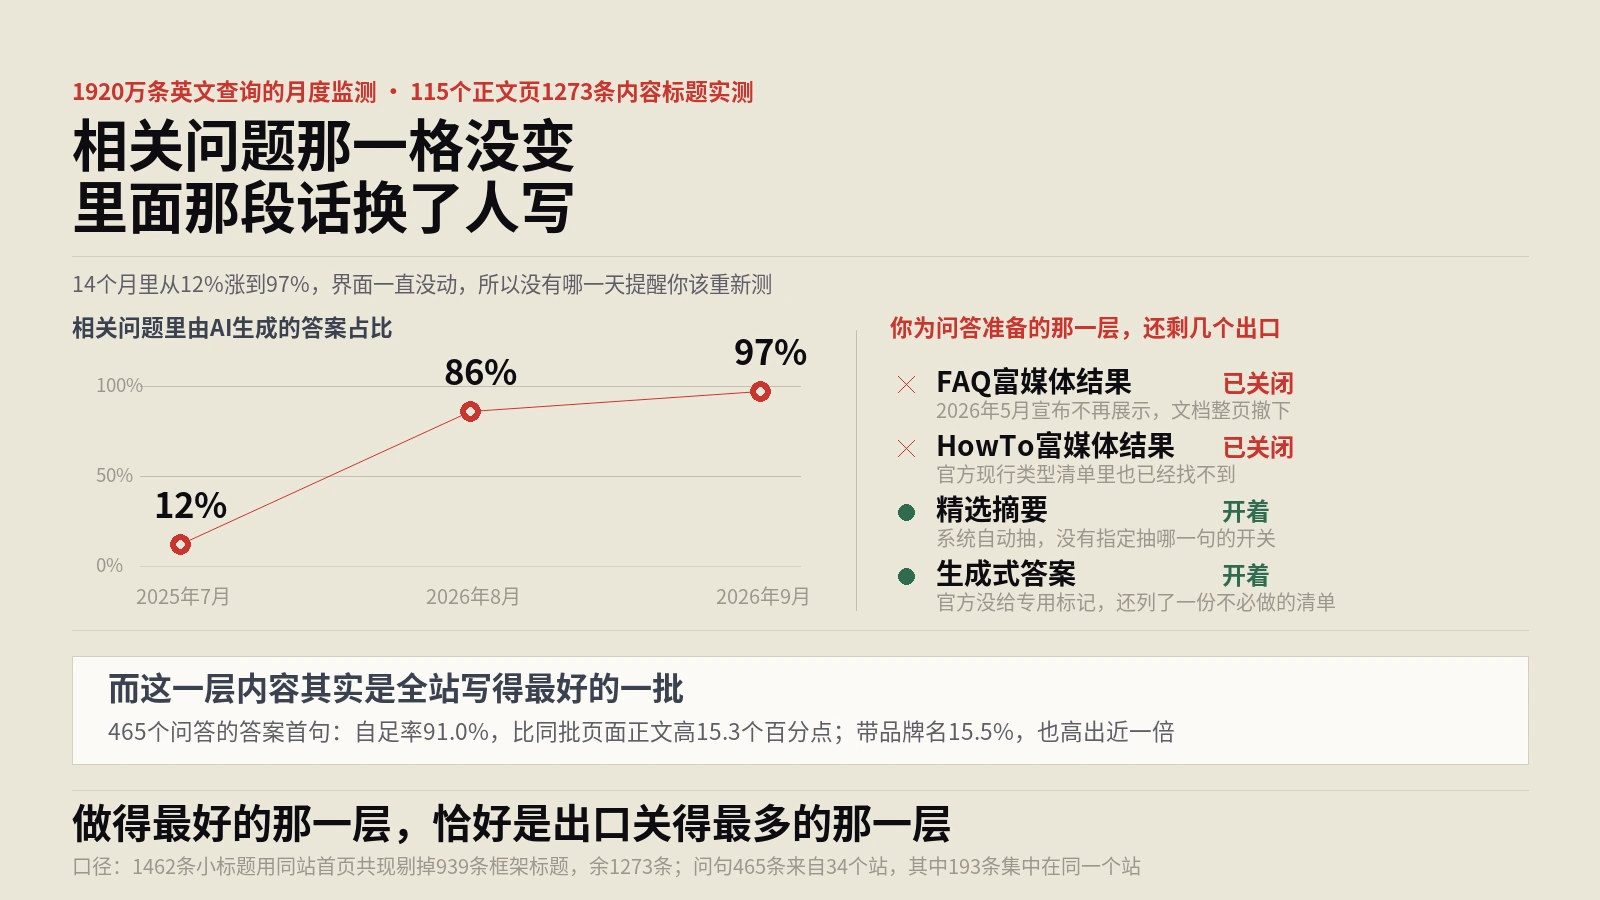
两条线一起走:一条查官方口径,把FAQ富媒体下架、类型清单变动、精选摘要与生成式指南逐页核过;另一条自己量,从115个英文正文页抽出1462条小标题,用同站首页共现剔掉939条框架标题,再按问号与疑问词识别问句,逐条往后找答案段并判定形态。
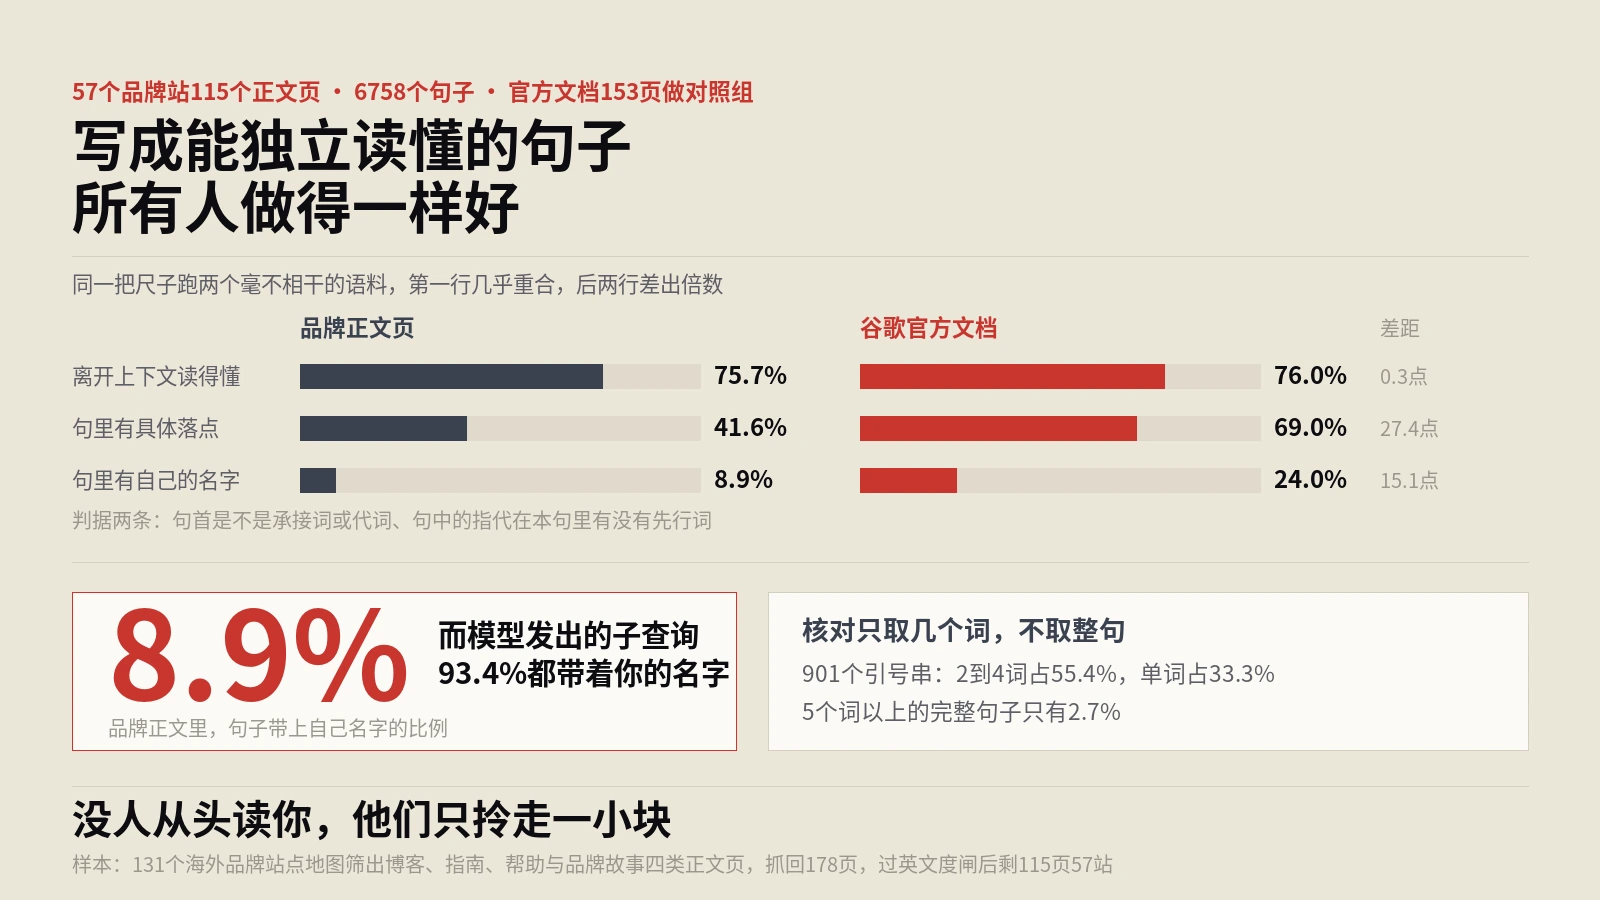
测法写清楚了好复现:从131个站的站点地图筛出博客、指南、帮助与品牌故事四类正文页,低并发抓回178页,先过一道英文度闸剔掉非英文页,再剔掉跨页样板句,最后按句首承接、悬空指代、具名落点、品牌落款四条规则逐句判定,并用谷歌官方文档的153个页面跑同一把尺子做对照。
先拆三个数各自的被测量与对照:日页面浏览、全语种人类页面浏览同比、英文版月度外部搜索引荐。再用维基媒体公开接口拉五个语言版本三年的月度数据自己复算,含机器人重分类窗口的识别方法、爬虫与自动化程序两条序列的分开读法,末尾给出四步可照搬的自测口径。

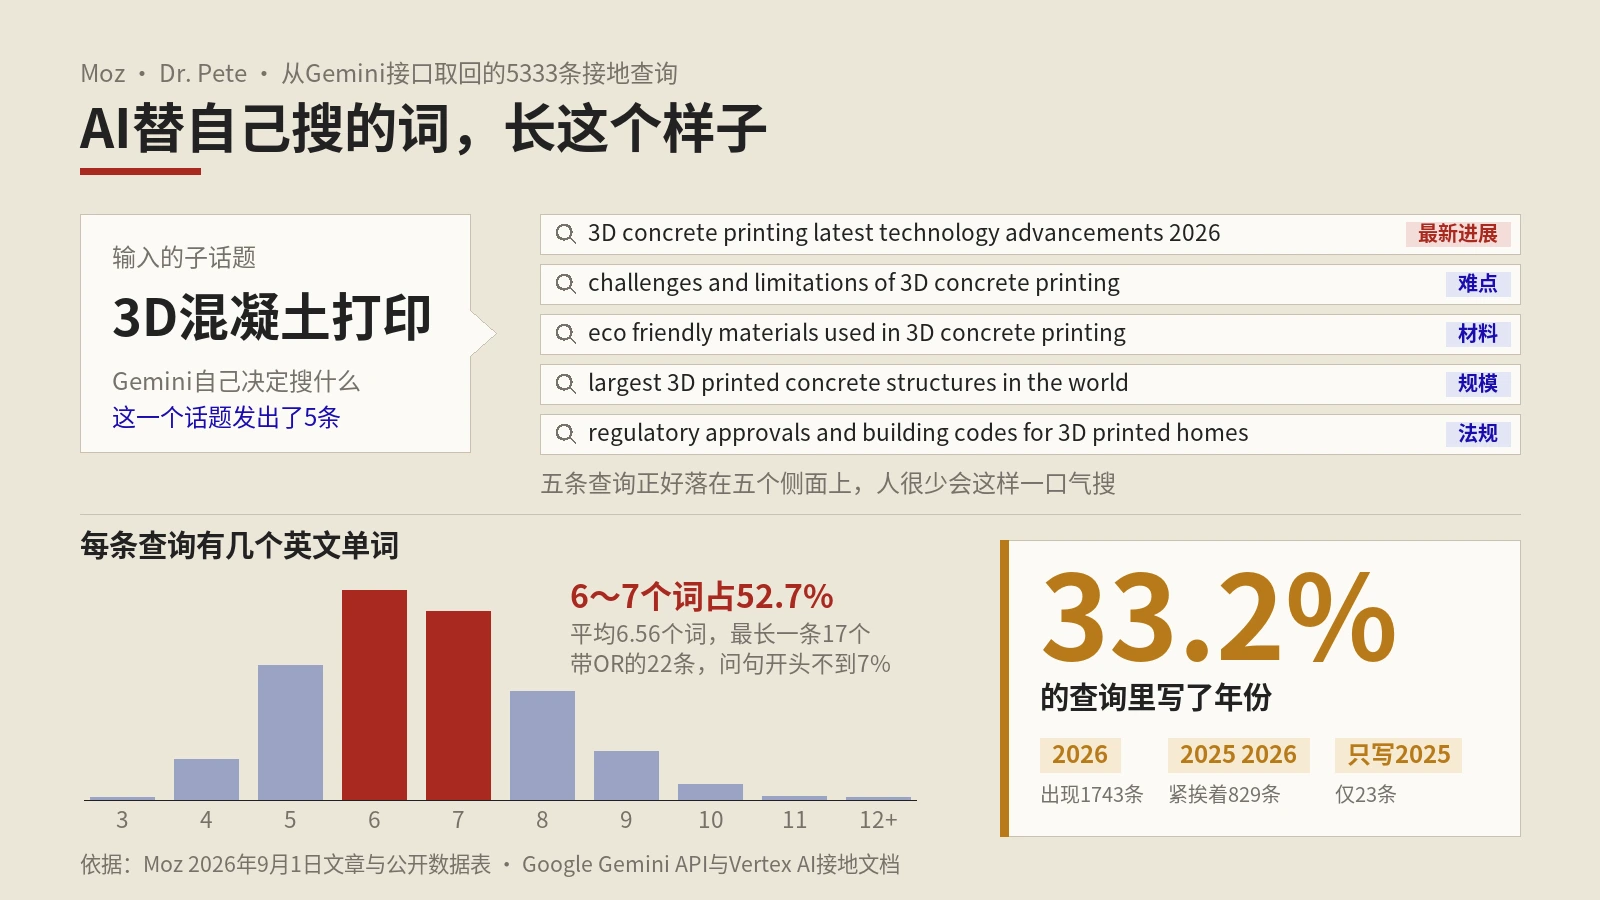
以Moz的Dr. Pete文章和他公开的数据表为主体,重算查询长度分布、年份写法和高频侧面词,对照Vertex AI文档里groundingMetadata的四个字段与搜索建议展示规定,比较Gemini 3按查询和Gemini 2.5按提示两种计费,并给出外贸站按侧面补内容的五步用法。
做法是只抓首页一次,把结构化数据里的sameAs、页面上的社交链接和twitter:site三份一起取出来就地比对,先归一到平台粒度再逐个对账号,全程不去社交平台验活。平台判定表里一条写法把整个google.com都吞了进去,凭空造出八个站的Google+残留,修完只剩一个。
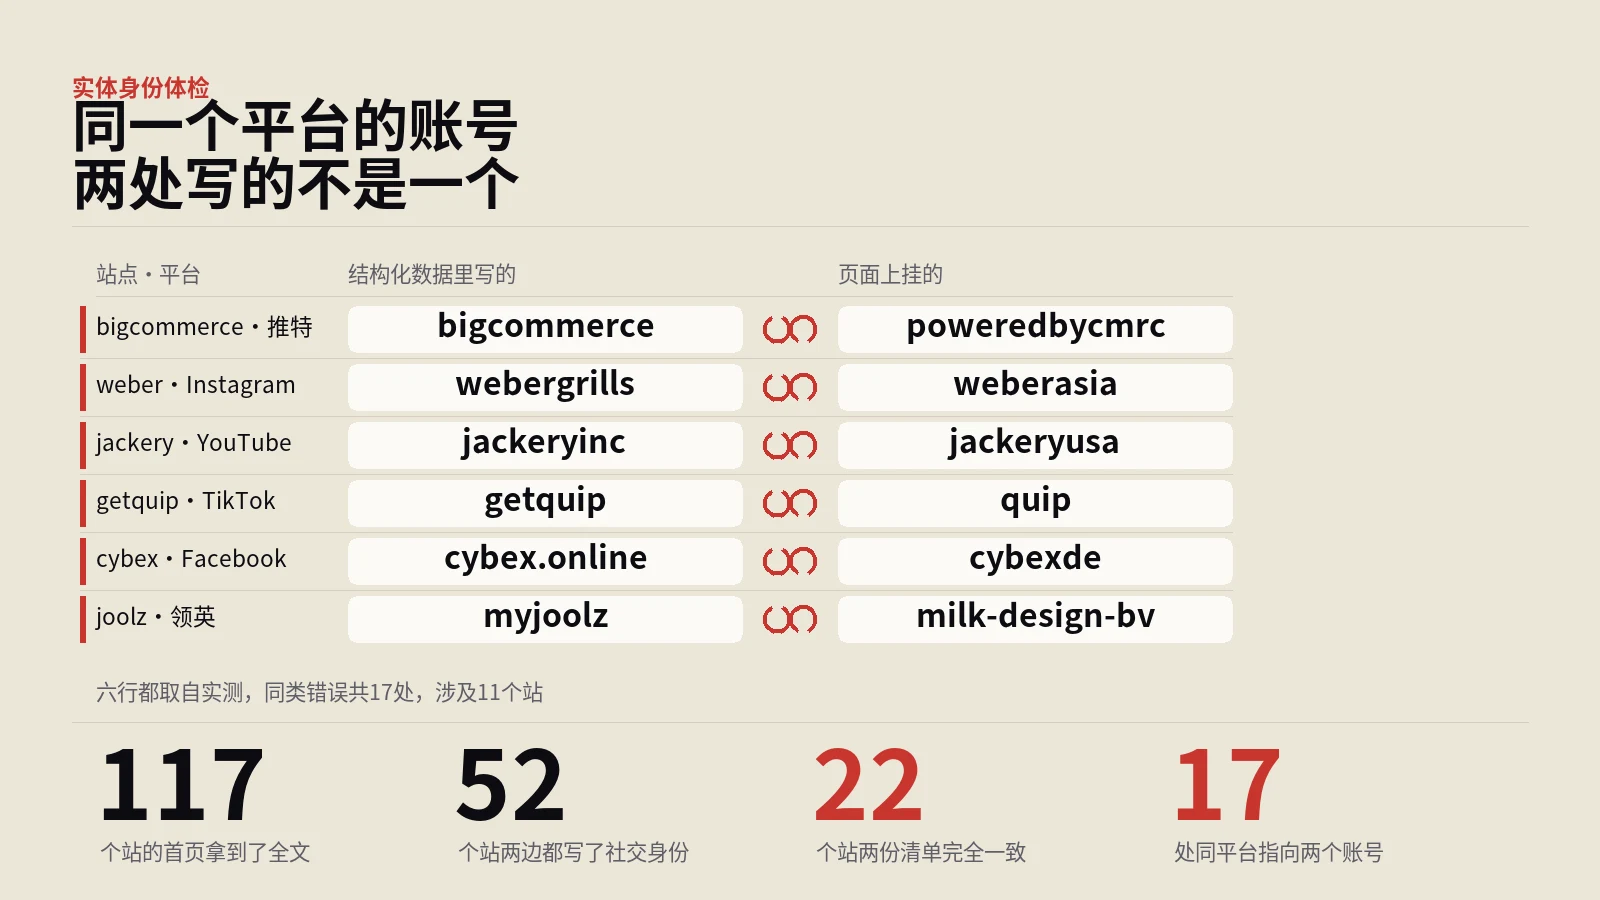
要判断一段内容的来源能不能被核实,有一套可以照着跑的量法。先把目标站的首页抓下来存成文件,从中取出机器可读的结构化数据块,把代表组织的那个实体找出来;然后逐字段清点有无,把字段按外人能不能独立查证排成一列——名称和描述属于纯自述,网址和标志一点就知道,关联主页要去对面看,法定名称和税号能在登记处查;最后画出填写率随可核验度变化的那条线,看它在哪一档出现断崖。整套逻辑不到两百行,唯一要留神的是结构化数据的嵌套解析,只在顶层找会漏掉一大半样…

读这两条线要按顺序来:先确认自己的品牌名在英语词表里是什么,再决定这两个数该打几折,最后才谈怎么用。跳过第一步,后面所有解读都建立在一个不知道大小的偏移量上。文中把这套顺序在169个DTC品牌名上跑了一遍,给出四个口径的分档结果、一张五列的品牌名附注表,以及一个三十分钟就能做完的手工对照测量。

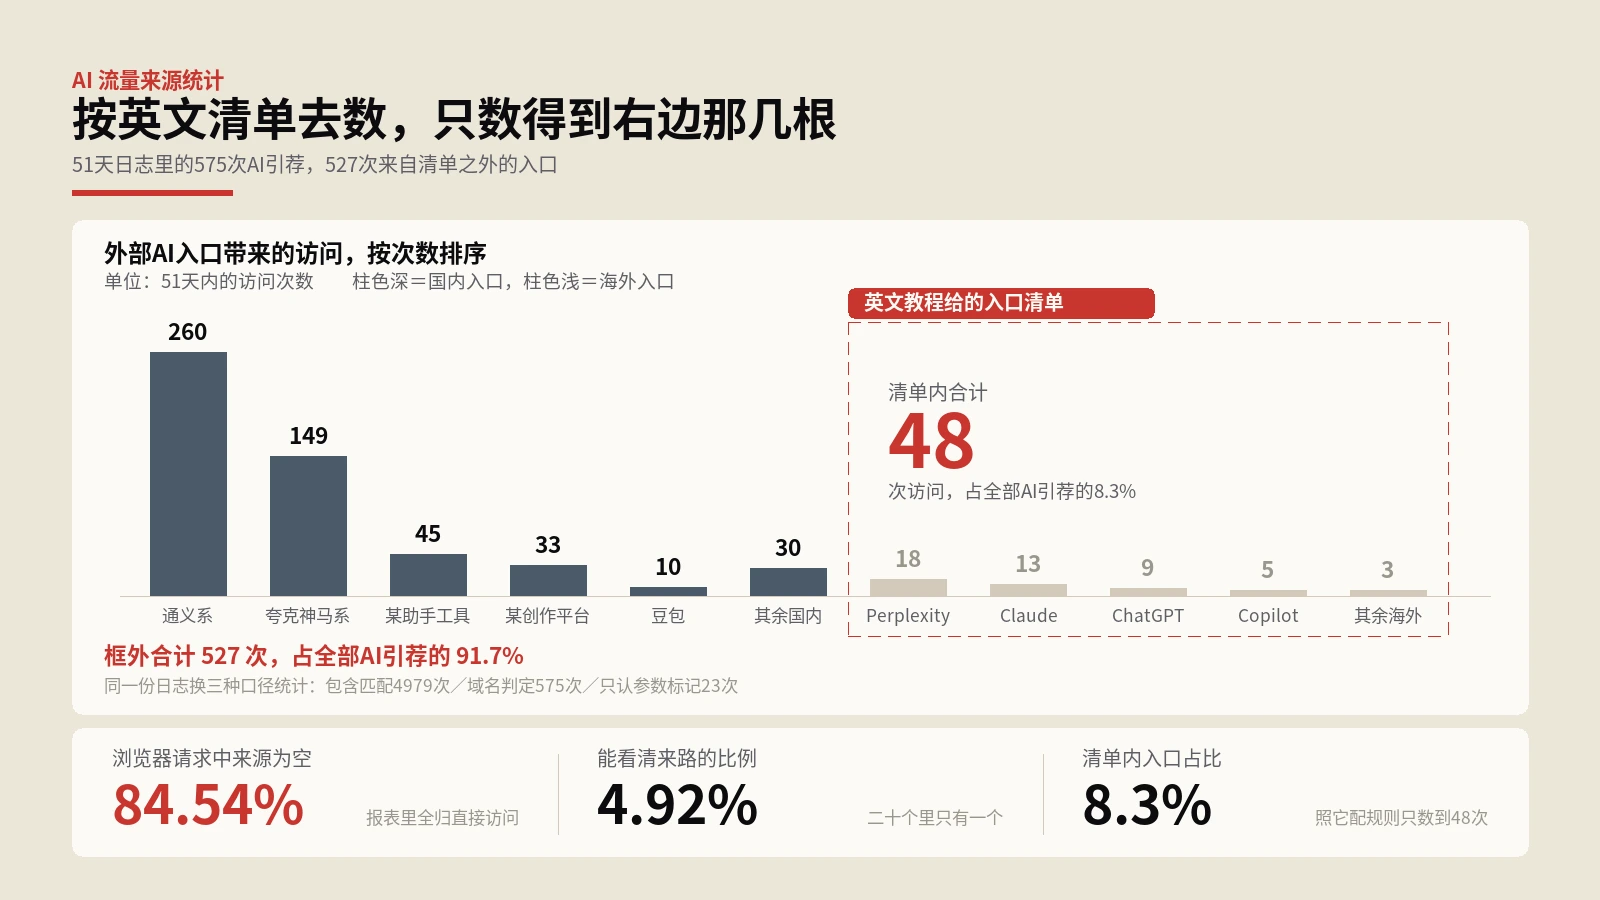
浏览器请求里有84.54%的来源字段是空的。在剩下能看清来路的那部分里,AI入口带来575次访问,其中527次来自国内产品。同一份日志换三种口径统计,会得到4979、575、23三个数字,本文把口径差异、六类常见坑,以及一套不依赖技术链路的补救办法一并给出。