广告系列自动升级9月1日生效,文案原料全在落地页上
9月1日起用了自动创建资产的搜索广告系列会被自动迁移,不操作即默认同意。既然文案由平台从落地页现抓,就该先看它能抓到什么。66个站的实测:25个没有主标题标签,52个的标题是模板拼的;70份爬虫规则文件里27份抹掉店铺编号后一字不差。

9月1日起用了自动创建资产的搜索广告系列会被自动迁移,不操作即默认同意。既然文案由平台从落地页现抓,就该先看它能抓到什么。66个站的实测:25个没有主标题标签,52个的标题是模板拼的;70份爬虫规则文件里27份抹掉店铺编号后一字不差。
这一页在多数公司里没有主人:不属于内容团队,不属于设计团队,也不出现在任何一份优化清单上。可它正在接住一批意图最明确的访客。本文给出三十秒判断自己属于哪一类的方法,四个按性价比排序的改动,以及一个团队用四天半跑完这套改造的完整账。
把95个DTC品牌的发信配置查了一遍:93个有SPF记录,7个展开后已经超过规范的10次上限,6个正好卡在10。最短的一条记录只有39字节、一个引用都没写,展开出来正好10次。文中给出各家发信服务的真实查询成本、四种记录形态的对照,以及一份接新工具前必过的四行检查卡。

内容安全策略的覆盖率是个骗人的指标。87个DTC与电商站的购物车页里,56个拿到真页面,47个带了这条响应头,但其中42条的长度落在49到175字节之间、内容一字不差,真正约束脚本来源的只有5个。文中给出长度分布、第三方脚本清单、完整性校验的真实归属,以及一份两小时能做出来的脚本基线。

谷歌把自己的抓取客户端分成三份清单,其中特例爬虫那一份里,AdsBot-Google、AdsBot-Google-Mobile、Mediapartners-Google和APIs-Google四条下面写着同一句话:全局用户代理会被忽略;Google-Safety更彻底,完全不看robots.txt。这意味着你那行星号覆盖的范围小于你以为的范围,而覆盖之外那几个恰好后果最直接。本文把日志里的用户代理与robots.txt里的令牌这两套字典…

浏览器请求里有84.54%的来源字段是空的。在剩下能看清来路的那部分里,AI入口带来575次访问,其中527次来自国内产品。同一份日志换三种口径统计,会得到4979、575、23三个数字,本文把口径差异、六类常见坑,以及一套不依赖技术链路的补救办法一并给出。
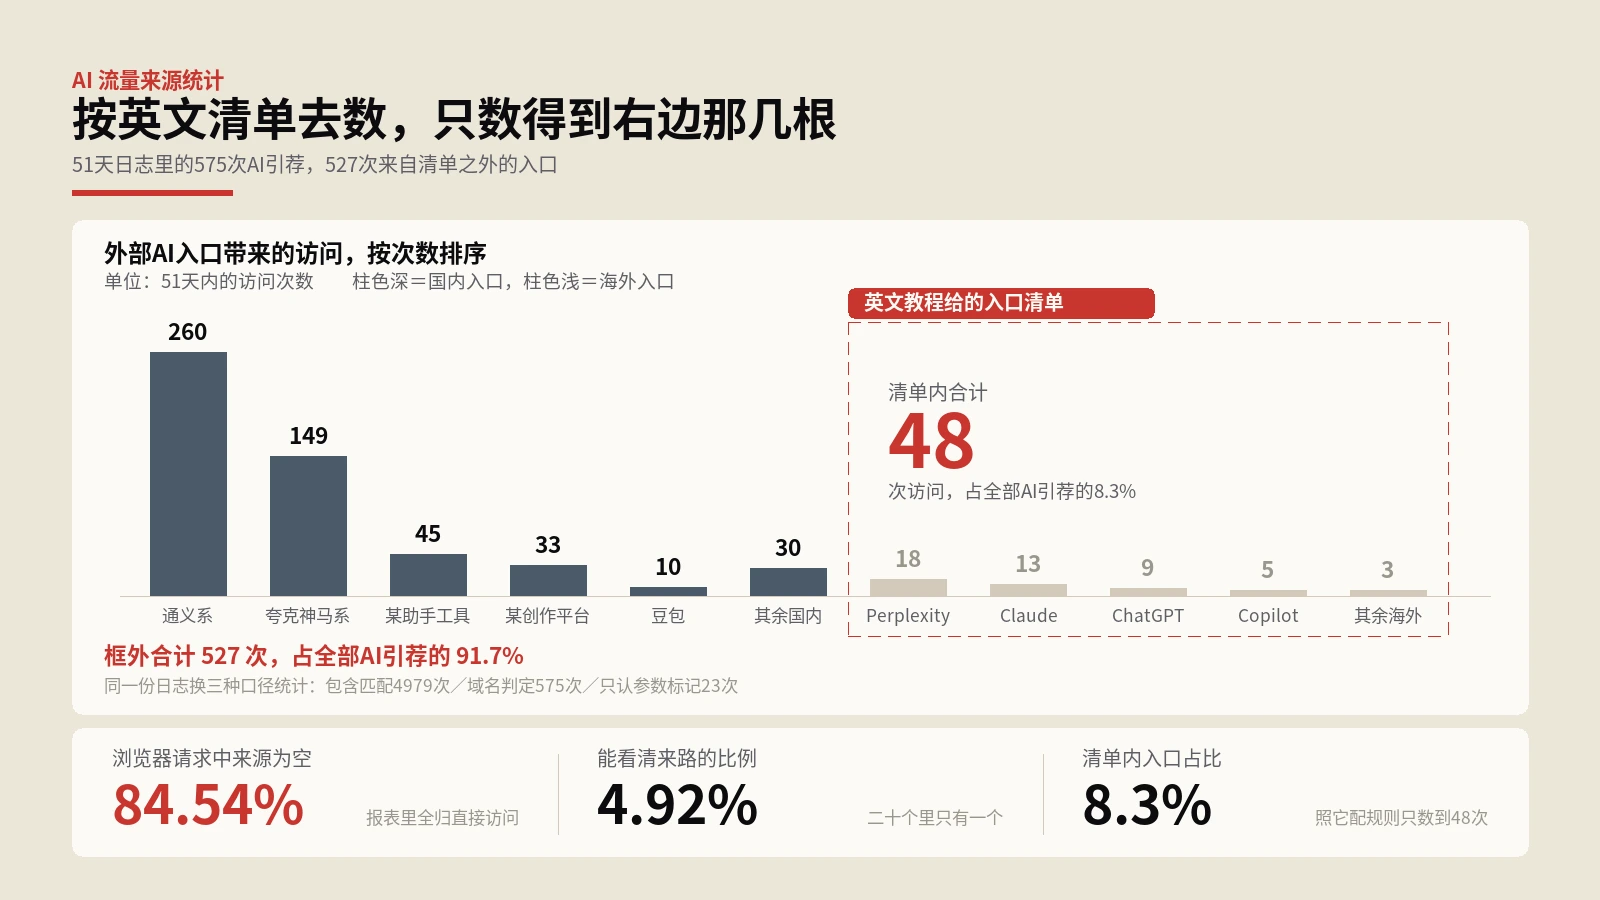
四条被反复引用的效果证据,在做法完全无效的时候也照样成立。本文用51天、230万条访问日志做了一次对照实验,把robots.txt当作已知被使用的参照,量出AI客户端对llms.txt的真实请求只有17次,并给出对照组的七步流程与一条能长期挂在站上的地板线。

Gmail从2024年2月起把退订拆成了两个互不相干的层:信头里的List-Unsubscribe与List-Unsubscribe-Post,以及正文里那个清晰可见的链接,官方原文用的是并列句,不是二选一。本文把这两层的失效方式逐条摆开:正文那层要经过HTML解析、样式应用、图片加载、暗色模式反色、屏幕适配这五个环节,任何一个出岔子链接就消失;信头那层零环节,唯一的失效方式是你没写。而找不到退订入口的人不会放弃,他会去点举报垃圾邮件,…

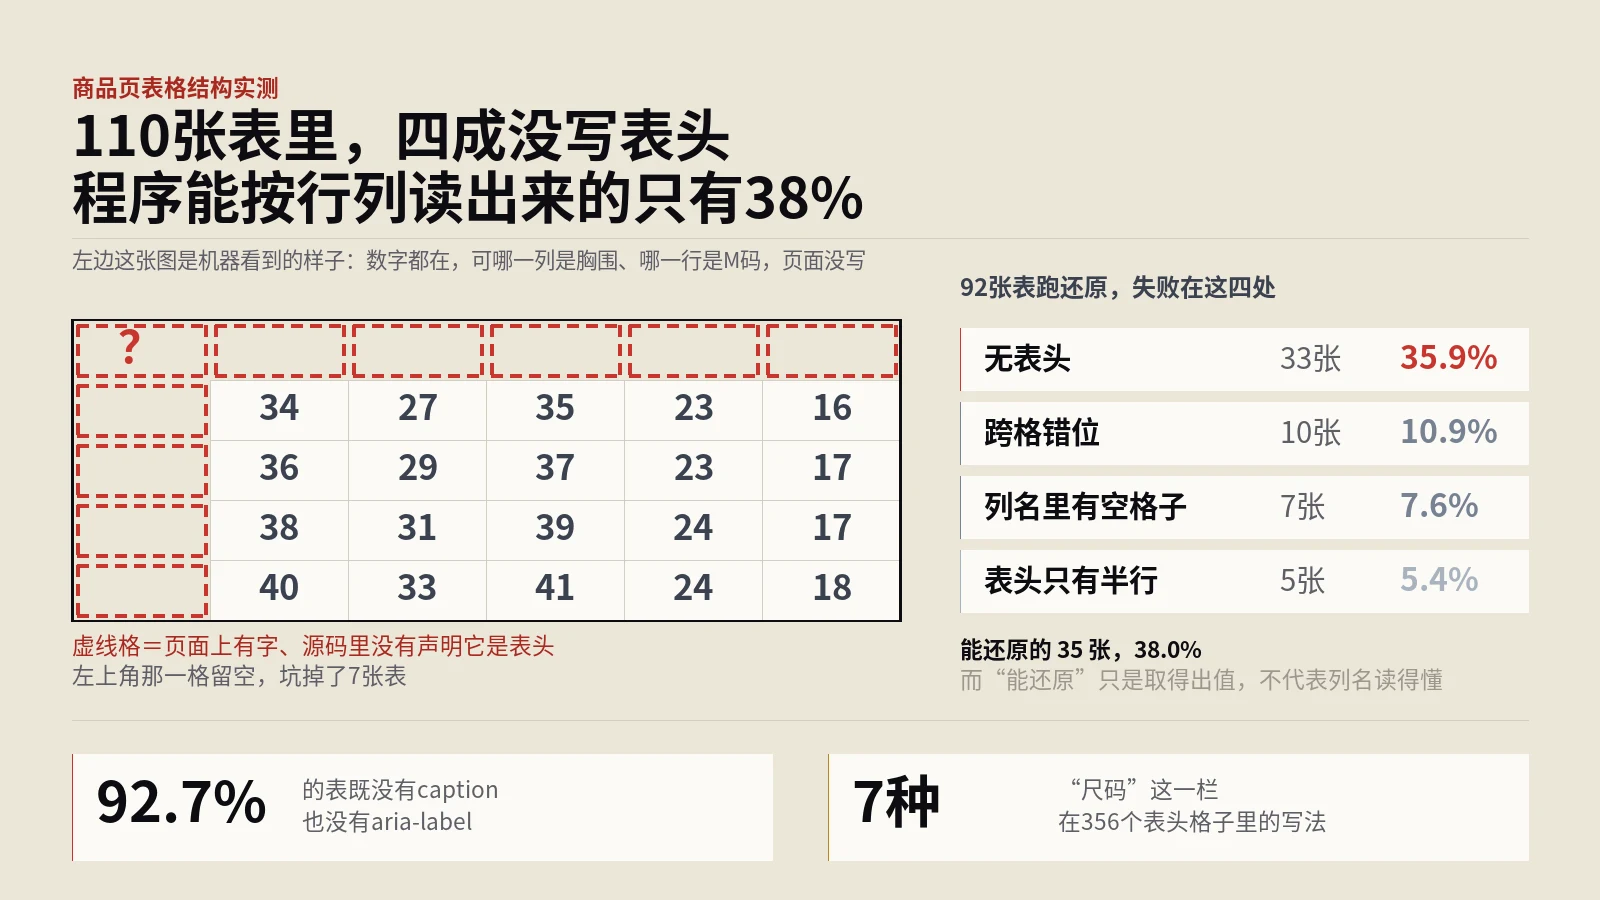
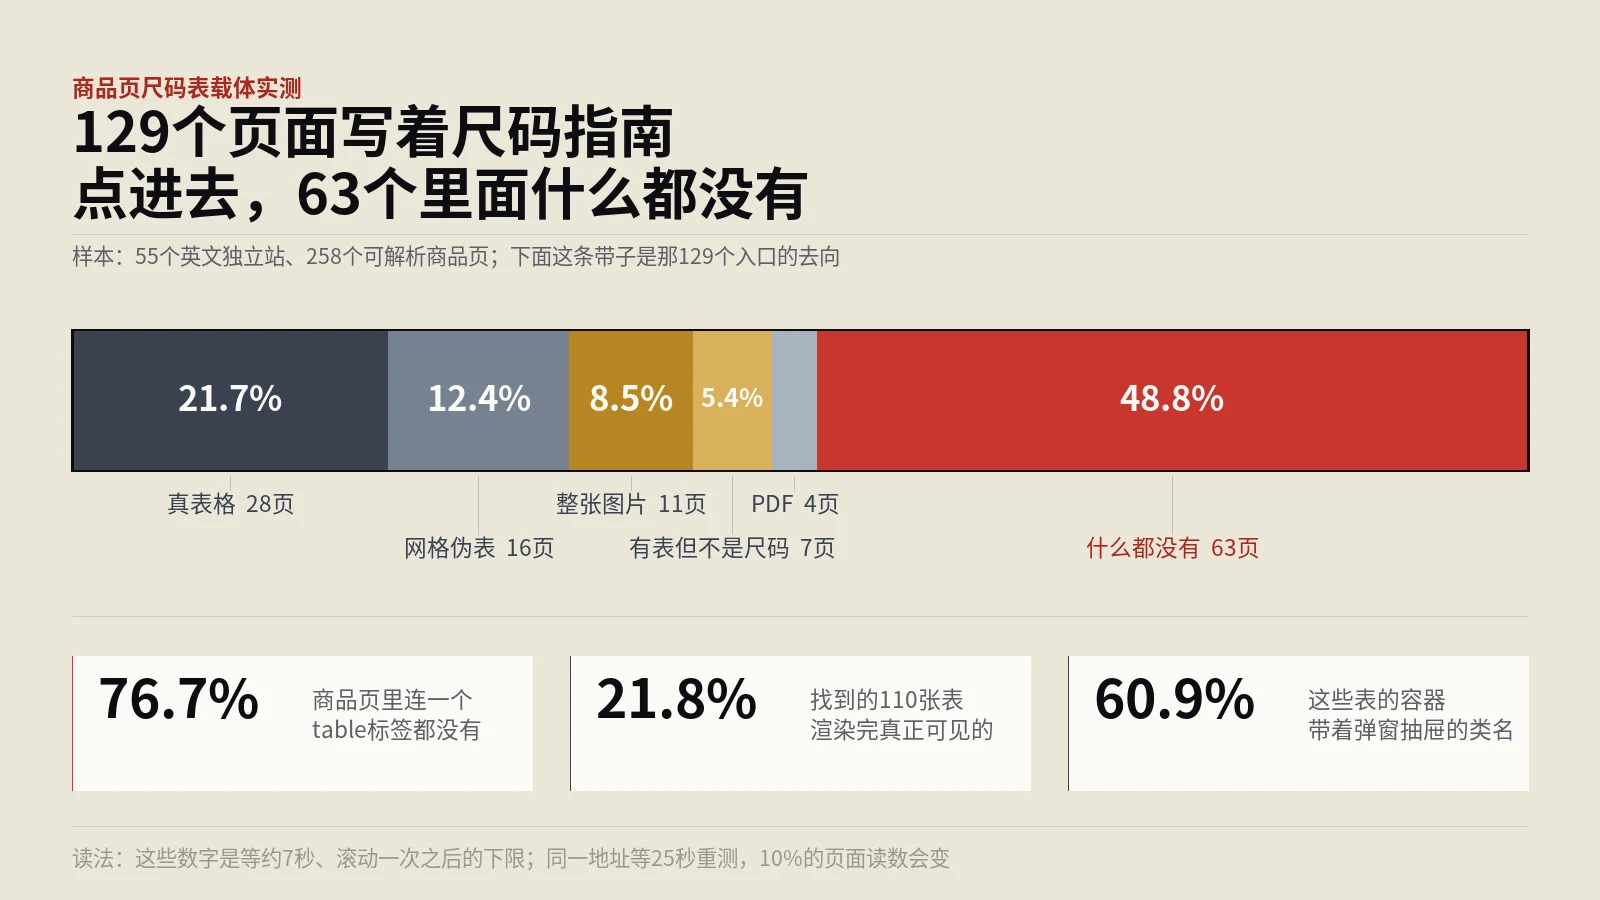
做法是把每张表最多20行12列的单元格连同标签类型一起原样取下来,再写一段还原程序按四条判据逐张试:首行是不是全部为表头单元格、有没有跨行跨列、各行格子数是否一致、列名是不是既非空也非纯数字,任何一条不满足就归进对应的失败类型。单位不从采集端的正则读,改成从表格矩阵离线重算,因为括号写法那种形式会被常规正则整批漏掉。格子总数不超过两个的空壳表单独摘出,不进还原成功率的分母。
给响应头做一次接收端体检的完整量法:先取两次响应头做差集分清每个字段是自己加的还是平台加的,再逐个查它在规范里的状态与浏览器实现状态,接着先补新版写法再按确定性分三批删除,最后把结论同步给做安全审计的人。含142个站逐字段实测与一张判断结果对照表。

本文讲一类没有责任人的失真:内容在生产过程中换了谁在做,而成品上完全看不出来。一家精品茶具与原产地茶叶跨境独立站的产品描述里写着“海拔1200米古树”,被买家一查,那个产区最高的茶园只有800多米;三百多个SKU清查下来,描述中含无法追溯的具体数字、地名、人名或年份的有176个,其中37个明显不合常理。可整条链上没有一个人做出过编造这个决定——写文案的只说了句写得生动一点,客服只说了句回得专业一点,而这两句在工具那里都是不带边界的授权。…

实验台用真实浏览器逐页打开55个英文独立站的商品页,等渲染完成并滚动一次之后,同时清点五类可能承载尺码信息的东西:真表格、计算样式为网格的伪表、老式CSS表格布局、整张图片形态的对照表,以及定义列表;再单独记录页面上有没有尺码指南这类入口,把入口与内容逐页对上。为了区分“页面没写”和“我没等到”,另挑三十个站做了两组对照:同一个地址等5秒与再等20秒各量一次,以及替用户点开尺码指南之后再量一次。限流与失效的页面逐条记录,没有拿去凑分母。
Googlebot对单个网址只取前2097152个字节,超出的部分不会报错,只是不存在。本文逐字节量了46个真实电商与建站平台的页面:未压缩HTML中位数972274字节、均值1131569字节,4个页面已越过上限,7个用掉八成以上预算,其中lovevery一个组合装页离上限只剩23个字节。更值得看的是受伤程度完全不按超标幅度排:anker两个页面超标最多却一个链接都没丢,allbirds男款分类页只超27.49%,288个链接被切掉9…

本文讲一类所有监控都看不见的故障:页面从服务器发出去之后、落进用户眼睛之前,被中间层改写了内容,而系统层面没有任何异常。一家手工陶瓷餐具跨境独立站的德语版退货率比英语版高6.8个百分点,退货理由里“与描述不符”占41%(英语站只有12%),参数表、图片、尺寸、翻译逐项查过全对,挂了大半年。真相是德语页面的语言标记还写着英语,德国买家的浏览器把它当外语又翻了一遍,参数表里那句“可用于洗碗机”被换成了一个意思更弱的同义说法,而改写后的德语语…

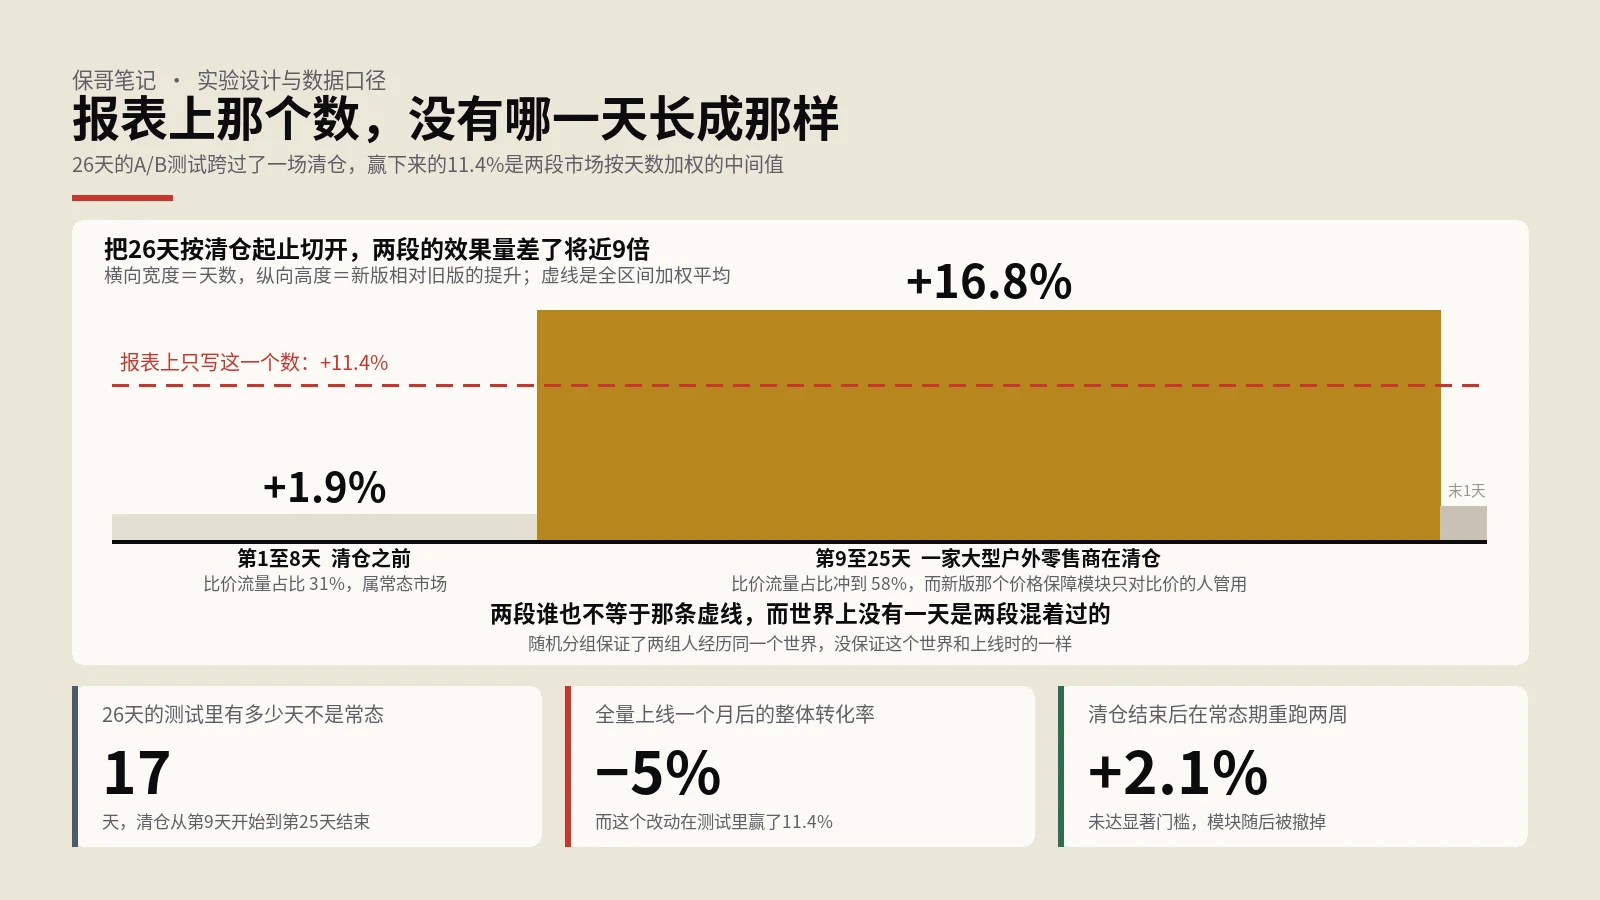
本文讲一类没有名字的实验错误:实验本身完全正确,但它测量的那个世界和你要应用结论的那个世界不是同一个。一家户外帐篷跨境独立站把产品页重做一版,26天的A/B测试新版赢11.4%、p值0.008,全量上线一个月后整体转化率反而低了5%。追下去发现测试的第9到25天有一家大型户外零售商在做年度清仓,比价流量占比从31%冲到58%,而新版多出来的价格保障模块只对正在比价的人有效——按清仓起止把区间切开重算,清仓前那8天只有1.9%,清仓期17…
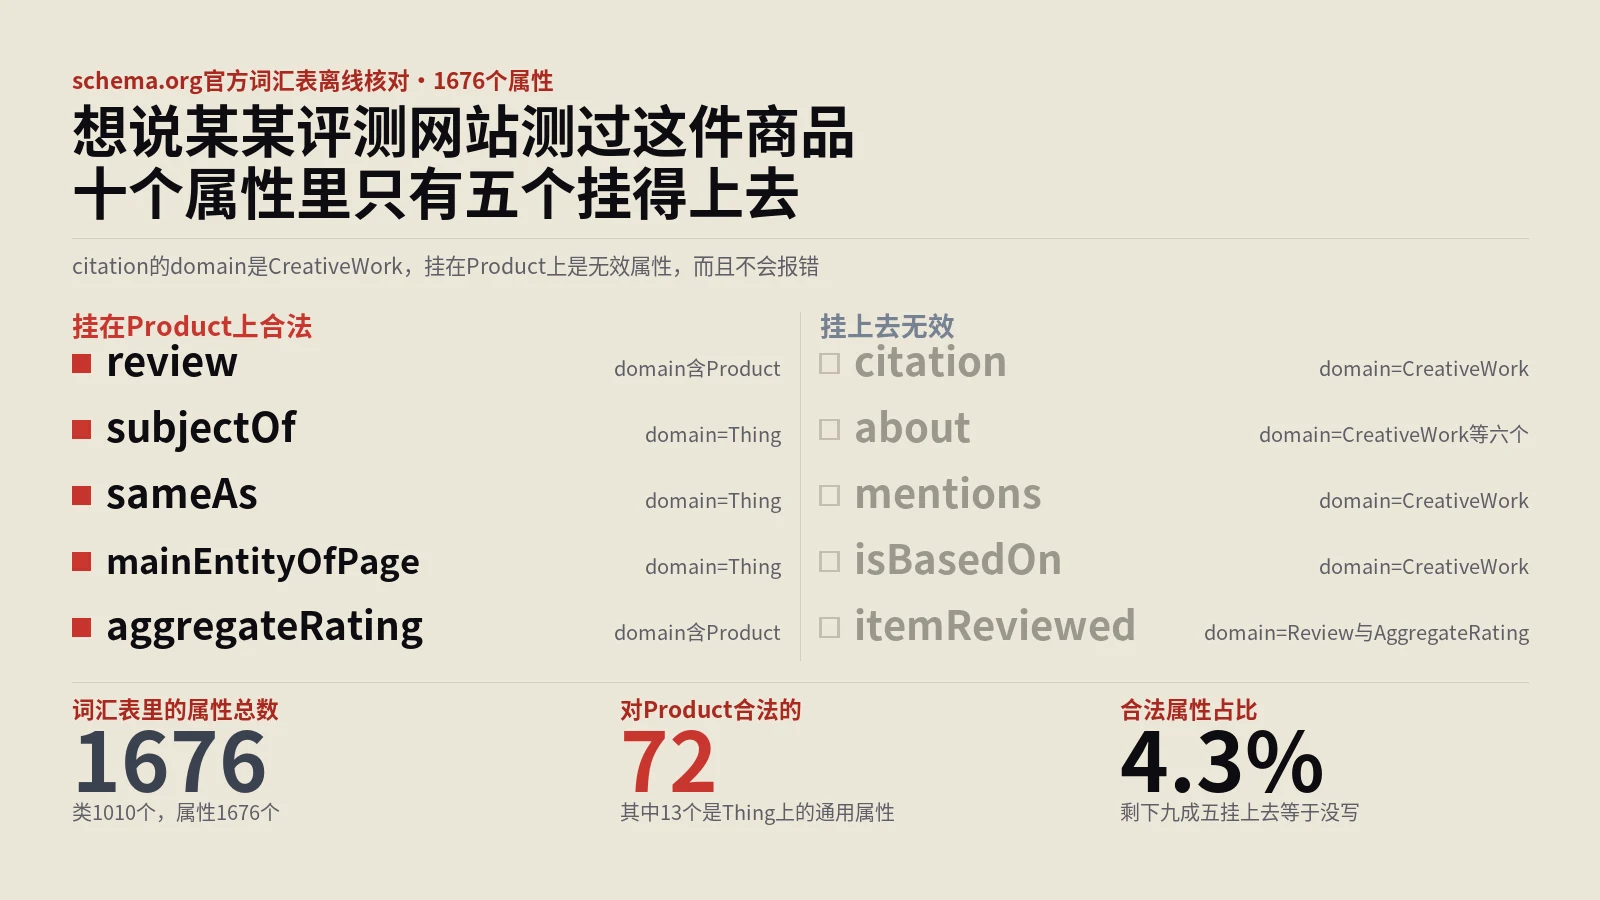
把评测网站的背书写成机器读得懂的关系,正确分工是Product节点上挂subjectOf、WebPage节点上挂citation,Review里再用itemReviewed反指回来把这条边闭合。这篇给出可以直接改的JSON-LD骨架,说明author为什么必须写成Organization、评分为什么绝对不能并进aggregateRating、验证该用schema.org官方验证器而不是富媒体结果测试,最后附一段查属性合法性的代码,自己就…
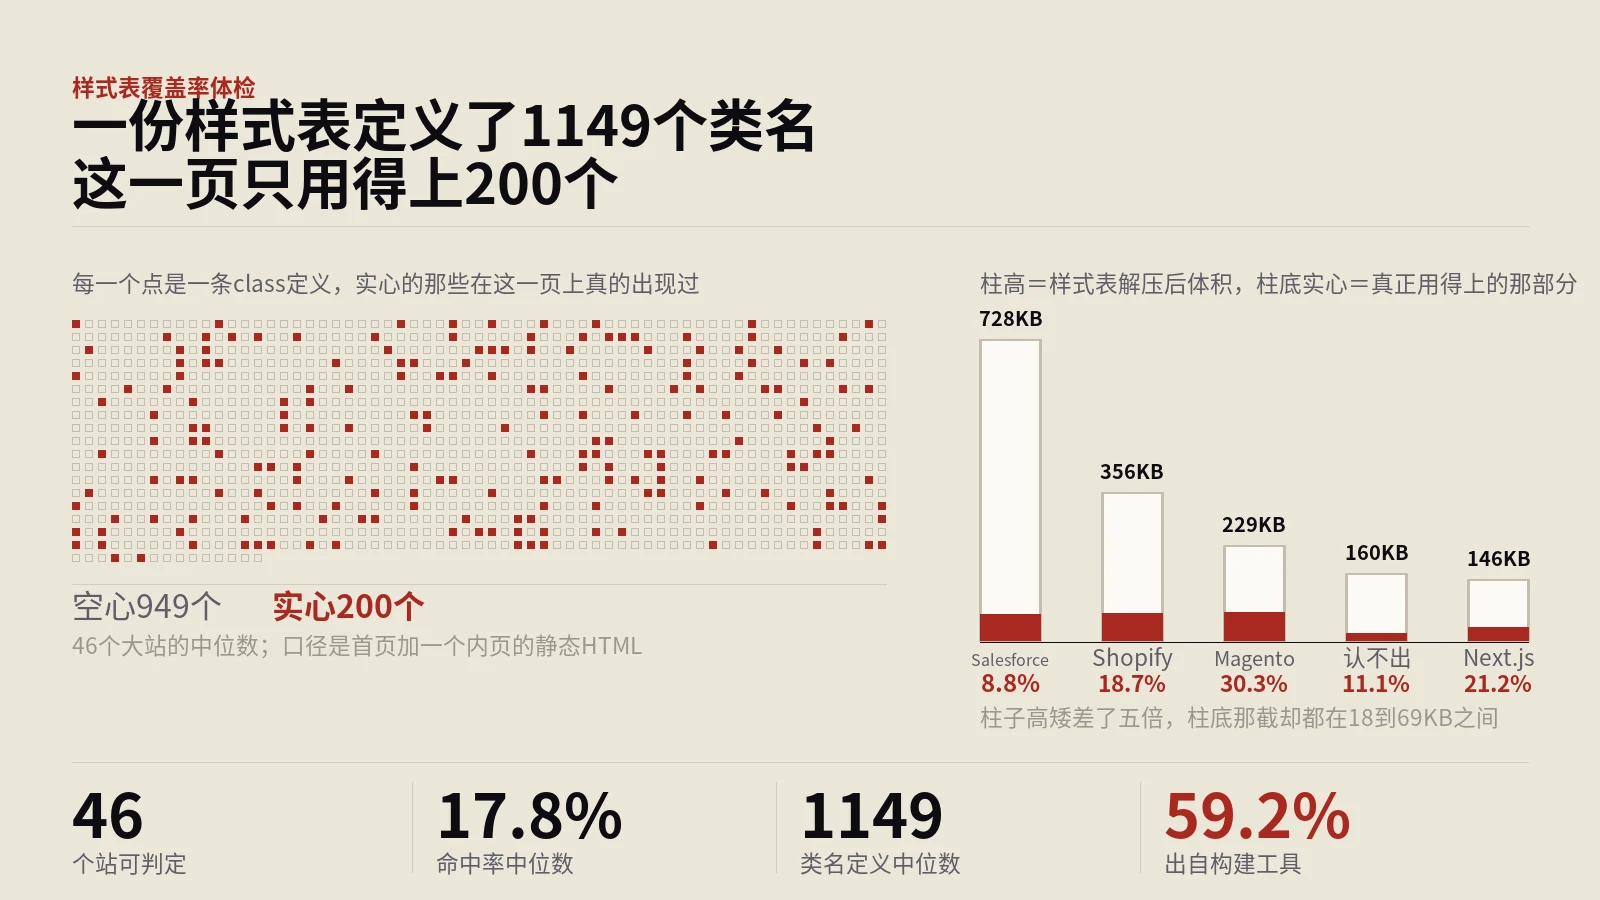
做法是抓首页声明的每一份样式表,把里面定义的类名跟首页加一个内页的类名求交集。尺子改过三次:正则会把url里的文件后缀当类名,而修它的那一刀更狠,反复挖花括号会把整个媒体查询里的选择器一起挖掉。
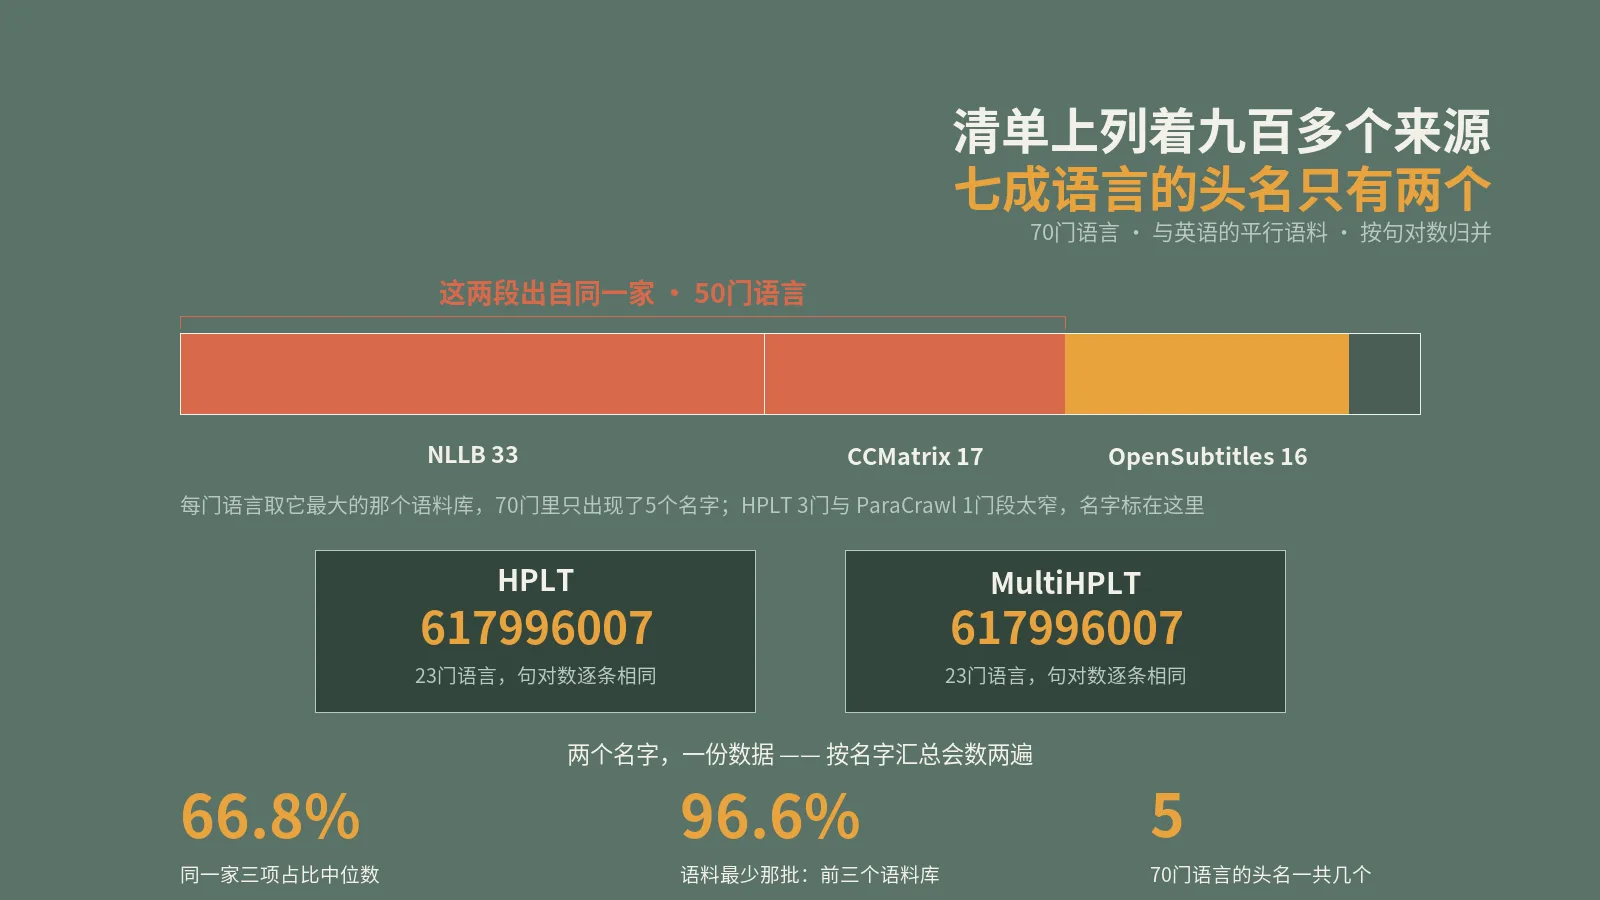
一门语言下面列着几十个语料库,看起来来源很分散。把句对数加起来按来源归并之后,分散只是清单的样子,不是数据的样子。
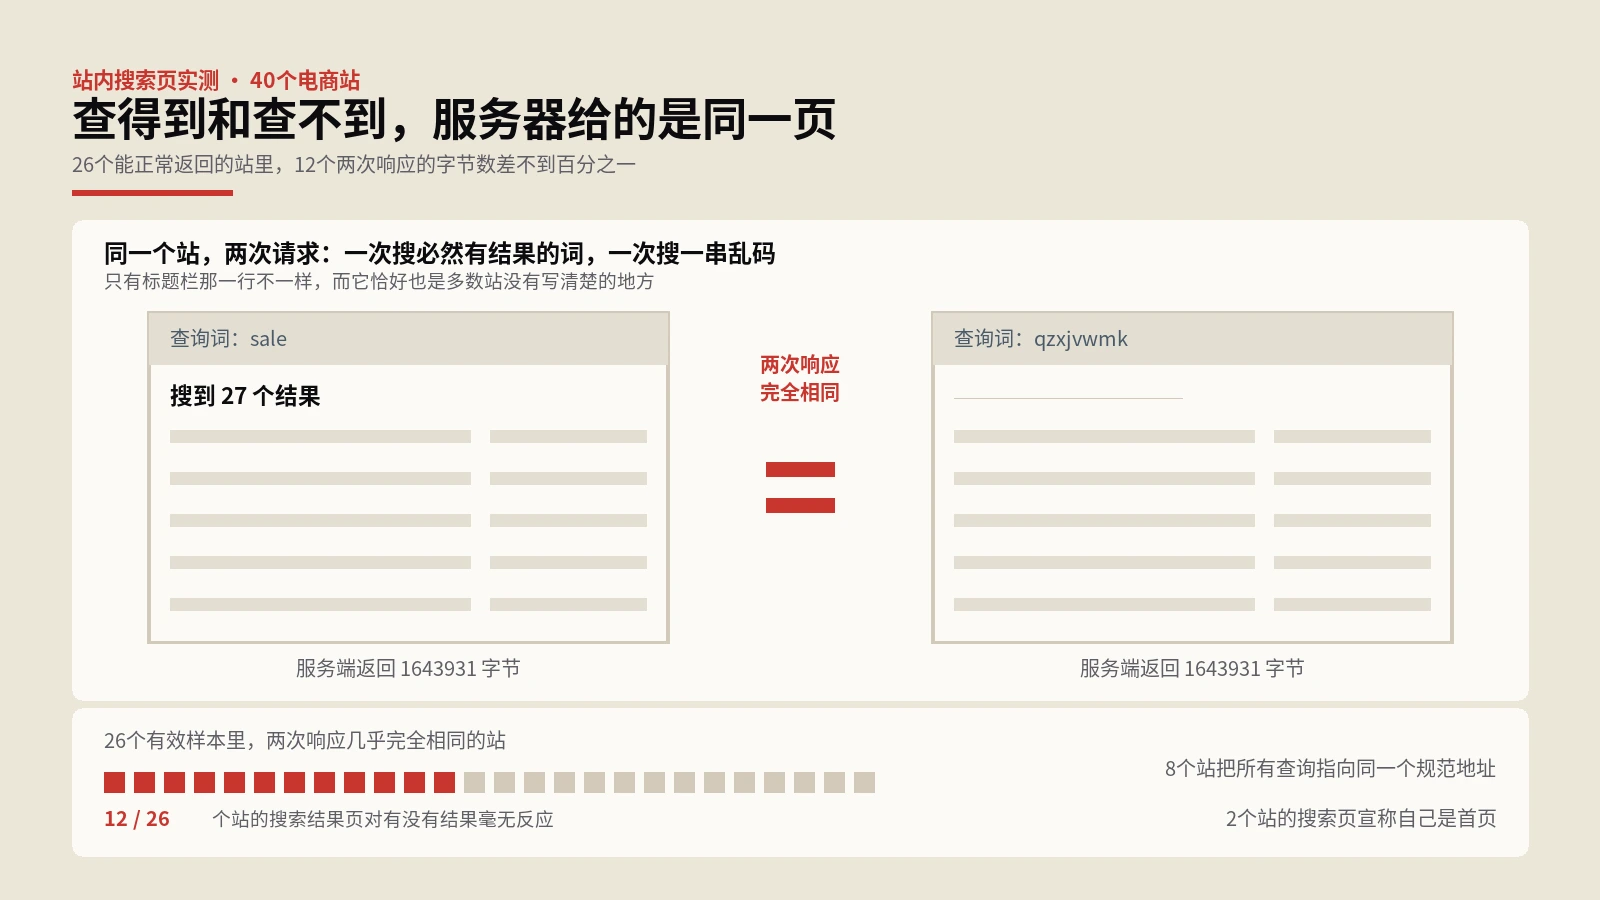
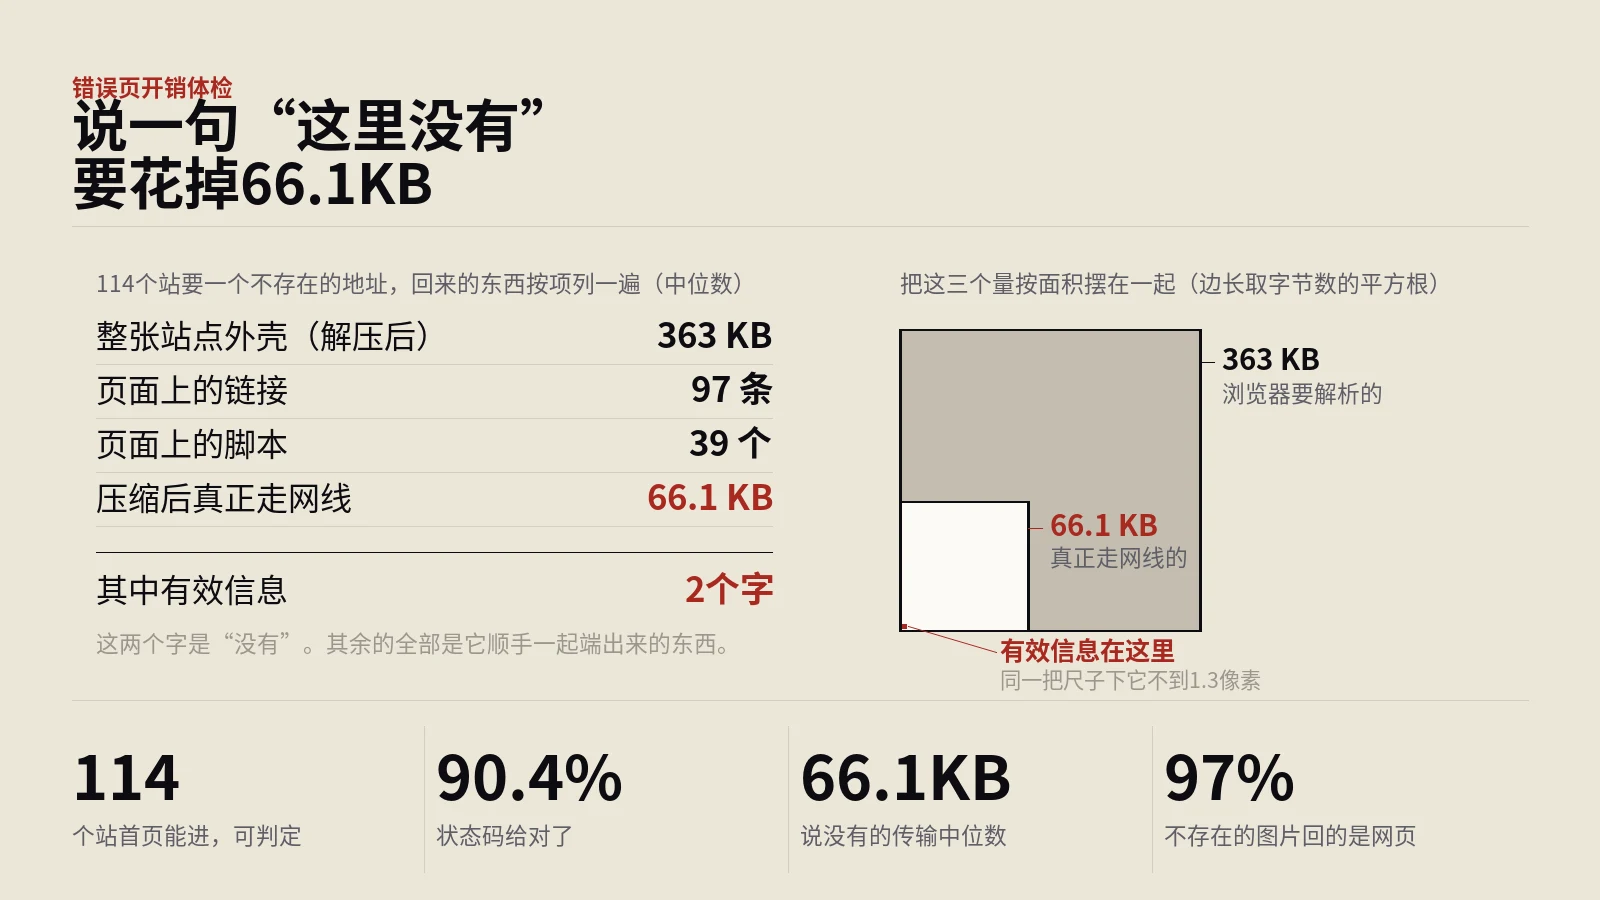
做法是给每个站要十一个编出来的地址,再要两个真实存在的当零点,同一个不存在的地址要两遍看字节稳不稳。尺子失效过一次:第一轮采得太密,三十六个站改口回429,放慢重跑之后又有七个站反过来被拒。
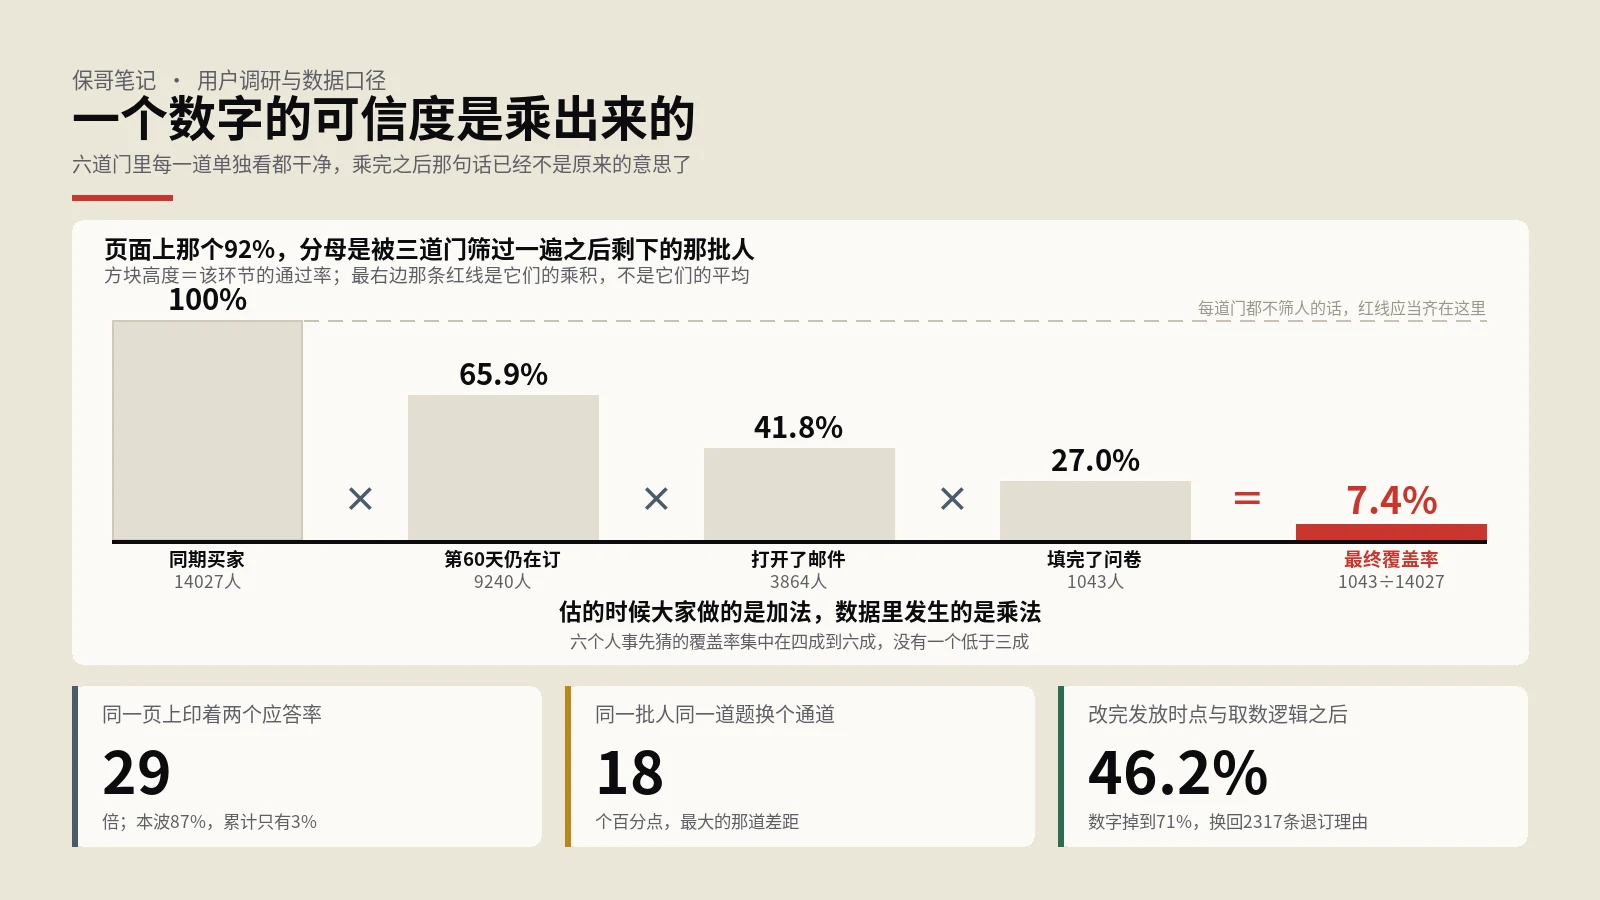
本文提出一条判断自报类数据的方法:任何一个满意度、改善率或推荐意愿的百分比,从提问走到页面上,固定要过六道门——谁在名单上、谁被联系上、谁真的答了、什么时候被问的、用哪个通道问的、哪些答案被留了下来。每一道门单独看都可以完全诚实,乘起来却会让这句话的意思变成另一回事。文中用皮尤研究中心2015年那次访问方式效应实验做实证:3003人随机分成电话组与网页组,同样的60道题,平均差5.5个百分点、中位数5个、最大18个;因费用未就医这道题在…