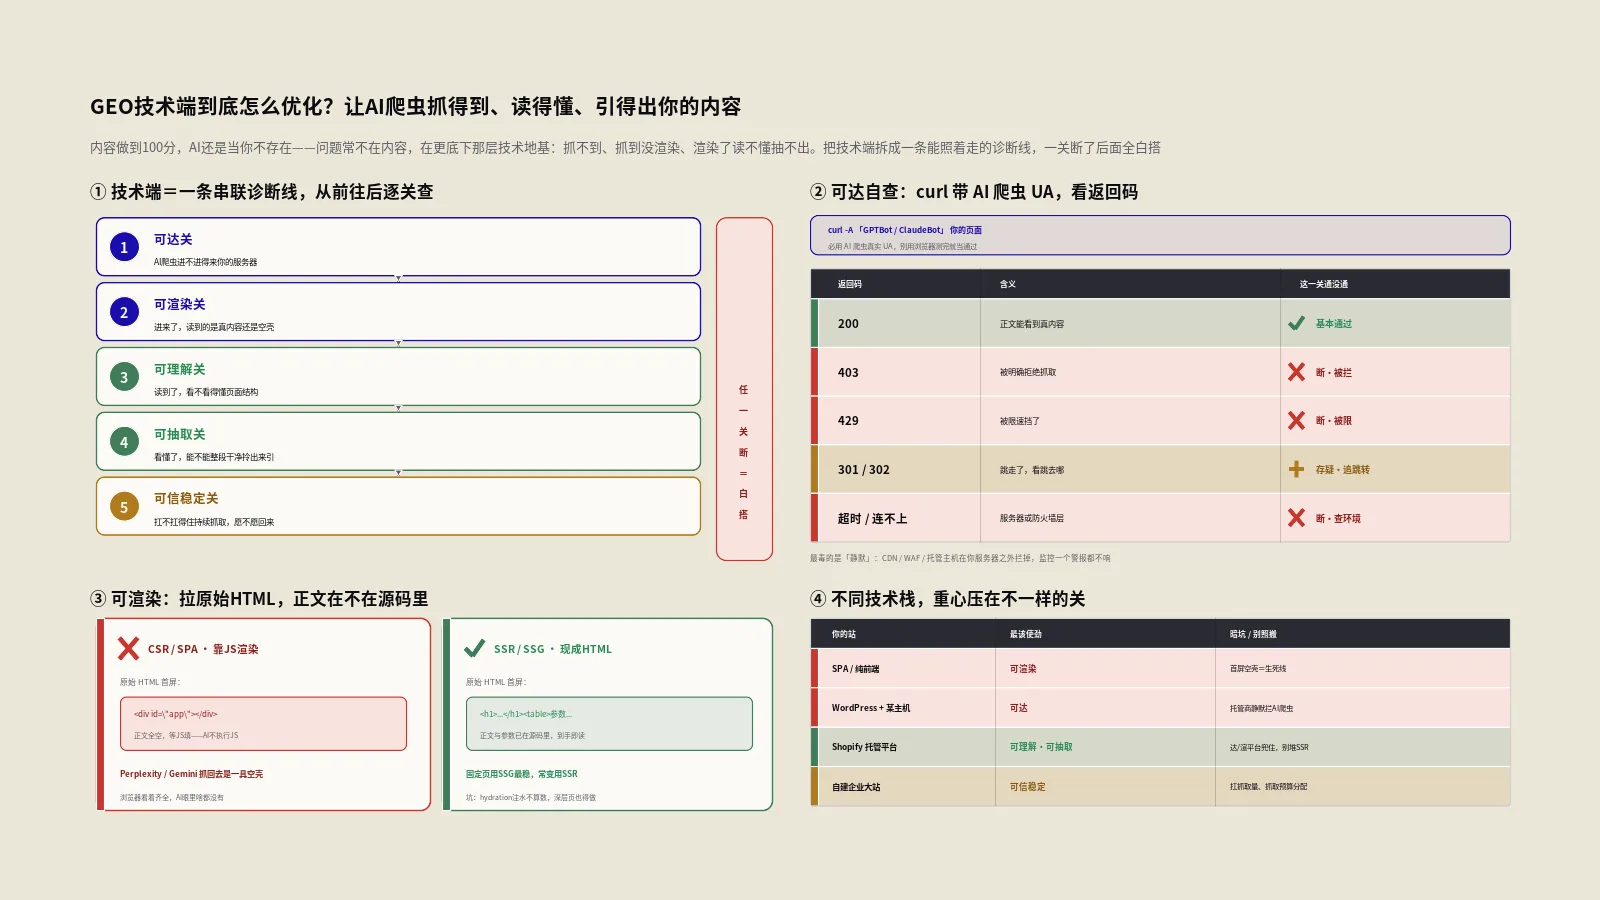
GEO技术端这样优化,AI爬虫才能抓得到、读得懂、引得出
内容写得再好,AI搜索却从不引用你?多半不是内容问题,而是AI爬虫根本没抓到、抓到没渲染出、或读不懂抽不出。这篇把GEO的技术地基拆成可达、可渲染、可理解、可抽取、可信稳定五道关,每关给自查命令和踩坑点,照着一关一关查通。
内容再好,爬虫抓不到、收录不进去也是白搭。这里深入技术SEO,从抓取预算、robots与sitemap、canonical与hreflang到JS渲染、日志分析和索引膨胀治理,帮开发和SEO协作把工程底子打牢。
内容写得再好,AI搜索却从不引用你?多半不是内容问题,而是AI爬虫根本没抓到、抓到没渲染出、或读不懂抽不出。这篇把GEO的技术地基拆成可达、可渲染、可理解、可抽取、可信稳定五道关,每关给自查命令和踩坑点,照着一关一关查通。
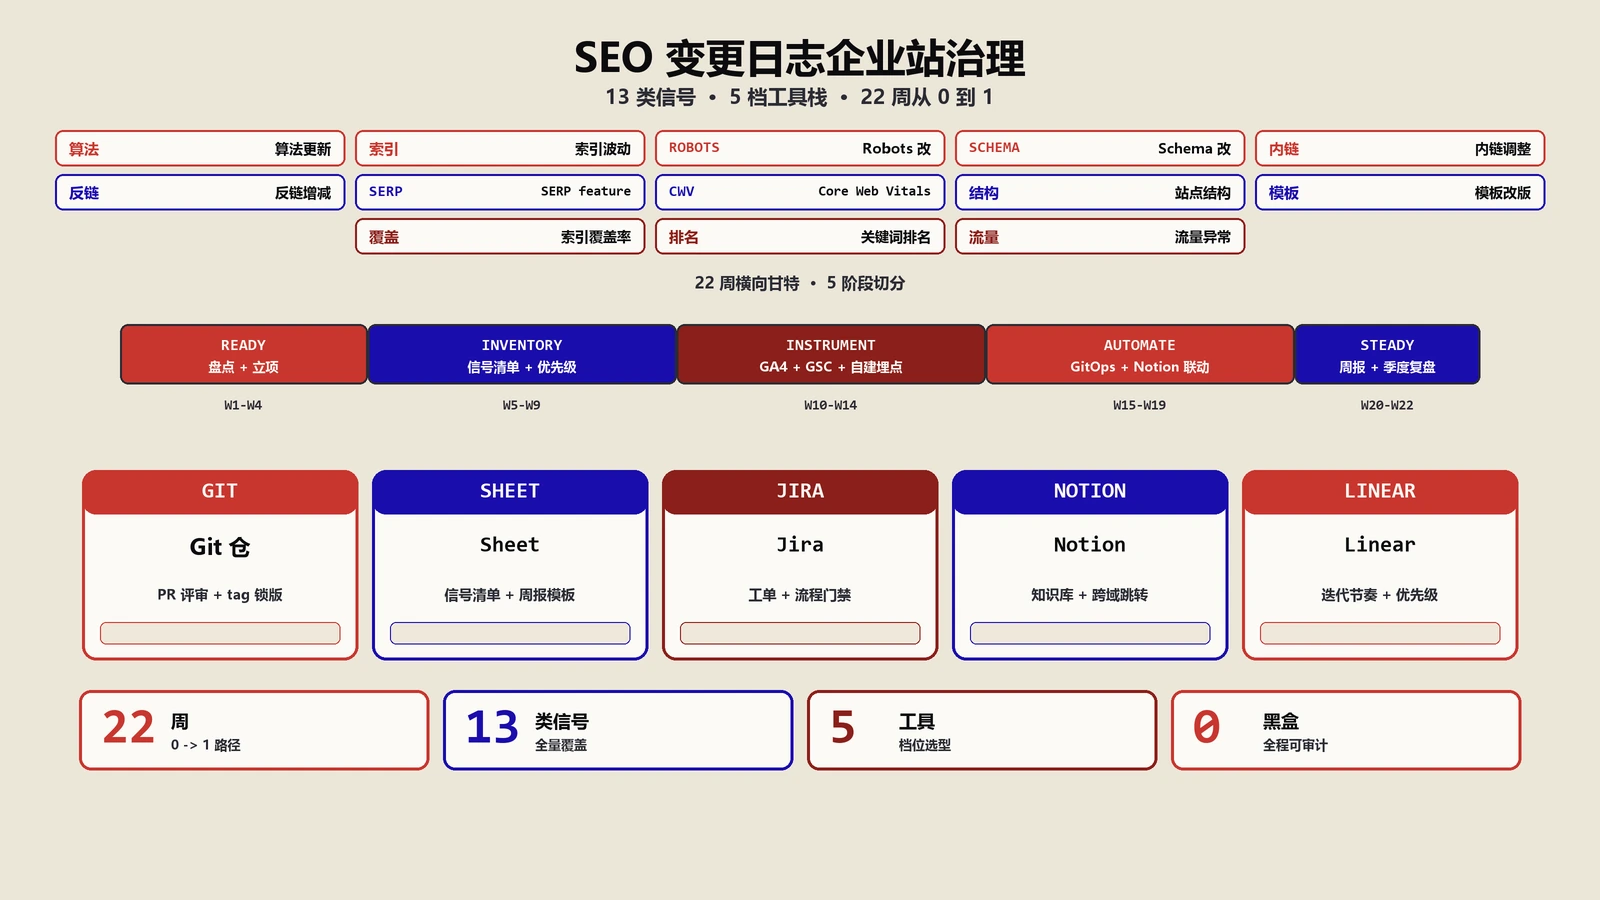
企业SEO团队对站点变化只有30%的可见度,剩下70%在开发部署、产品改模板、内容批量更新里悄悄发生。这套工程方法论拆解13类必监控信号、5档工具栈ROI横评、22周从0到1落地账本、5个项目成败指标阈值,让SEO从救火队员升级为搜索可见度治理顾问。
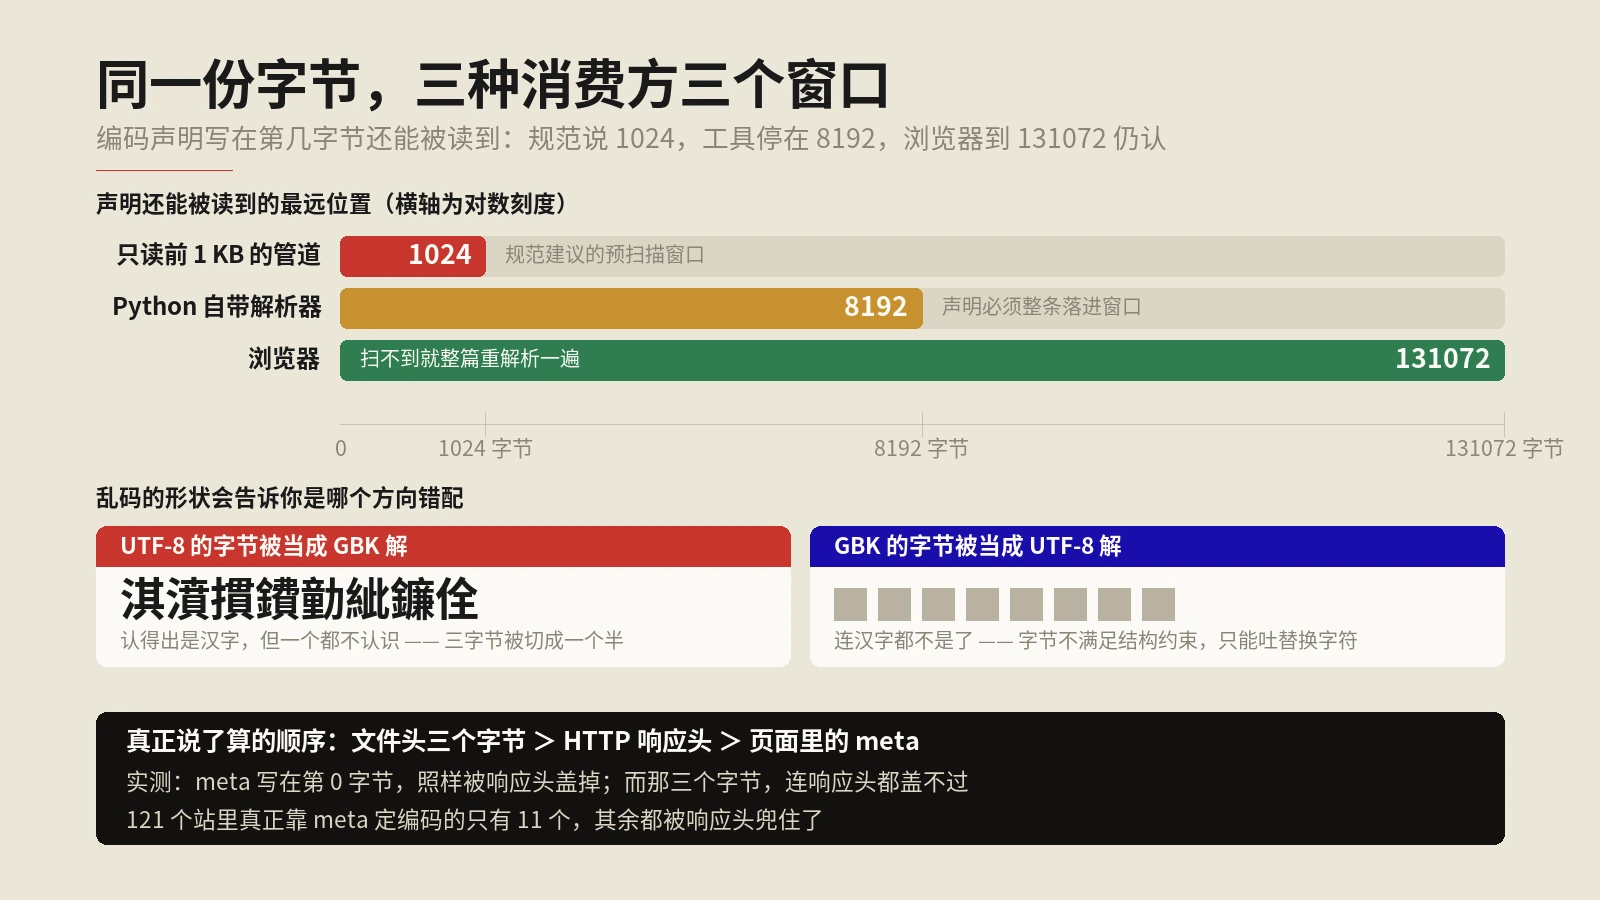
自建三档响应头实验台,把同一批字节分别发成不带声明、声明成一种编码、声明成另一种编码,逐档比对浏览器最终采用了什么。结论是那条链的顺序被大多数教程讲反了:写在文件开头第零个字节的页面内声明,照样被服务器发出的那一行盖掉;而文件头部那三个不可见的字节,连服务器都盖不过。另含两种乱码形态如何反推错配方向、老写法比新写法多占四十六字节窗口预算。
很多出海独立站突然从Google消失,根因不是内容问题而是robots配置——把抓取和索引混为一谈、Disallow拦住想noindex的页面、X-Robots-Tag误覆盖全站。本文给一张三件套边界图、所有指令清单、优先级裁决规则和出海亲子玩具独立站12周修复误封的真实SOP,看完就能直接判断自己这套robots到底改不改、改在哪一档。
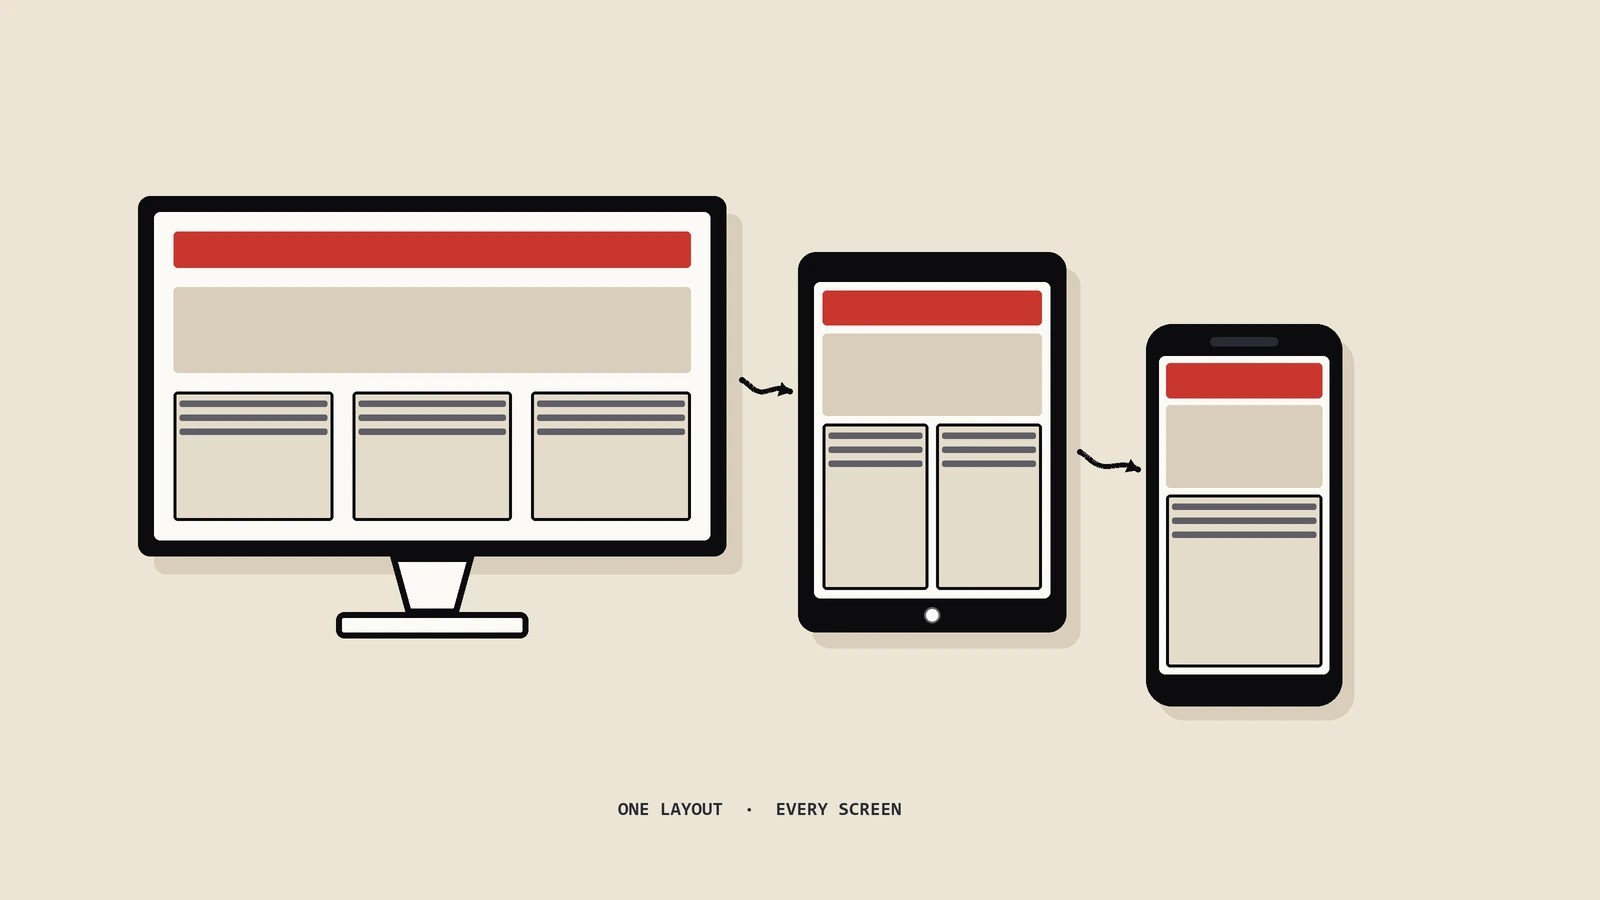
RWD响应式、AWD自适应、动态服务三种架构对Google爬取额度、权重聚合、移动优先索引、Canonical稳定性的影响完全不同,本文给出选型矩阵、五大落地坑、五步迁移SOP和真实车载用品独立站切换案例,看完就知道自己这套网站到底该不该改、改到哪一档。
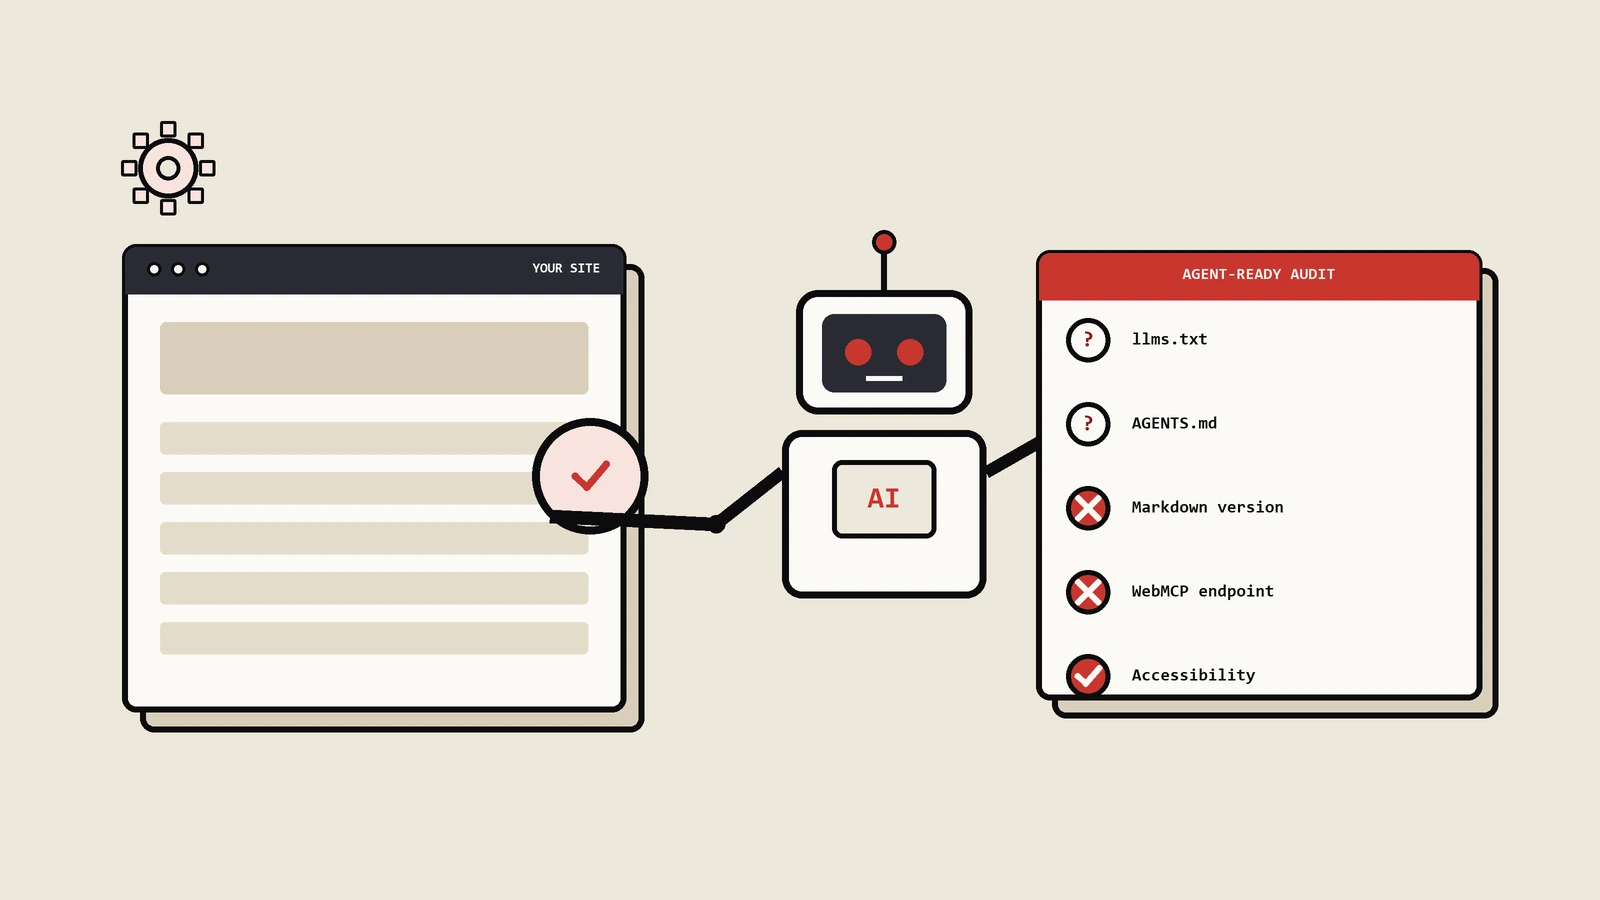
Google搜索说不用做llms.txt、不用为机器人单独写Markdown,可Chrome的Lighthouse又新增了Agentic Browsing审计来查这些。本文拆解口径分歧背后discovery与functionality的分工,讲清Markdown、llms.txt、WebMCP到底值不值得做,并给出一张按网站类型分级的agent友好度优先级落地表。
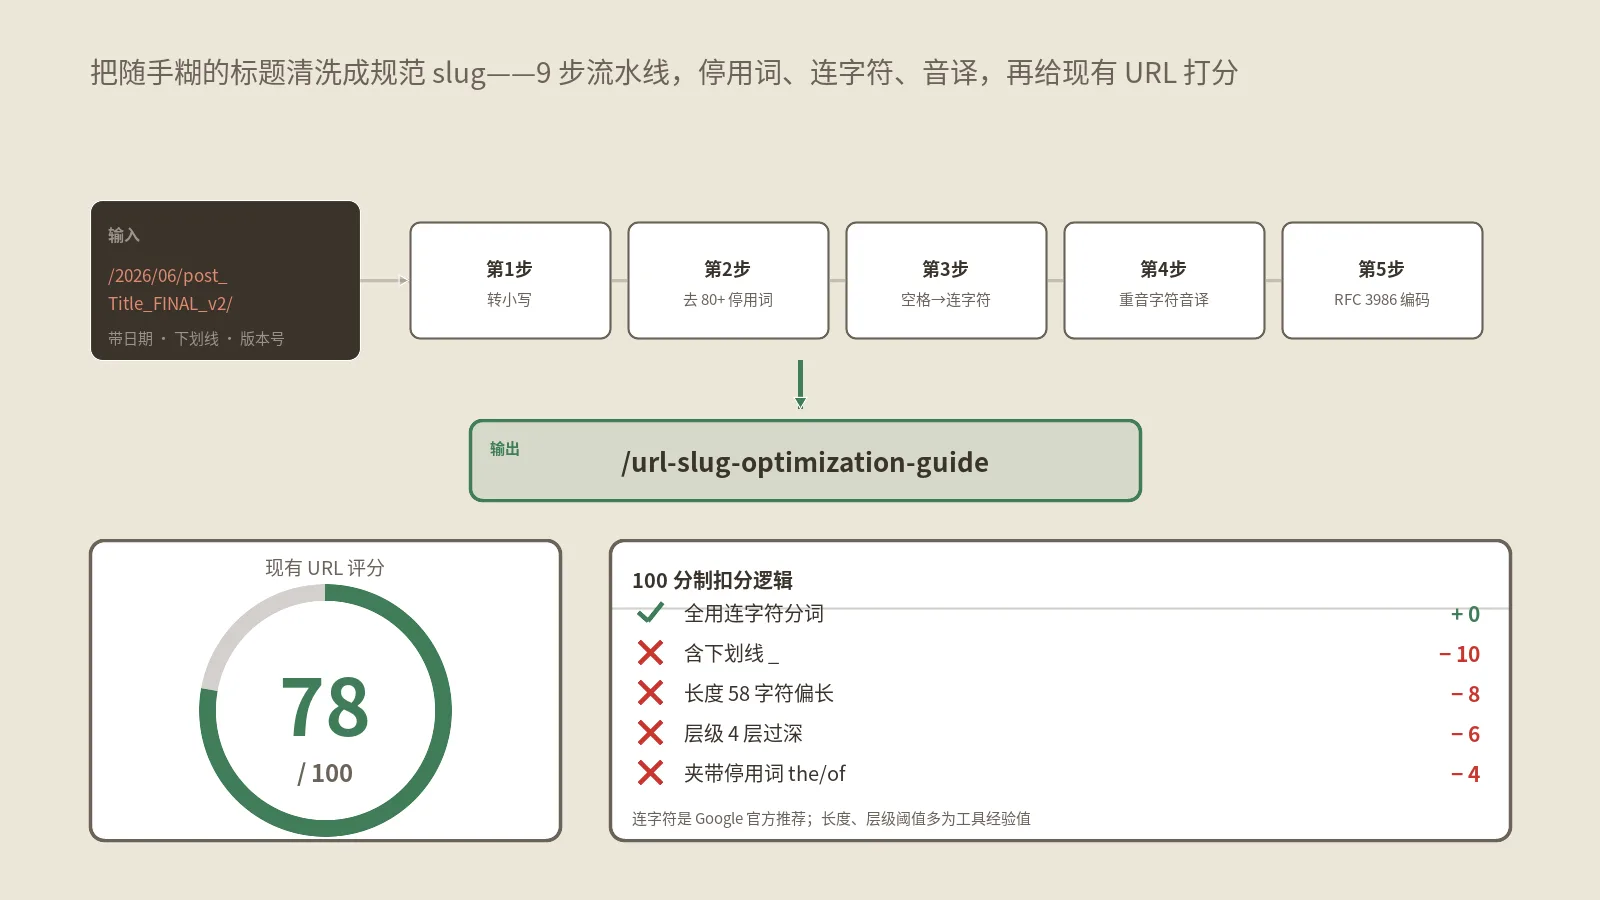
URL用连字符还是下划线、长度卡多少、中文怎么转slug?本文拆开一个URL slug优化器的9步清洗流水线、80多个停用词取舍、音译表与100分制评分,讲清哪些是Google铁律、哪些是工具经验值,最后回答上线URL到底该不该为优化去改。
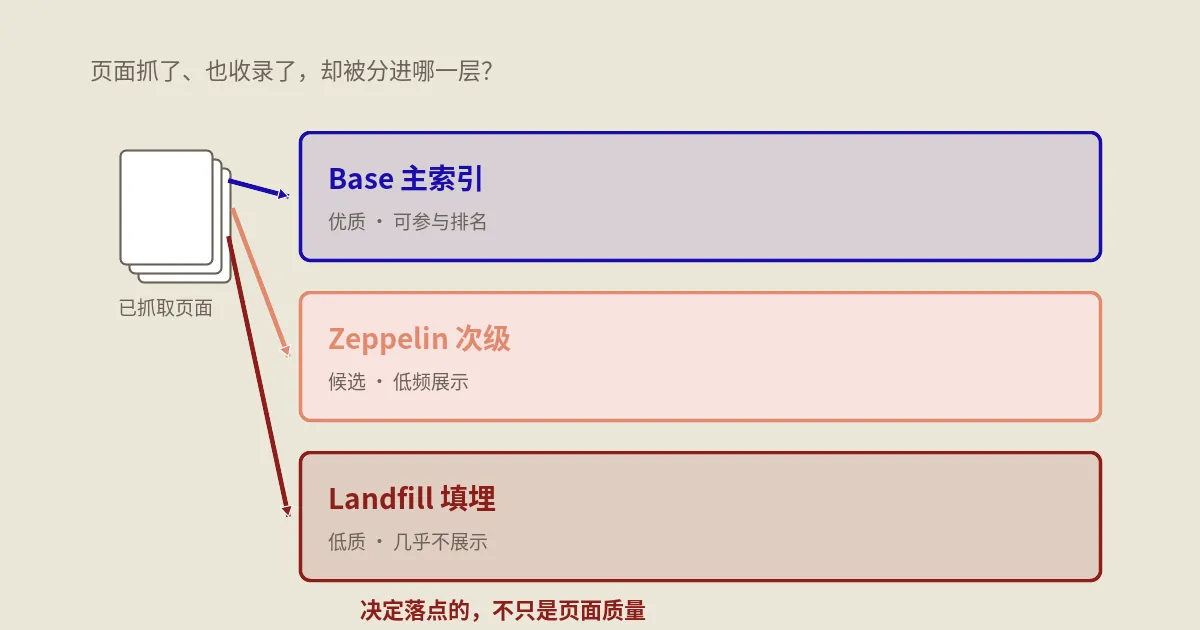
谷歌的索引分Base、Zeppelin、Landfill三层,2004年分区专利与2024年API泄露双重坐实。页面被收录不等于进了能排名的那一层;决定层级的是站点级static rank而非单页质量。这篇拆解三层机制、HCU为何是站点级降层、怎么自查所在层级,以及掉进低层后的翻盘策略。
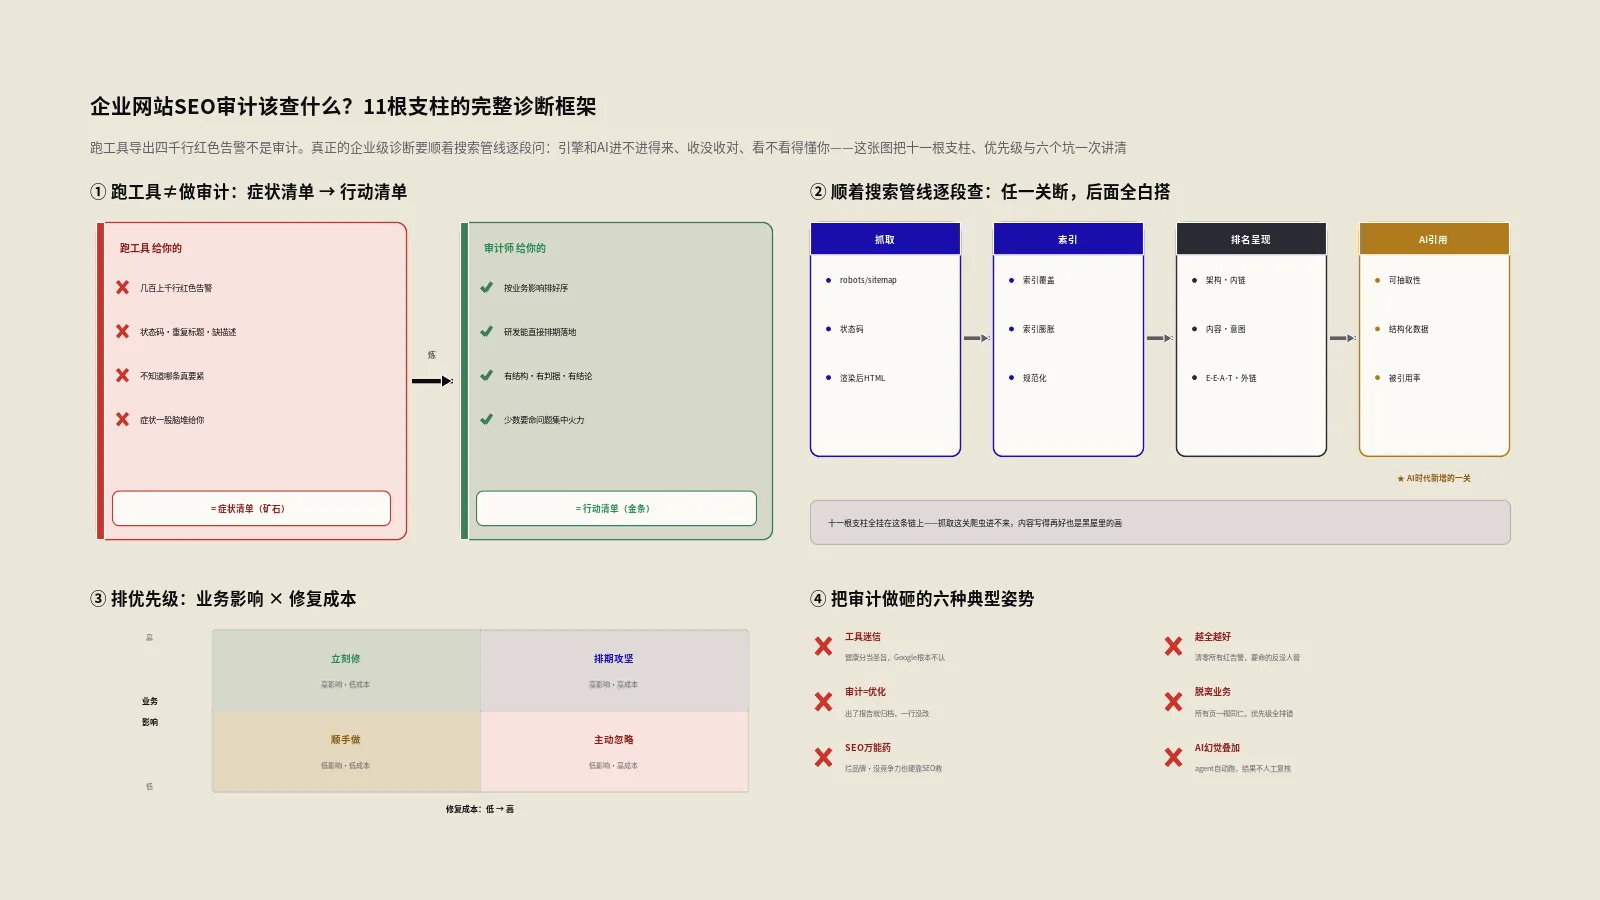
把企业SEO审计拆成十一根支柱:可访问性、索引、架构、页面体验、内容、搜索意图、E-E-A-T与实体、外链、GEO与AI可见度、竞品到国际化,逐根讲清查什么、用什么判据、怎么按业务影响排优先级、报告怎么交付才落地,附一份可执行清单。
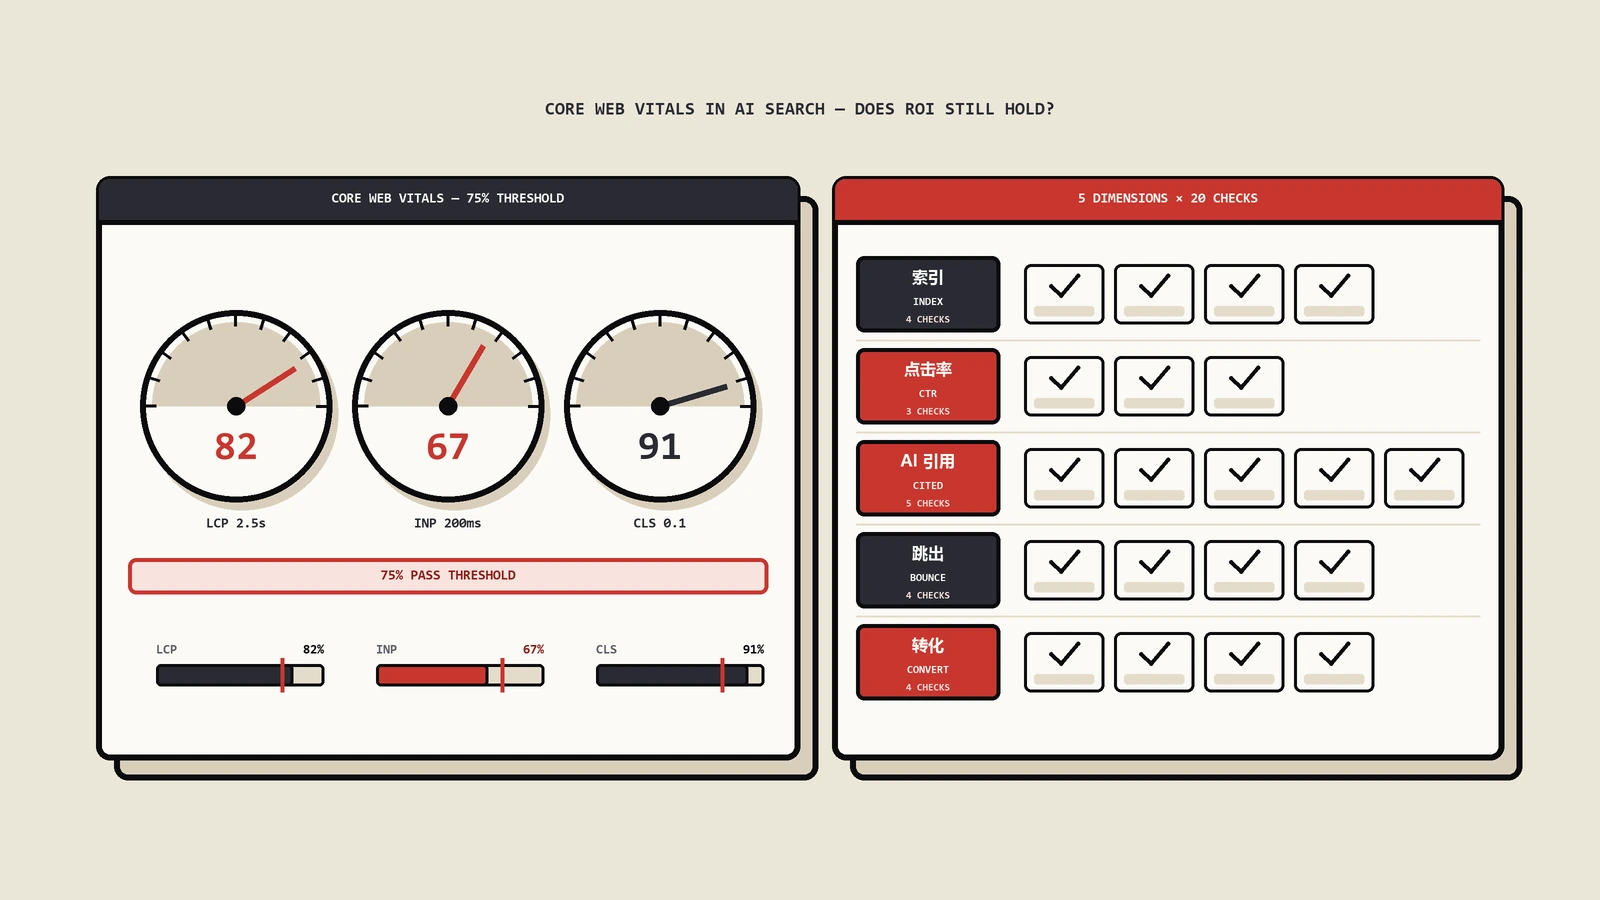
Core Web Vitals在AI搜索时代不再是排名加分项而是retrieval阶段硬门槛。本文聊LCP/INP/CLS对AI检索的真实影响、Jakob Nielsen响应时间模型、行业benchmark的非CWV维度、客户实测3个反常识、图片优化4层路径、转化率+广告成本+AI citation三重ROI。
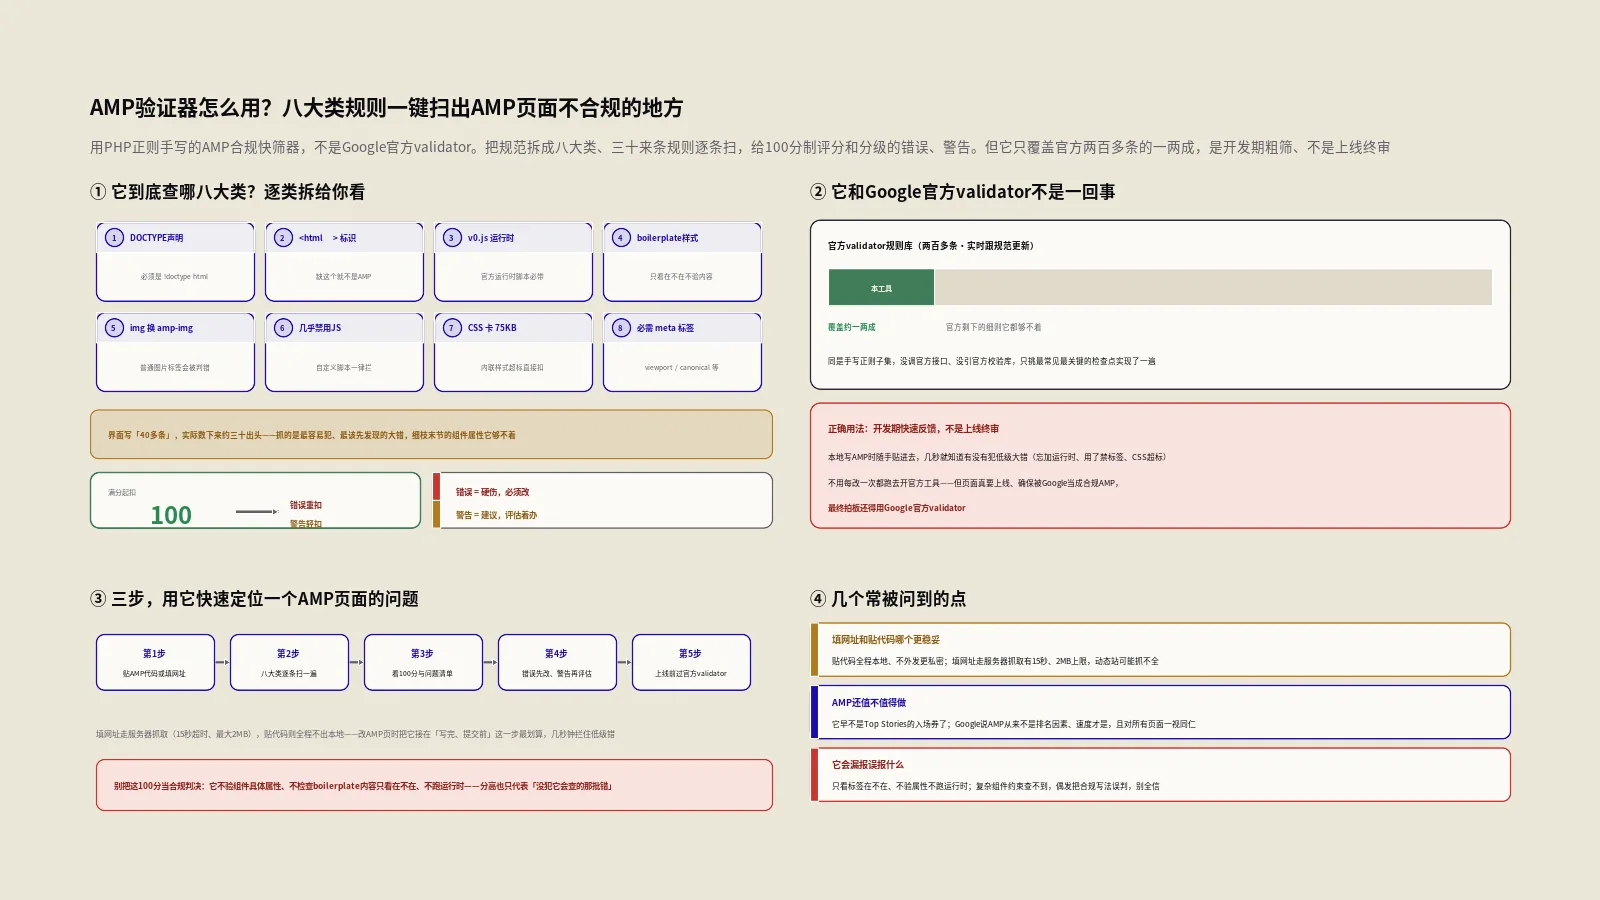
用PHP正则手写的AMP HTML合规快筛器,把规范里最常见的检查点拆成八大类三十来条规则,一键给出100分制评分和分级错误清单,支持贴码或抓网址。它只覆盖官方两百多条规则的一两成,是开发期粗筛而非上线终审。
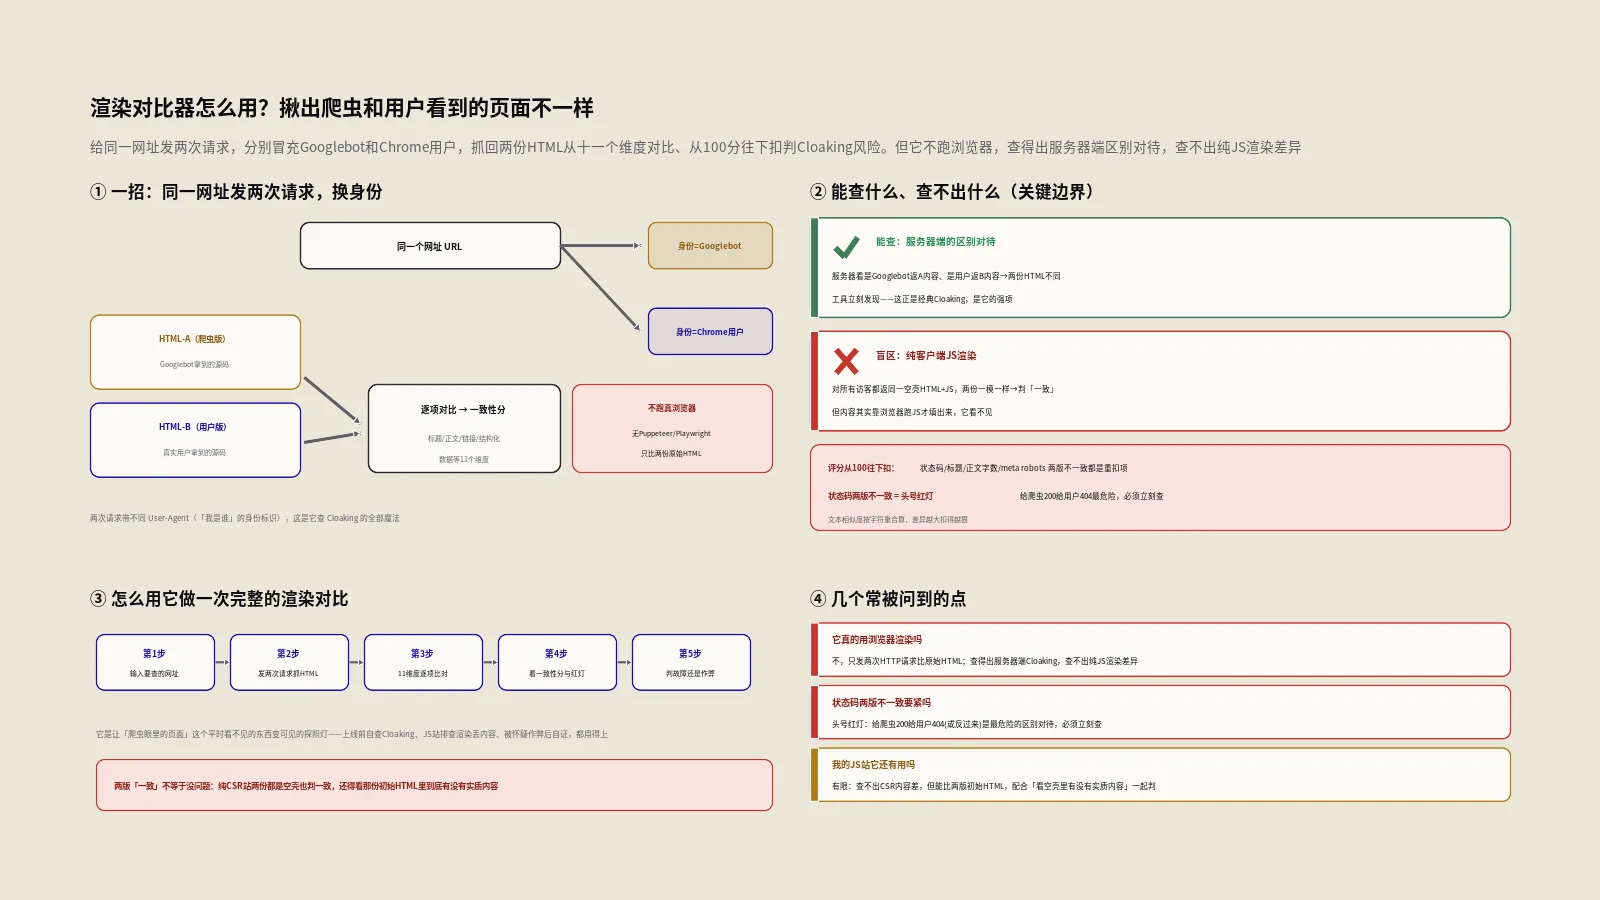
搜索引擎爬虫看到的页面,和真实用户看到的是同一份吗?本文拆解一个渲染对比器:它怎么发两次请求分别冒充Googlebot和用户、从十一个维度对比扣分判Cloaking风险,以及它不跑真浏览器、查得出服务端区别对待却查不出纯JS渲染差异这条关键边界。
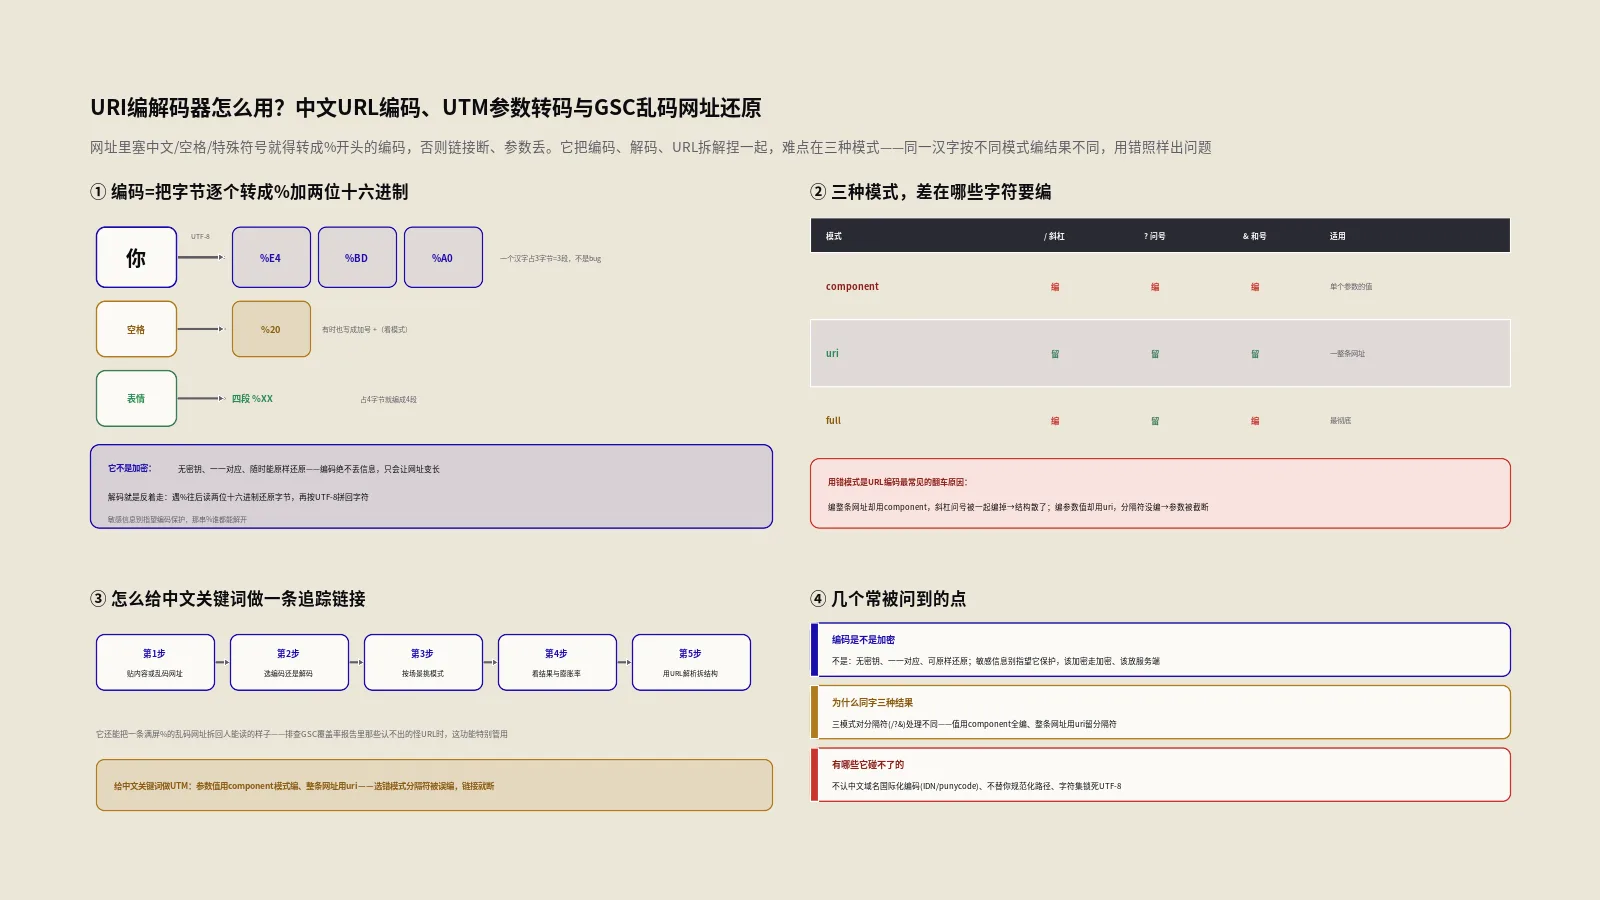
把含中文、空格、特殊符号的内容在网址里安全编码与还原,提供component、uri、full三种模式按场景选用,还能拆解一条网址的结构、把满屏百分号的乱码网址解回真身。它不支持中文域名的Punycode,也不替你规范化路径。
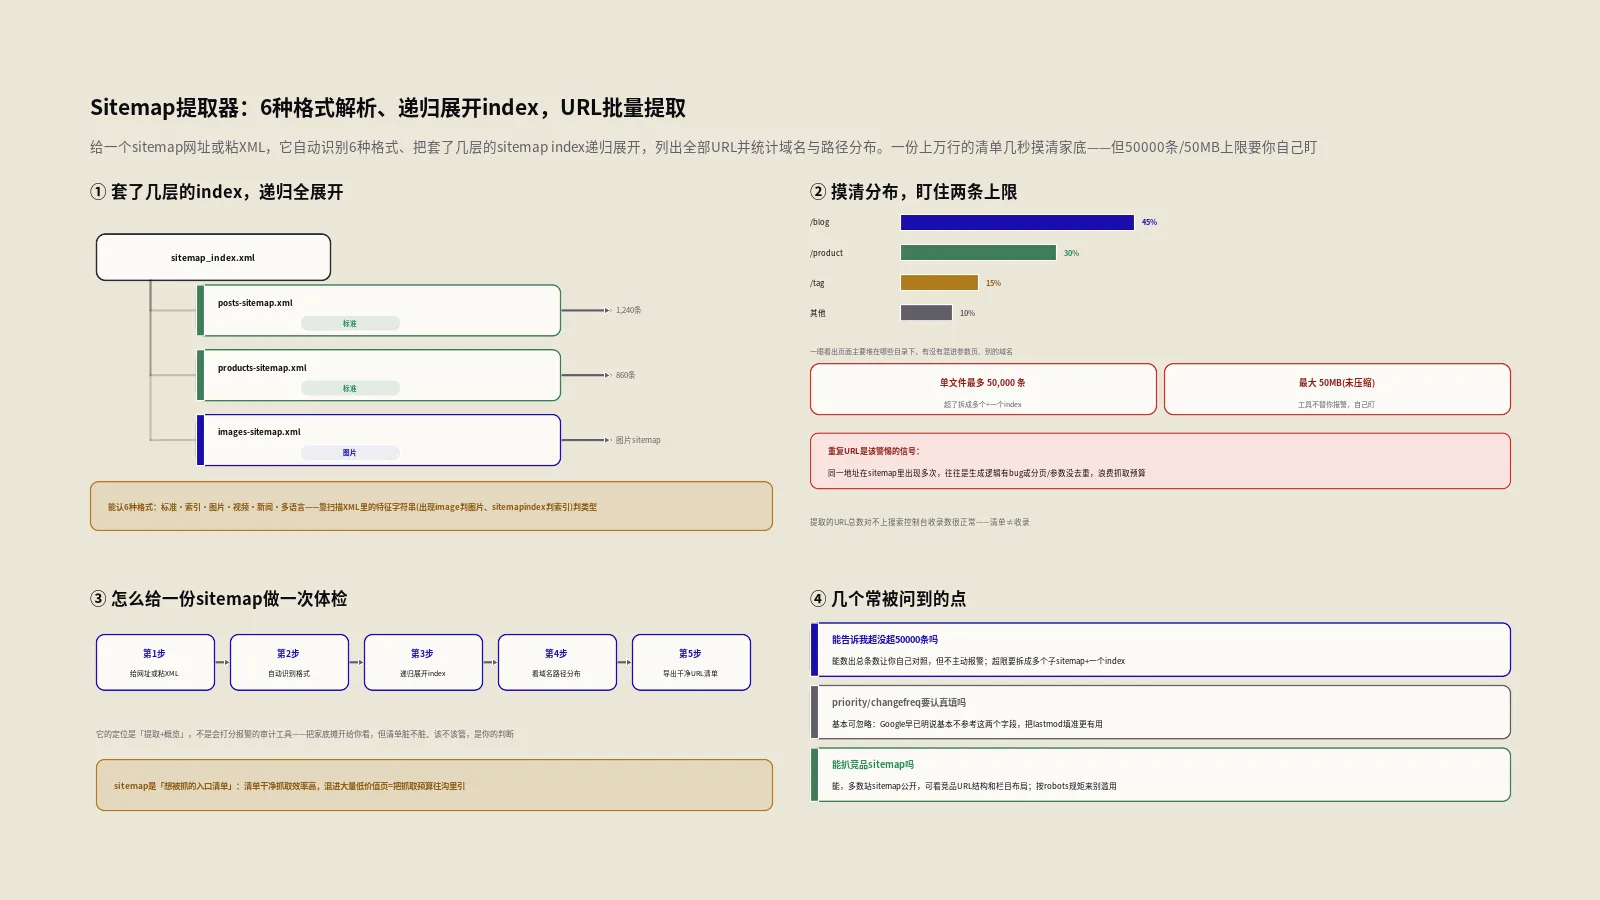
sitemap动辄上万行,肉眼看不出装了多少URL、有没有垃圾页。本文拆开一个sitemap提取器识别6种格式、递归展开索引、统计域名与路径分布的逻辑,讲清50000条与50MB两条官方上限的来历,以及它能提取什么、不能验证什么。
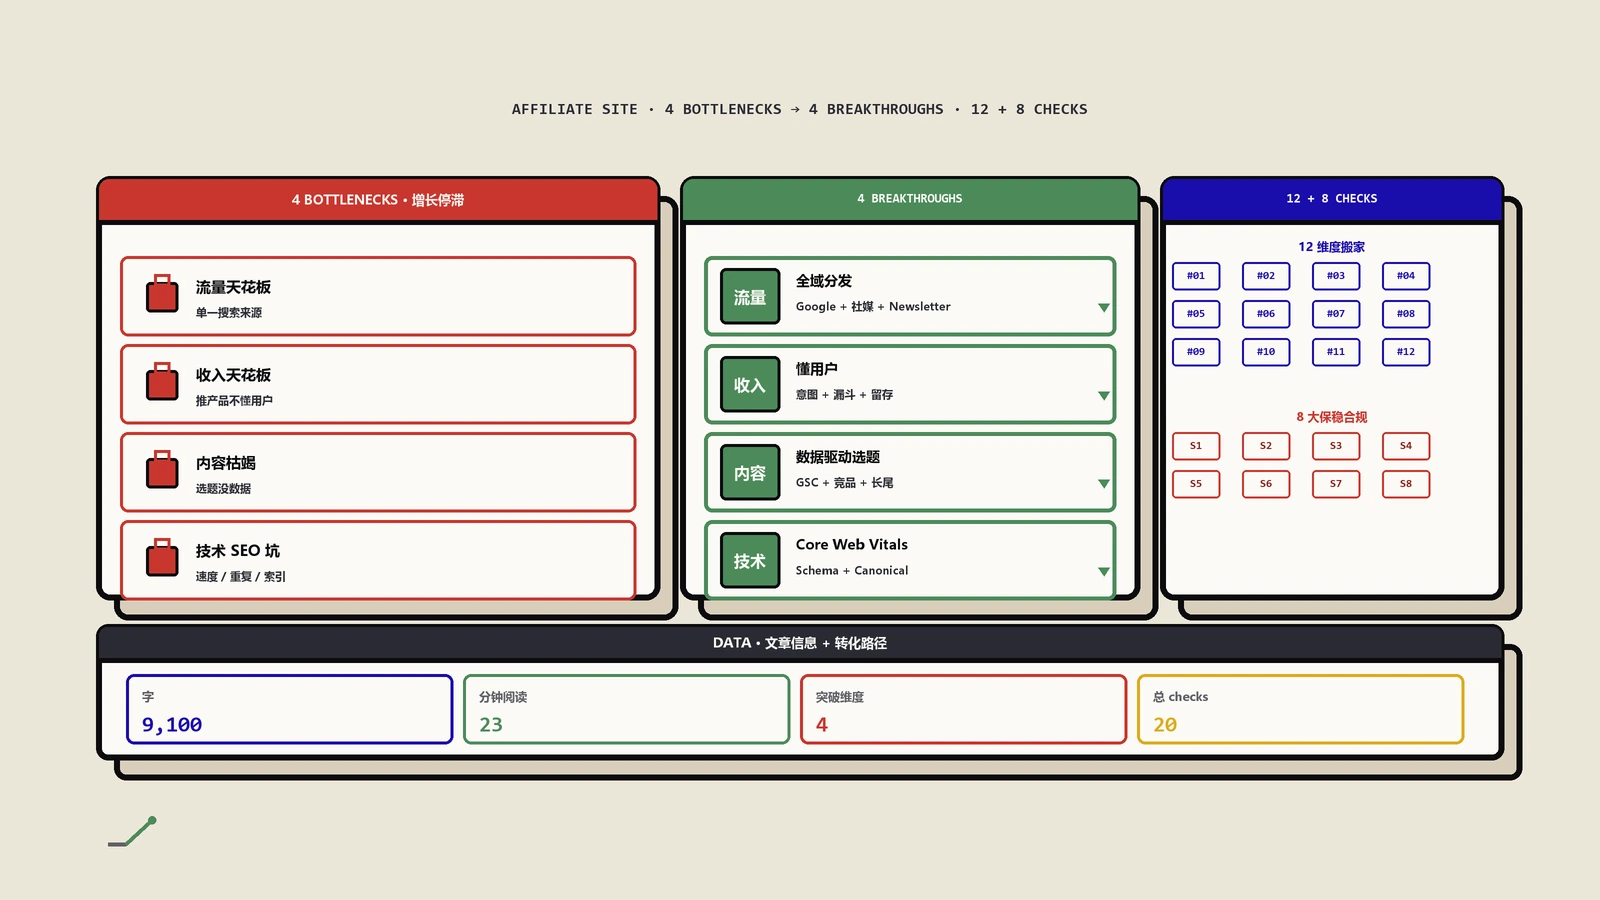
联盟营销网站遇到流量瓶颈和收入天花板怎么办?本文从流量停滞、收入平台期、内容枯竭、选品困局四大维度出发,提供8个可直接落地的数据驱动增长策略,涵盖多平台分发、受众画像挖掘、UGC社区构建、AI辅助选题等实操方法,帮助Affiliate站长突破增长瓶颈。
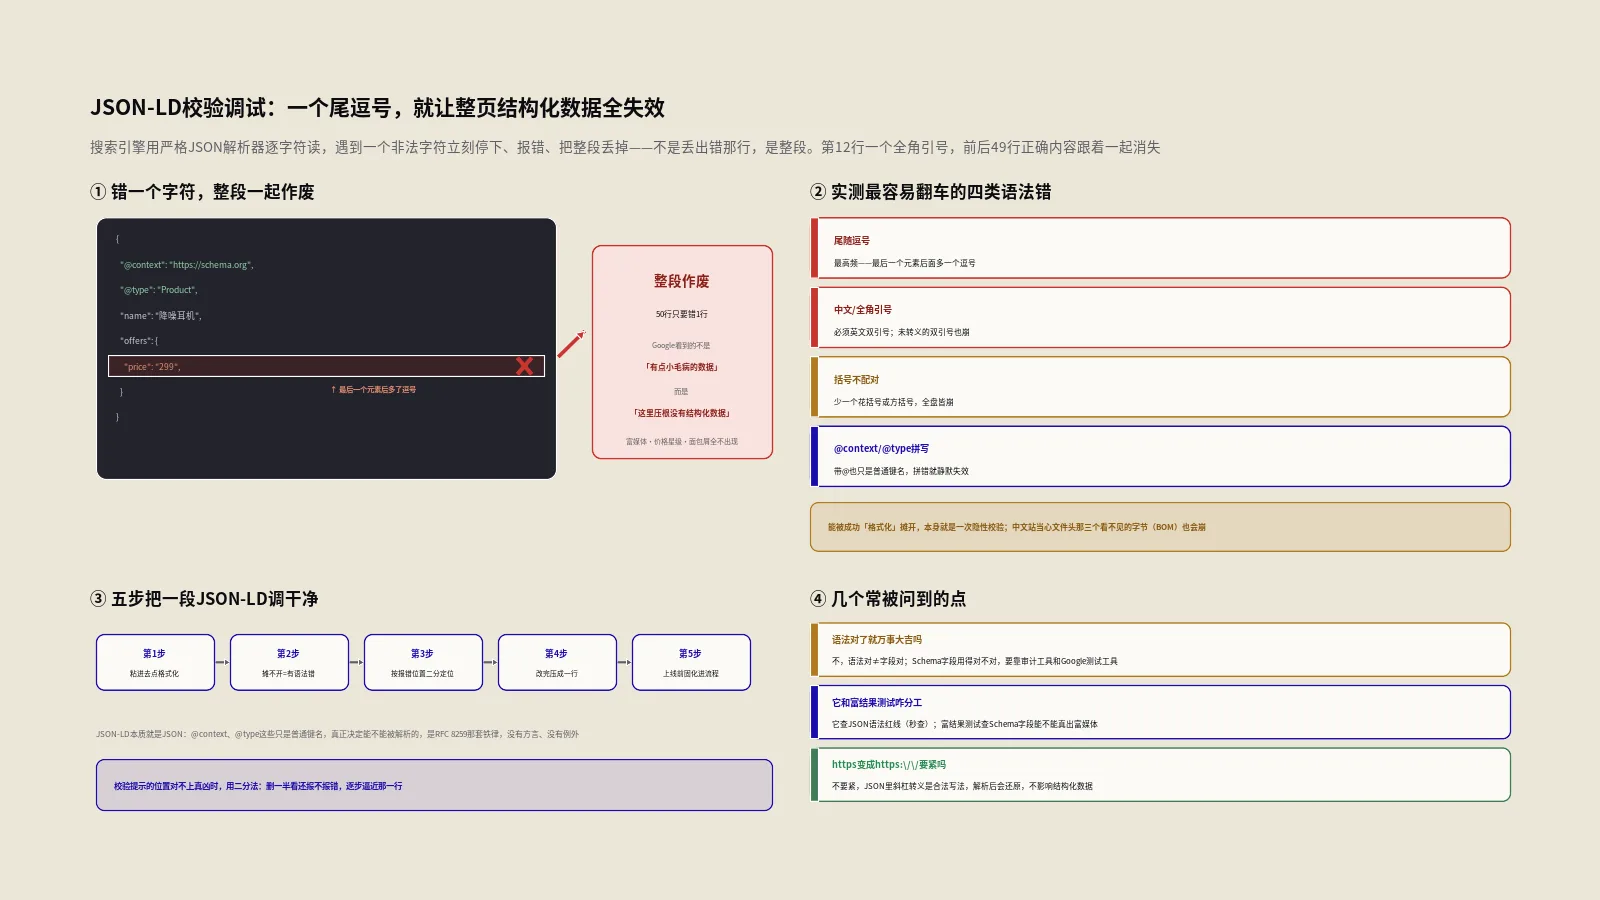
做技术SEO最冤的bug,是结构化数据因为一个标点失效却查了好几天。这篇讲怎么用一台JSON校验工具,把这类语法层的坑在上线前两秒钟拦下来,让丢给Google测试的代码只剩真正的字段问题。
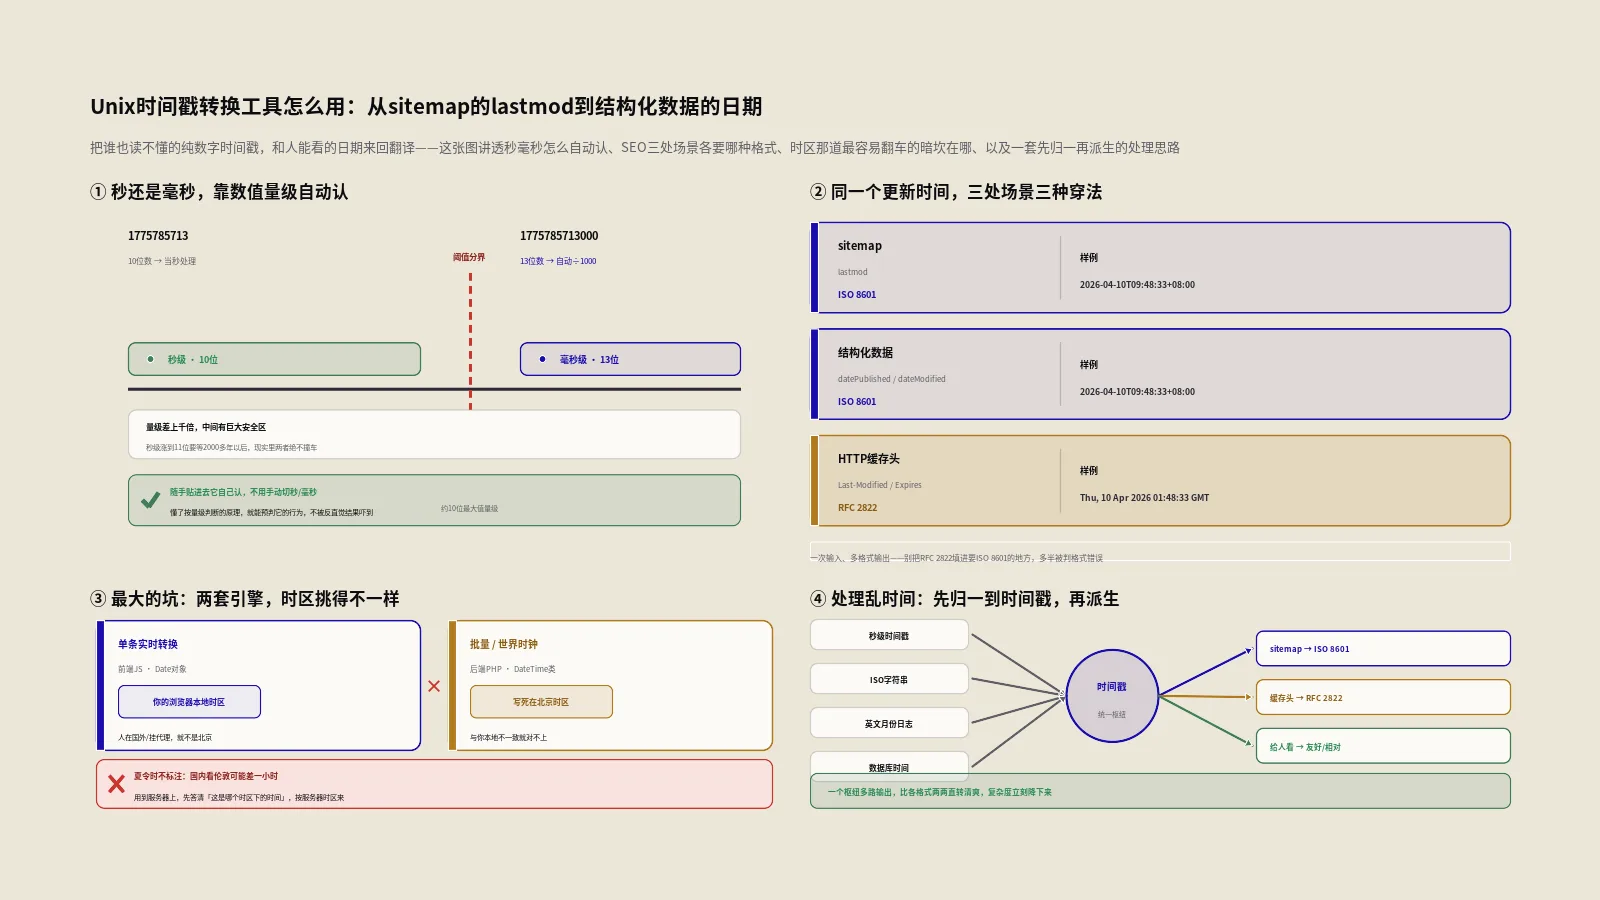
日志里那串十位数字到底是哪天?sitemap的lastmod又该填什么格式?这款Unix时间戳转换工具把时间戳和日期来回翻译,一口气给出ISO 8601、RFC 2822等多种格式。本文讲清它怎么用、时区这道最容易翻车的暗坎,以及怎么把lastmod和结构化数据日期填对。
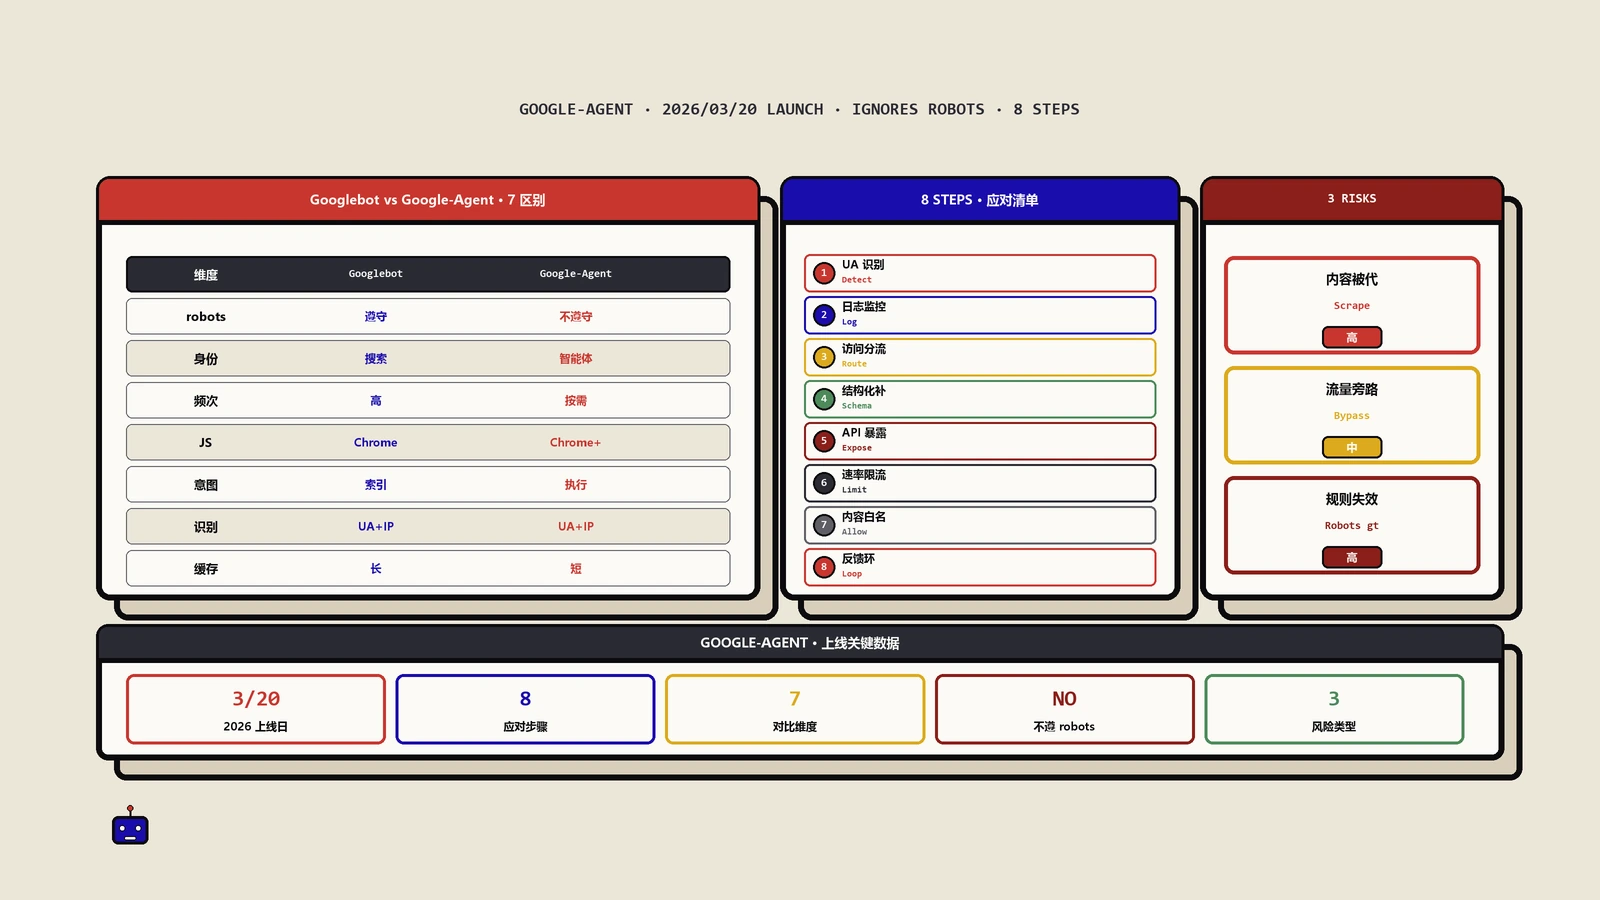
Google在2026年3月正式新增Google-Agent用户代理,标志AI智能体爬虫从实验室走向生产环境。本文深度解析Google-Agent的工作原理、与Googlebot的本质区别、IP范围与robots.txt策略、CDN与WAF配置要点,以及Agentic SEO时代网站主必须做的前瞻布局与监控方案。
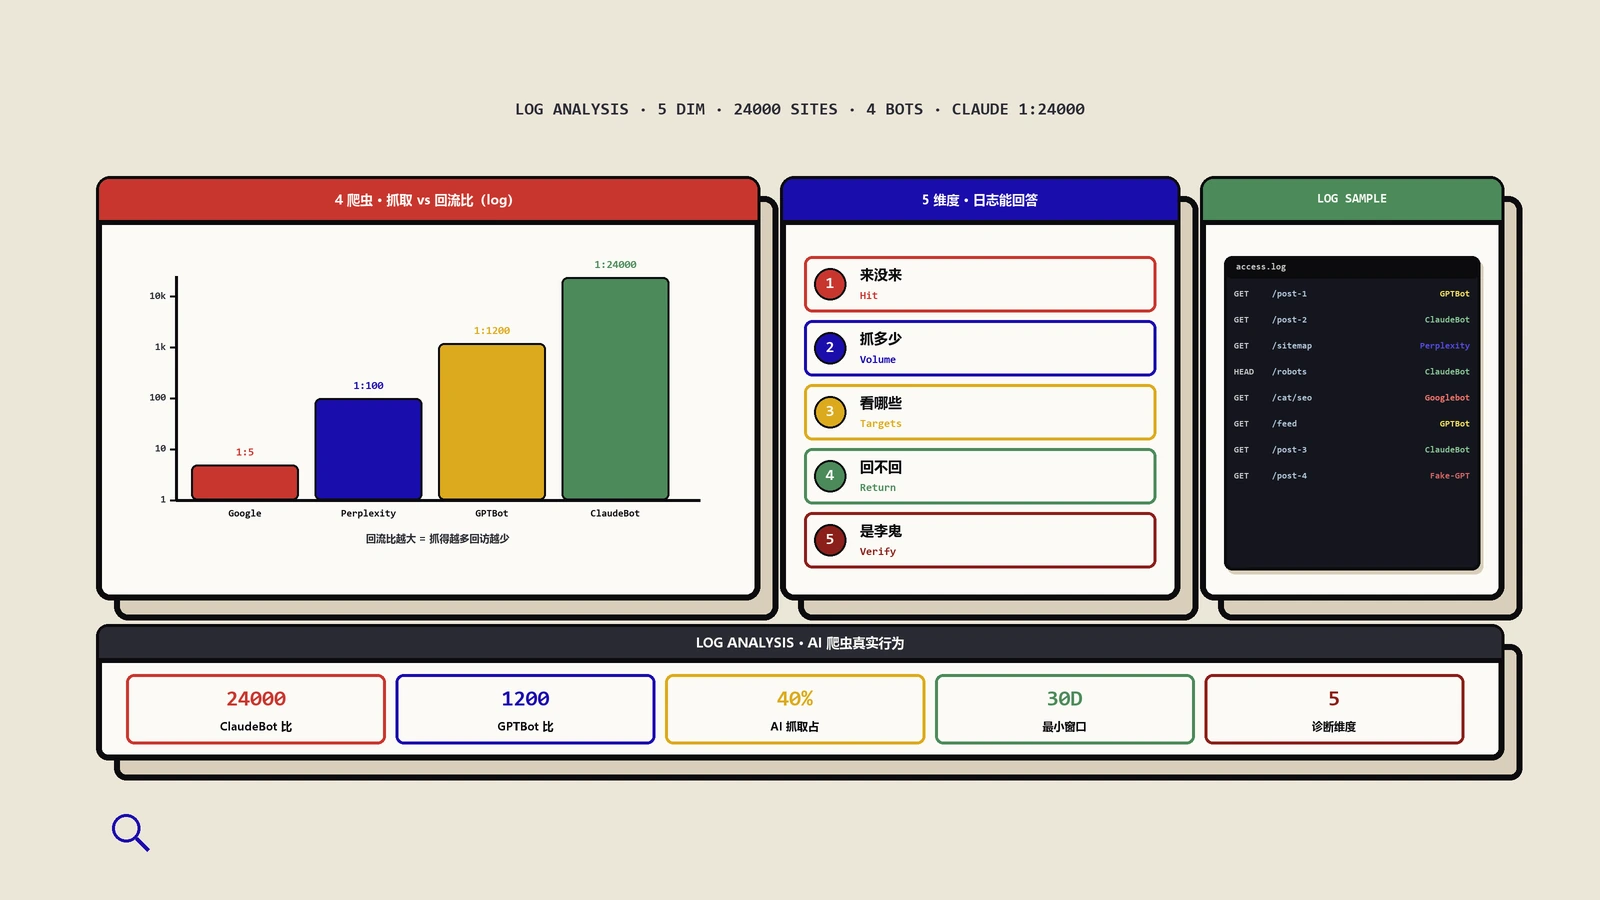
你的内容每天被AI爬虫抓走喂进ChatGPT和Claude的回答,但没有任何官方报表能让你看见这件事。这篇带你用服务器日志补上这块盲区:分清训练型与检索型爬虫为什么要区别对待、五层诊断怎么一步步深入、命令行和Python脚本怎么落地、日志为什么必须搬出主机长期存,以及robots.txt分层和迁移验真该怎么做。
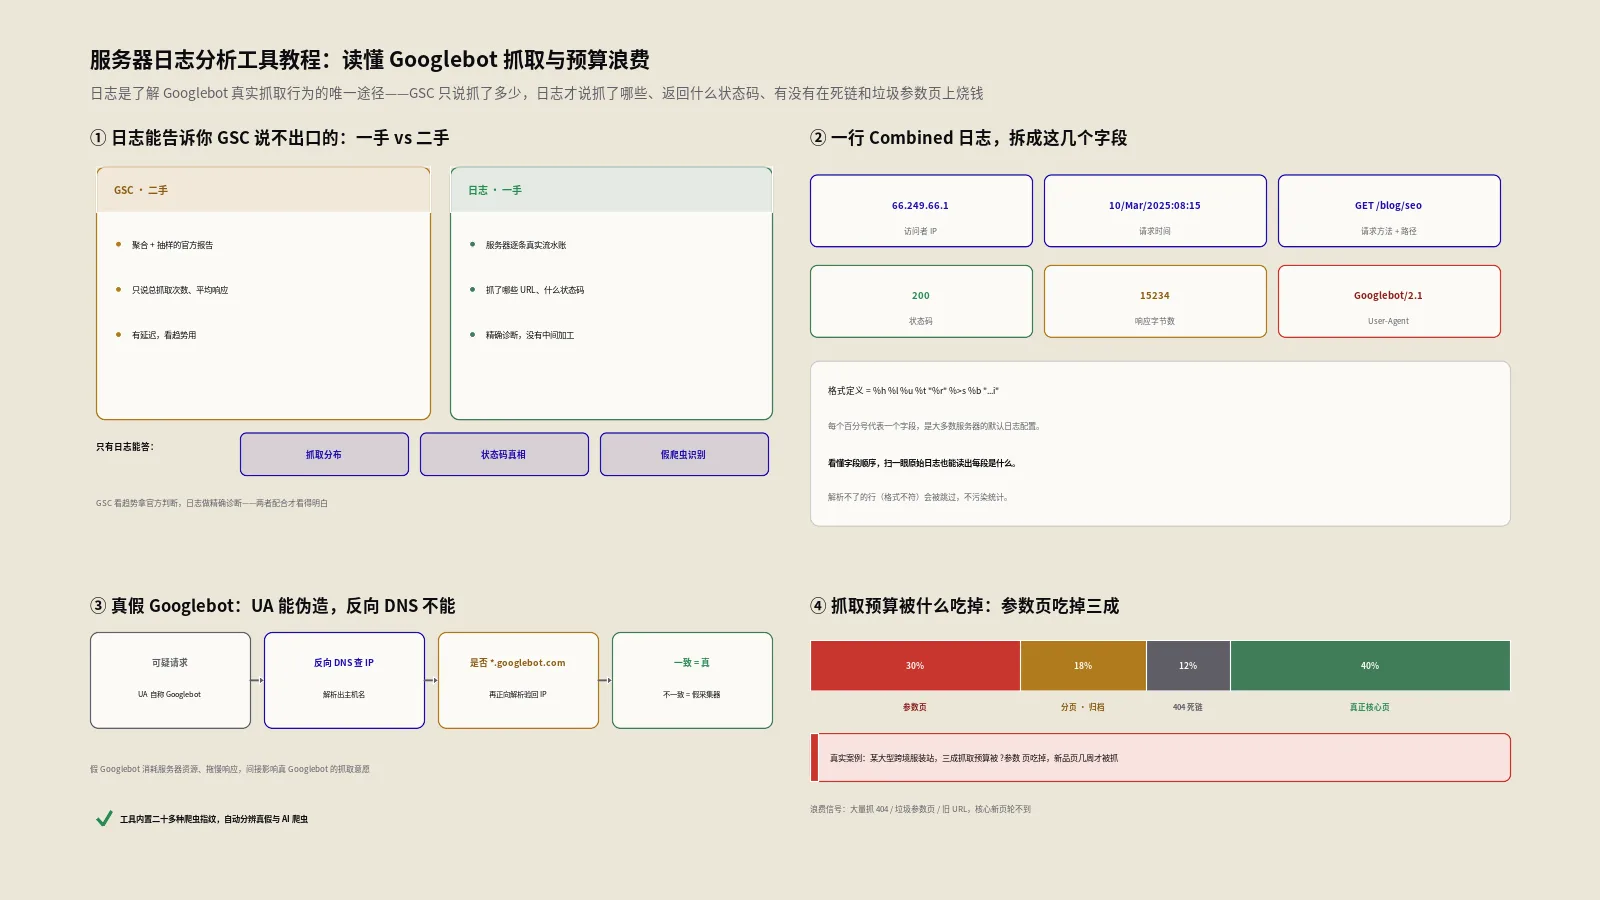
Search Console只告诉你抓了多少,日志才告诉你抓了哪些、有没有在死链和参数页上烧钱。这款工具解析爬虫日志,几分钟揪出抓取预算浪费点。